
可观测性与稳定性 / 系统课时
Request ID 为什么值得记录
Request ID 为什么值得记录
排查一次请求时,入口层、业务服务和异常处理通常会产生多条日志。如果没有共同标识,只能依赖时间和关键字猜测。记录 Request ID 可以把这些分散日志串成同一次调用链,显著缩短定位时间。
学习目标
- 说明 Request ID 为什么能把分散日志关联成一次调用
- 设计 Request ID 的生成、透传和记录边界
- 用统一字段检索入口、业务与错误日志
Request ID 解决的是关联问题
Request ID 是一次请求的关联键。它通常在请求首次进入系统时生成,之后随内部调用继续透传,并写入这次调用产生的每条关键日志。这样即使日志来自不同模块,只要字段值相同,就能按同一个请求聚合查看。
它不等同于用户 ID、会话 ID 或订单号。用户可能连续发起很多请求,同一订单也可能经历多次重试;这些业务标识无法准确表示“这一次调用”。Request ID 的粒度正好落在单次请求上。
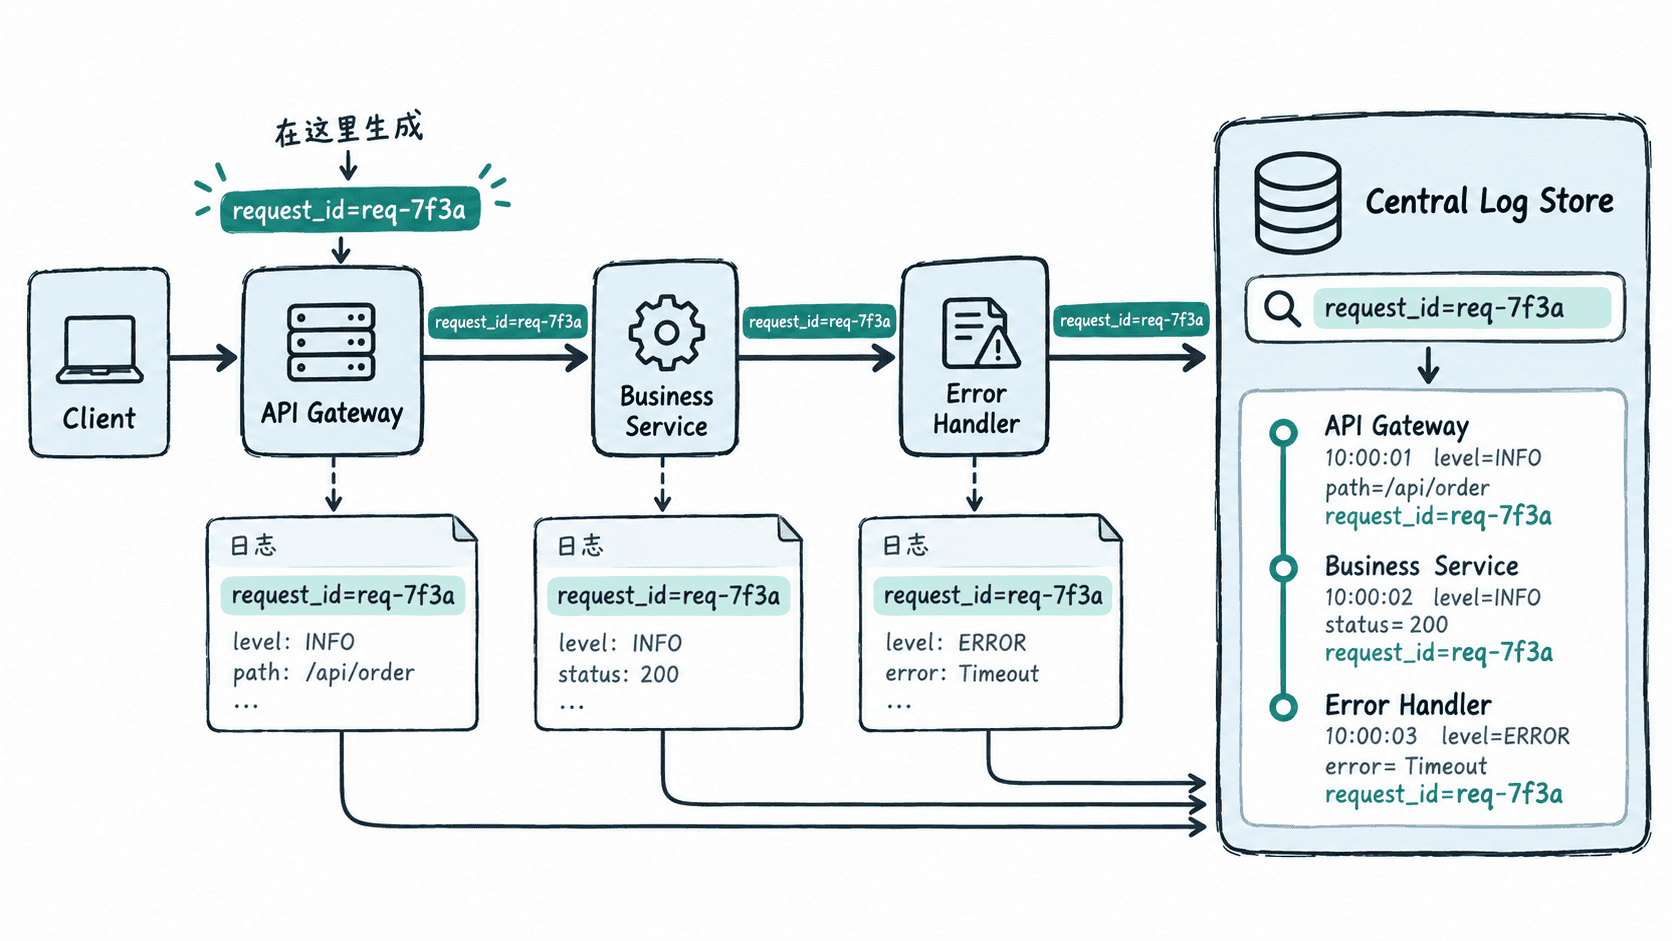
在入口生成并沿链路透传
最稳妥的做法是在可信入口统一生成 Request ID,例如反向代理、API Gateway 或应用最外层中间件。后续服务从请求头或调用上下文读取它,再继续传给下游服务。若允许客户端传入已有值,应限制长度和字符集,并在不可信时重新生成,避免把任意外部文本直接带入日志。
在结构化日志中,字段名要固定,例如统一使用 request_id。不要一部分服务写 requestId,另一部分写 rid,否则集中检索时还要兼容多套命名。
下面是同一次请求产生的三条 JSON Lines 日志示例:
{"level":"INFO","event":"request_received","request_id":"req-7f3a","path":"/orders/42"}
{"level":"INFO","event":"order_loaded","request_id":"req-7f3a","order_id":"42"}
{"level":"ERROR","event":"payment_failed","request_id":"req-7f3a","order_id":"42","error_code":"PAYMENT_TIMEOUT"}
三条记录来自不同处理阶段,但都能用 request_id = req-7f3a 过滤出来。集中日志平台的具体查询语法可能不同,关键是让字段在产生时就保持稳定且可索引。
记录时要避开的几个误区
Request ID 应该在请求上下文内保持不变,不要每写一条日志就重新生成;否则关联能力会被直接破坏。异步任务如果已经脱离原始请求,可以继续保存原 Request ID 作为来源信息,同时为新任务增加自己的任务 ID,避免把两个生命周期混成一个。
Request ID 也不是分布式追踪的完整替代品。一次请求涉及多个并行下游调用时,只有 Request ID 只能说明“属于同一次请求”,无法表达父子跨度、耗时和并行关系。此时应继续记录 Trace ID、Span ID 等追踪字段。
什么时候最有价值
线上排障时,用户通常只能提供“某次操作失败”以及大致时间。只要入口响应或错误页能安全返回 Request ID,运维人员就可以直接用这个值检索整次调用,而不必在海量日志中猜测时间窗口。对集中日志系统来说,Request ID 的成本只是一个稳定字段,却能把零散记录变成可追踪的请求上下文。