
可观测性与稳定性 / 系统课时
Index 应该怎样理解
Index 应该怎样理解
在 OpenSearch 或 Elasticsearch 中,Index 是组织和检索文档的重要边界,但不能简单把它等同于关系数据库的一张表。日志系统还要处理持续写入、数据增长和过期删除,因此通常会把 Index 与数据流、滚动创建及生命周期管理结合起来理解。
学习目标
- 理解 Index 在日志数据组织中的作用
- 区分逻辑数据流与实际保存文档的 Index
- 理解日志为什么需要滚动与生命周期管理
Index 是文档的组织边界
一篇日志文档不会孤立存在,它会写入某个 Index。Index 可以拥有自己的 Mapping、设置和底层分片,并为其中的文档提供统一的搜索边界。例如生产环境的应用日志与安全审计日志字段结构、保留周期不同,通常就不适合毫无区分地写进同一个 Index。
把 Index 类比成“文档集合”比直接类比成数据库表更稳妥。它确实承担数据组织作用,但搜索引擎还会围绕 Index 管理分片、Mapping、刷新、迁移和删除等行为。
为什么不能让一个 Index 永远增长
日志是持续产生的数据。如果数月甚至数年的日志始终写入同一个 Index,这个 Index 会不断变大,运维时很难单独迁移旧数据、调整存储成本或删除过期数据。直接删除其中大量历史文档,也通常不如按整个旧 Index 淘汰来得简单。
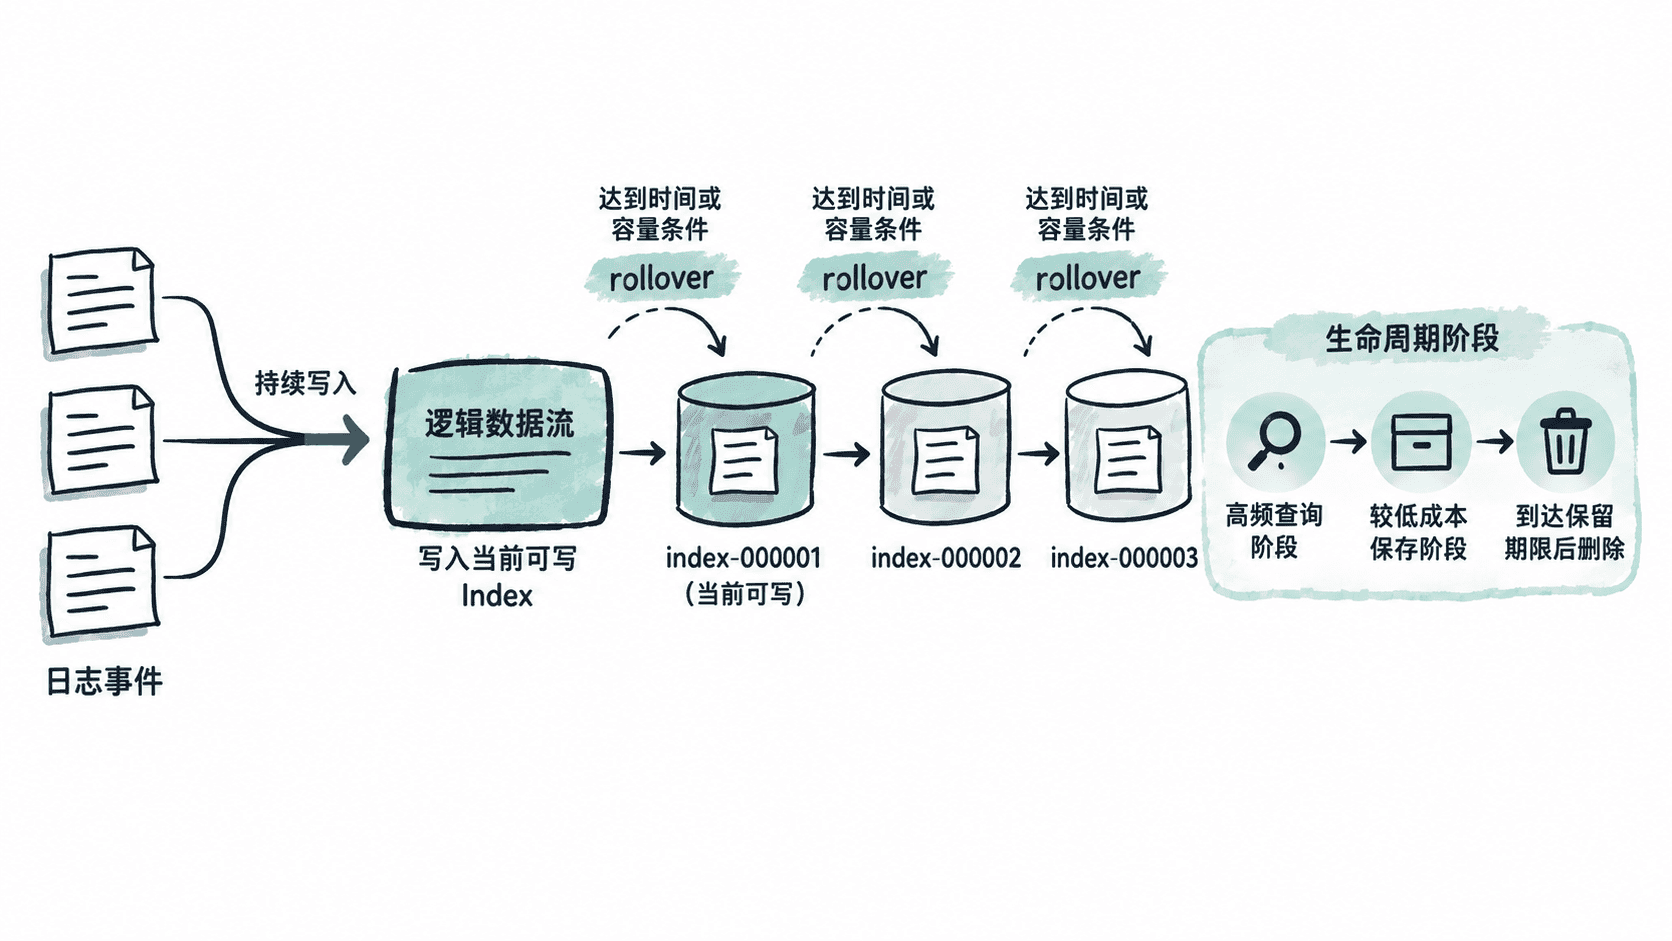
因此,日志系统常采用“持续写入当前 Index,达到条件后切换到新 Index”的方式。这个动作通常称为 rollover。旧 Index 可以继续被查询,但新的日志进入新的写入 Index。
数据流解决的是连续写入问题
现代日志场景经常使用 data stream 一类机制,把一组连续产生、字段结构相近的时序文档视为一个逻辑数据流。应用或采集器面向这个逻辑名称写入,搜索引擎在背后维护实际承载数据的多个 Index。
这样,调用方不必知道当前应该写入 000001 还是 000002。发生 rollover 后,新的 Index 接管写入,旧 Index 仍然属于同一个数据流并可参与查询。对日志这种天然带时间属性、持续追加的数据,这种方式比业务代码自行拼接每天的 Index 名称更容易管理。
生命周期解决的是数据会变旧的问题
新产生的日志通常查询频繁,数周前的日志访问次数可能明显降低,超过合规或业务保留期限的数据则可以删除。生命周期管理就是根据这些阶段自动执行相应动作。
Elasticsearch 中常见的生命周期机制是 ILM,OpenSearch 中常见的是 ISM。具体功能和配置语法并不完全相同,但核心目标一致:让 Index 根据时间、大小或策略条件进行 rollover、迁移、只读处理或删除,而不是依赖人工定期清理。
什么时候应该拆成不同的数据组织
是否放进同一组 Index,首先看数据是否拥有相近的字段结构、访问模式和生命周期。应用访问日志与审计日志即使都属于“日志”,如果前者只保留 14 天、后者需要保留 180 天,而且 Mapping 差异明显,通常应该分别管理。
环境也是常见边界。生产与测试日志采用不同的数据流或 Index,可以降低误查和误删风险,也便于配置不同的保留策略。不过也不应为每个很小的服务无限拆分 Index,否则会产生大量小 Index 和分片,反而增加集群管理成本。
理解 Index 时,可以把它看成实际承载一批文档并应用统一搜索引擎设置的存储单元;在持续增长的日志系统中,再通过数据流提供稳定的逻辑入口,通过 rollover 和生命周期策略控制这些 Index 的创建、老化与删除。