
可观测性与稳定性 / 系统课时
日志、指标和链路怎样配合
日志、指标和链路怎样配合
线上故障通常不能只靠一种可观测数据定位。指标能快速告诉你“哪里异常了”,日志能还原某个时间点发生的事件,而 Trace 能把一次请求经过的多个服务串起来。把三者通过时间、服务名和请求标识关联起来,排障速度会明显提高。
学习目标
- 区分日志、指标和 Trace 最擅长回答的问题
- 理解从指标告警到日志再到调用链的典型排查顺序
- 使用请求标识或 Trace ID 在不同观测数据之间建立关联
三种数据回答不同的问题
指标是经过聚合的数值序列,例如每秒请求数、错误率、CPU 使用率和响应时间分位数。它体积相对可控,适合持续监控趋势、设置阈值和快速发现异常,但通常不能告诉你某一次请求具体为什么失败。
日志保存离散事件及其上下文,例如异常类型、订单号、请求路径和业务处理结果。它适合回答“当时发生了什么”,但在大量服务和海量日志中,如果没有明确的时间范围和关联标识,搜索成本会很高。
Trace 把一次请求拆成多个 Span,并记录服务之间的调用关系和耗时。它最适合回答“请求经过了哪些服务”“时间消耗在哪里”“哪个下游调用首先出错”。
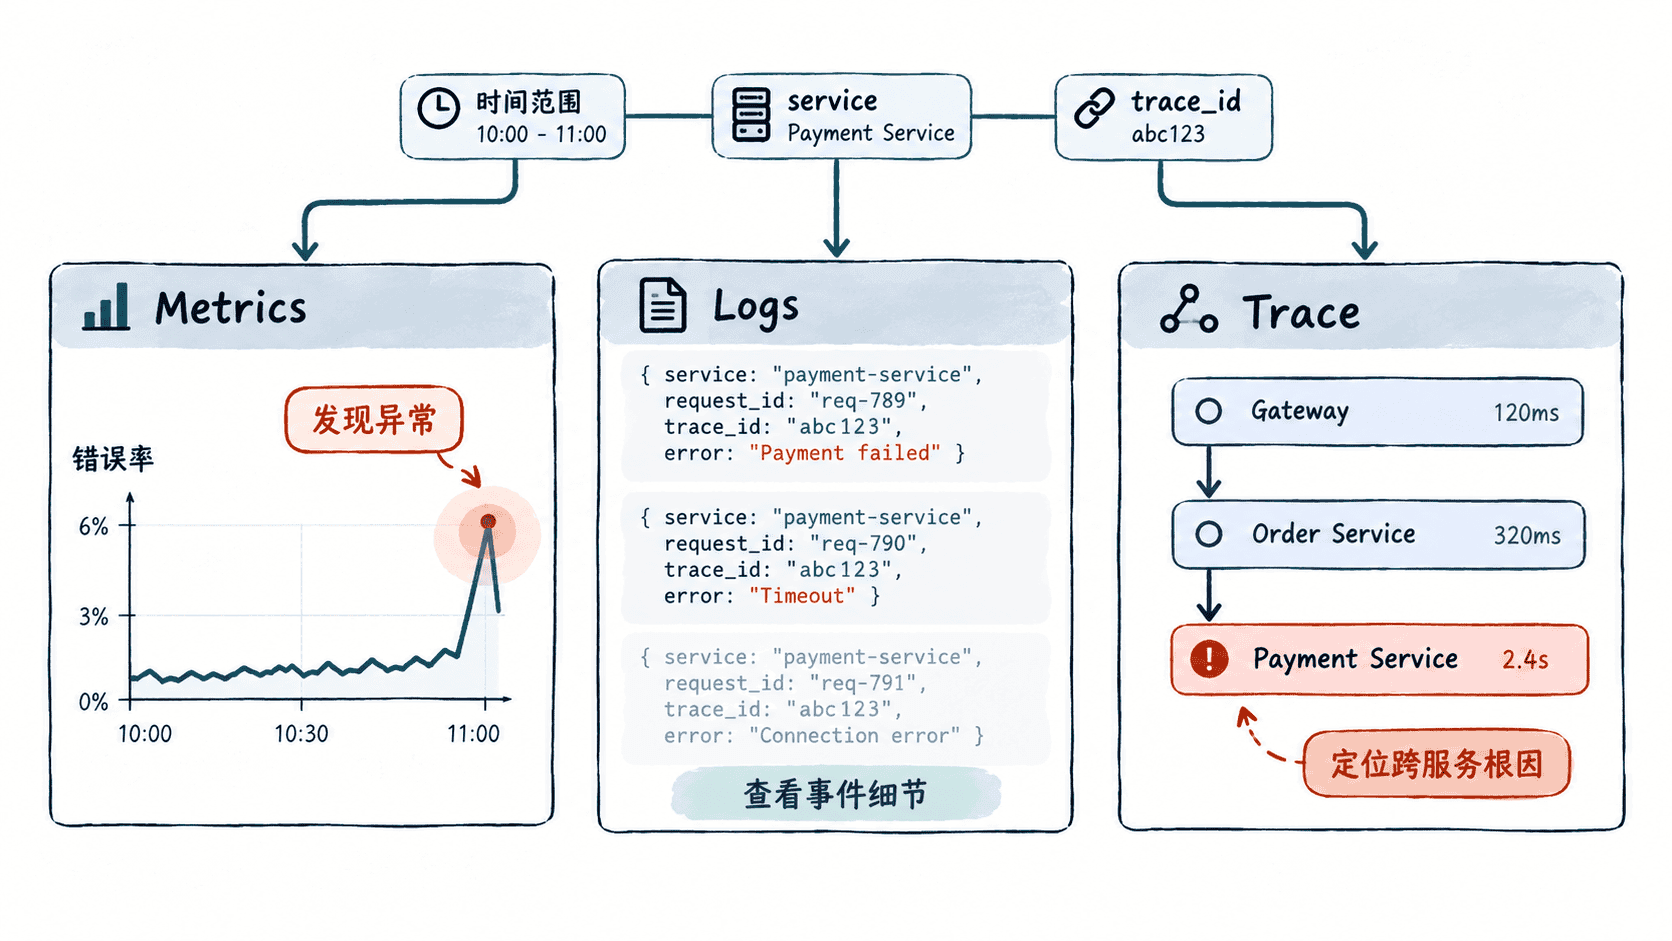
排障通常从低成本信号逐步深入
假设支付接口的错误率突然从正常水平升高。更有效的定位顺序通常不是先浏览所有日志,而是先用指标确认异常的时间范围、服务和维度,再查询这段时间内的错误日志。如果日志里带有 Trace ID,就继续打开对应调用链,判断错误发生在当前服务还是下游依赖。
这个过程可以概括为:指标缩小范围,日志解释事件,Trace 还原跨服务路径。三者不是彼此替代,而是把不同粒度的信息拼在一起。
用关联标识把数据串起来
集中日志中最有价值的字段之一是请求关联标识。下面的可执行 Bash 示例模拟三条日志,并根据同一个 Trace ID 找出属于同一次请求的事件:
TRACE_ID="7f3a42"
printf '%s\n' \
  'service=gateway trace_id=7f3a42 status=502 message="upstream failed"' \
  'service=order trace_id=7f3a42 status=500 message="payment call failed"' \
  'service=payment trace_id=7f3a42 status=500 message="database timeout"' \
  'service=gateway trace_id=91bc10 status=200 message="request completed"' |
grep "trace_id=${TRACE_ID}"
预期输出
service=gateway trace_id=7f3a42 status=502 message="upstream failed"
service=order trace_id=7f3a42 status=500 message="payment call failed"
service=payment trace_id=7f3a42 status=500 message="database timeout"
真实系统中通常会把 trace_id、span_id、service.name、请求 ID 等字段写入结构化日志。这样从日志检索到某个 Trace ID 后,就可以跳转到链路系统查看 Span;反过来,从异常 Span 也可以使用同一标识检索对应日志。
什么时候优先看哪一种数据
当问题是“服务现在是否健康”“错误率是否上升”“延迟从什么时候开始恶化”时,优先看指标。当已经知道异常时间和服务,需要确认具体异常、参数或业务状态时,进入日志。当请求跨越多个服务,或者需要分析调用顺序、依赖关系和各阶段耗时时,再查看 Trace。
最有效的可观测体系不是分别保存三份数据,而是在采集阶段保留一致的时间戳、服务标识和 Trace 上下文。这样一次故障才能从宏观异常逐步收敛到具体事件和具体调用节点,而不是在三个互不关联的系统里重复搜索。