
可观测性与稳定性 / 系统课时
Java 异常栈为什么会被拆成很多条
Java 异常栈为什么会被拆成很多条
Java 异常通常由一条异常头和多行 at、Caused by、Suppressed 组成。如果采集器默认把每一行都当成独立事件,一次异常就会变成许多日志文档。本节用多行规则重新定义事件边界,让完整 Stack Trace 作为一条日志进入后续检索系统。
学习目标
- 解释 Java Stack Trace 被拆成多条日志的根本原因
- 使用续行特征配置多行合并规则
- 验证合并结果,并识别可能误合并的边界
问题出在日志事件边界
Java 并没有把一次异常写成多条独立业务事件,只是 Stack Trace 本身包含换行。真正导致拆分的是采集器采用了“一行就是一个事件”的默认边界。
例如,应用文件中可能连续出现以下内容:
2026-09-17 12:00:03.101 ERROR checkout.PaymentService - payment failed
java.lang.IllegalStateException: stock unavailable
    at checkout.StockClient.reserve(StockClient.java:42)
    at checkout.PaymentService.pay(PaymentService.java:87)
Caused by: java.net.SocketTimeoutException: Read timed out
    at java.net.SocketInputStream.socketRead0(Native Method)
2026-09-17 12:00:04.220 INFO checkout.PaymentService - retry scheduled
按行采集时,这段内容可能被写成七个事件。查询某次异常时,异常类型、调用栈和根因分散在不同文档中,按 request_id 聚合也无法恢复原始异常结构。
正确的边界应是:带日期时间等日志前缀的行开始一个新事件,属于异常栈的后续行继续追加到前一个事件。
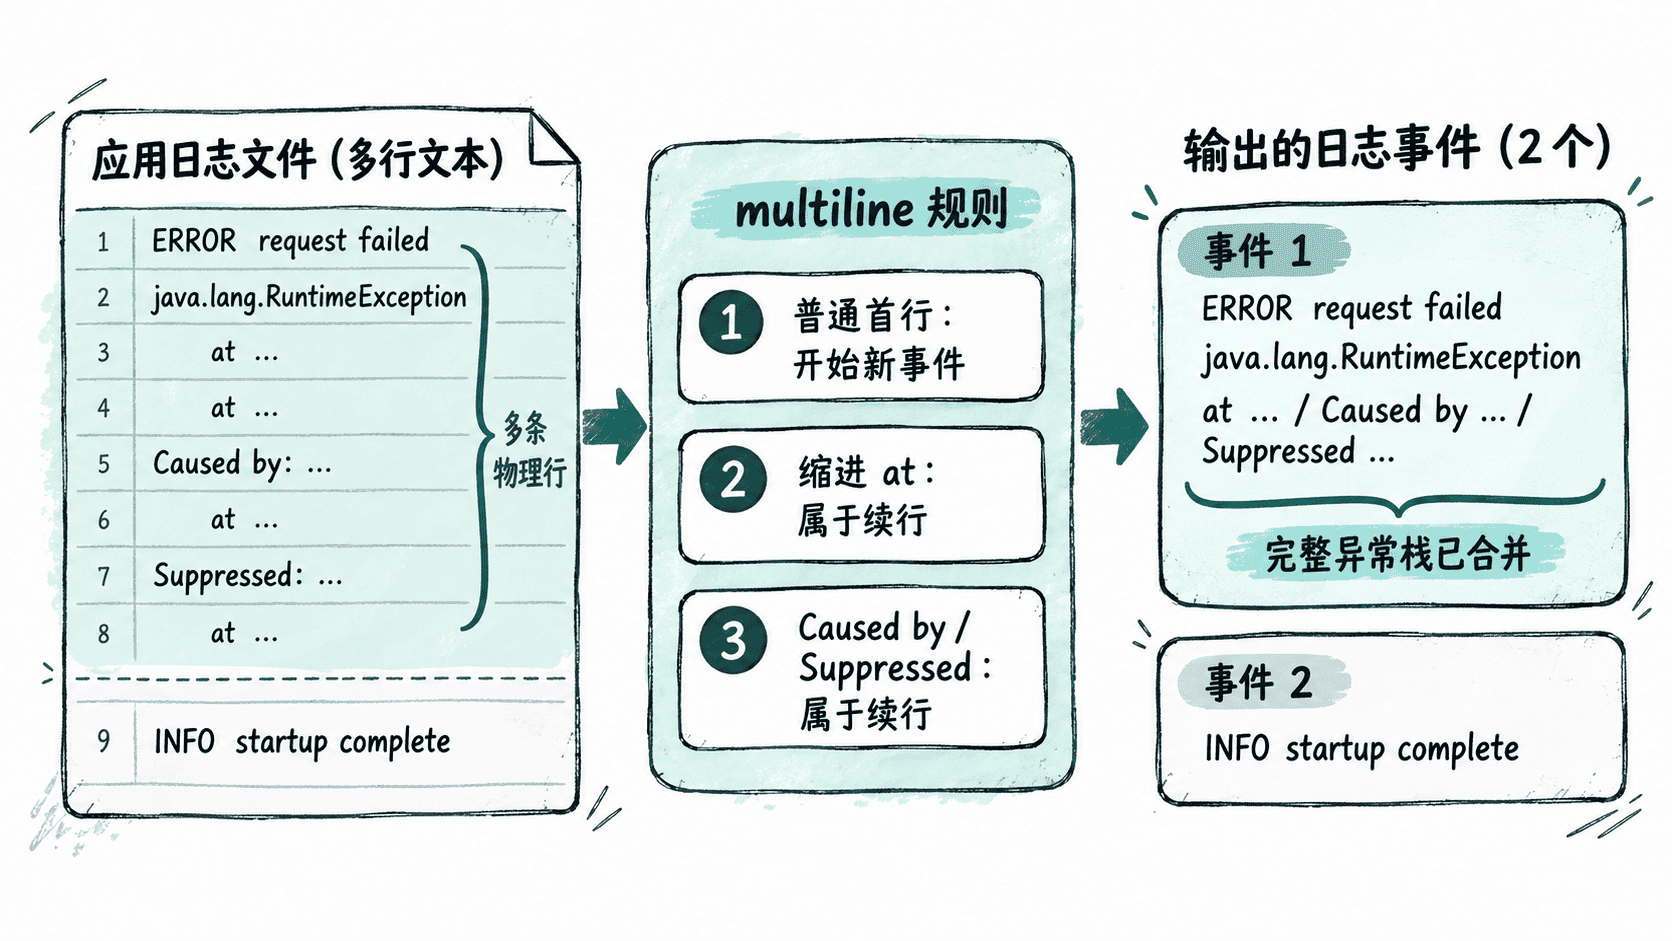
用多行规则识别异常续行
一种稳妥做法不是只匹配 at,而是把 Java Stack Trace 中常见的续行都覆盖进去:缩进行、Caused by: 和 Suppressed:。下面给出 Filebeat filestream 输入的完整最小配置示例。
filebeat.inputs:
  - type: filestream
    id: java-stack-demo
    enabled: true
    paths:
      - /tmp/java-stack-demo/app.log
    parsers:
      - multiline:
          type: pattern
          pattern: '^[[:space:]]|^Caused by:|^Suppressed:'
          negate: false
          match: after

output.console:
  pretty: true
这条规则的含义是:当前行如果以空白字符开头,或者以 Caused by:、Suppressed: 开头,就把它追加到前一个事件。下一条正常日志首行不满足规则,因此自然开始新的事件。
验证配置和合并结果
保存为 filebeat.yml 后,可以先验证配置语法。以下命令要求本机已经安装对应版本的 Filebeat。
filebeat test config -c filebeat.yml预期输出
Config OK配置检查成功只说明 YAML 和 Filebeat 配置可以解析,并不能证明事件边界正确。实际验证时,应把前面的异常样例写入 /tmp/java-stack-demo/app.log,让输出指向控制台,然后检查异常头、at 行和 Caused by: 是否出现在同一个事件的 message 中,同时确认后面的 INFO 日志已经成为下一条事件。
理想情况下,第一个事件的消息应保持完整的多行结构:
2026-09-17 12:00:03.101 ERROR checkout.PaymentService - payment failed
java.lang.IllegalStateException: stock unavailable
    at checkout.StockClient.reserve(StockClient.java:42)
    at checkout.PaymentService.pay(PaymentService.java:87)
Caused by: java.net.SocketTimeoutException: Read timed out
    at java.net.SocketInputStream.socketRead0(Native Method)
什么时候要重新设计规则
如果应用同时输出 Java 栈、JSON 日志和没有固定前缀的普通文本,仅靠一条宽泛的 multiline 正则很容易出现误合并。此时应优先统一应用日志格式,或者为不同文件、不同输入配置独立规则。
还要特别关注超长异常。循环异常、巨大嵌套调用栈会让单个事件异常膨胀,因此生产环境需要结合当前采集器版本检查多行事件的行数、大小和超时限制。多行合并的目标不是“尽可能多地拼接”,而是让一个真实异常恰好对应一个日志事件。