
可观测性与稳定性 / 系统课时
Shard 为什么要拆分数据
Shard 为什么要拆分数据
当日志不断写入同一个索引时,单个节点的磁盘、CPU 和查询能力都会形成上限。Shard 的作用不是简单地“把文件切小”,而是把一个逻辑索引拆成可独立存储和处理的数据分区,让写入、检索和容量能够分散到多个节点。
学习目标
- 理解 Primary Shard 如何承载并拆分索引中的文档
- 说明分片为什么能够帮助索引突破单节点容量和吞吐限制
- 识别分片数量过多带来的资源与管理成本
一个索引为什么需要多个 Shard
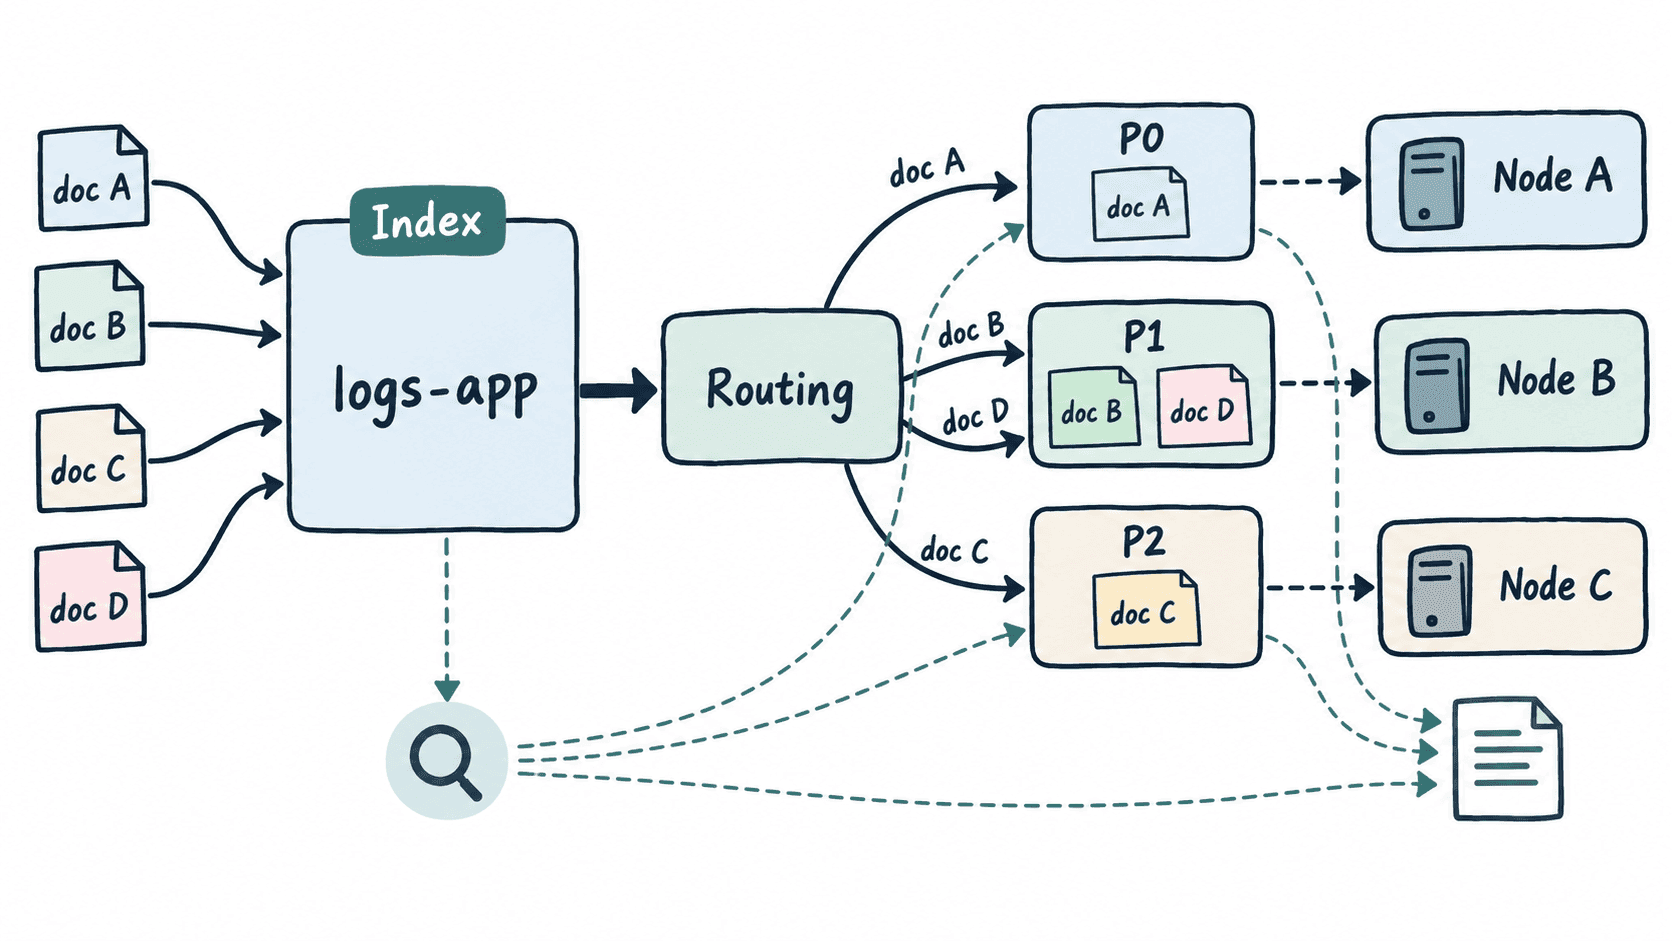
对应用来说,索引仍然是一个整体。例如日志程序只需要把文档写入 logs-app,查询时也直接搜索这个索引。但搜索引擎在内部可以把它拆成多个 Primary Shard,每个分片只保存其中一部分文档。
假设 logs-app 有 3 个 Primary Shard,新日志进入后会根据路由规则确定目标分片。文档不会同时存进所有 Primary Shard,而是由其中一个负责保存。查询整个索引时,协调节点再把请求分发到相关分片,并汇总各分片返回的结果。
拆分后获得什么能力
最直接的收益是容量可以横向分布。如果一个索引的数据量已经超过单台机器适合承载的范围,多个 Primary Shard 可以被安排到不同节点,各自使用本地磁盘保存一部分数据。
第二个收益是工作可以并行执行。写入会落到不同 Primary Shard,查询整个索引时多个分片也可以并行搜索。对于持续产生大量日志的场景,这为增加节点后继续扩展吞吐提供了基础。
但 Shard 并不保证“数量越多性能越高”。一次跨多个分片的搜索需要把请求发送给多个执行单元,再汇总结果;如果每个分片都很小,额外调度成本可能超过并行带来的收益。
Primary Shard 是独立的存储与执行单元
理解 Shard 时,可以把逻辑索引和物理执行单元分开看。索引负责向应用提供统一名称和映射规则,Primary Shard 才是真正保存文档、建立倒排索引并参与搜索的基本单元之一。
因此,分片规划实际上决定了数据以后怎样分布。Primary Shard 太少,单个分片可能持续膨胀,使节点迁移、恢复和查询压力集中;Primary Shard 太多,则会产生大量细碎分片,占用更多文件句柄、内存和集群管理资源。
为什么不能为了扩展性无限增加分片
每个 Shard 都不是零成本容器。它需要维护自身的索引结构、段文件、缓存和运行状态,集群还要记录分片位于哪个节点以及当前是否正常。大量小分片会放大这些固定成本。
例如,同样的数据量可以由少量较大的分片承载,也可以被切成大量很小的分片。后者虽然看起来更“并行”,但一次查询可能需要协调更多分片,节点也要维护更多资源对象,故障恢复和重新分配时的调度工作随之增加。
因此,设计日志索引时应先估计数据增长速度、保留周期、节点容量和查询压力,再决定合理的 Primary Shard 数量。Shard 的核心价值是让数据能够分布,而不是把索引切得越碎越好。