
可观测性与稳定性 / 系统课时
设计第一条集中日志链路
设计第一条集中日志链路
这一节把 Web 应用的一条日志从产生到被检索的全过程串起来。目标不是先堆组件,而是确定每一段承担什么职责、传递哪些字段,以及怎样判断整条链路已经真正可用。
学习目标
- 说清日志产生、采集、解析、索引和查询五个环节的职责
- 为第一条集中日志链路确定最小字段集合和数据流向
- 用可验证的检查点判断日志是否在某一环节丢失或失真
从查询需求反推链路
设计集中日志时,先问“最终要查什么”,比先决定安装哪个组件更有效。假设 Web 应用出现接口延迟,需要按时间、服务名、请求路径、状态码和请求 ID 定位问题,那么这些信息必须在日志产生时就存在,并在后续环节中保持可查询。
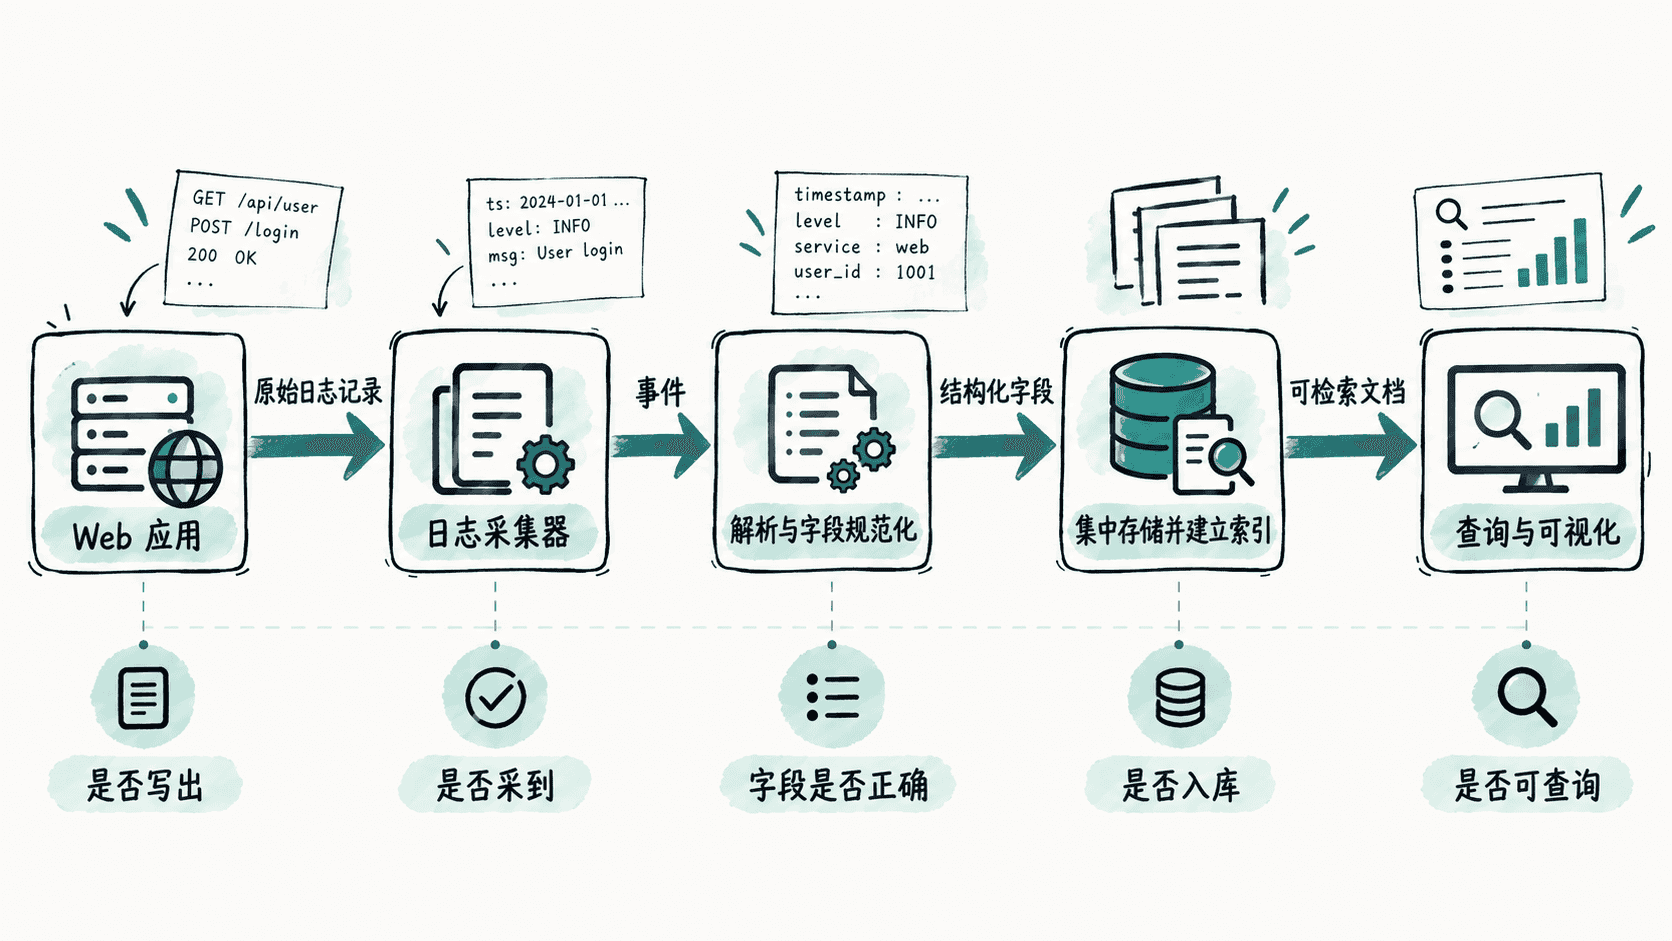
一条最小链路可以拆成五段:应用产生日志,采集器读取新增记录,处理环节解析字段,存储系统建立可检索索引,查询端按字段过滤和聚合。每一段都应尽量只承担一种主要职责。
先定义事件再选择工具
为了让后续解析和查询稳定,先约定一条日志事件至少包含时间、服务、级别、消息以及用于关联请求的标识。下面是一条适合进入集中日志平台的结构化事件示例:
{"timestamp":"2026-09-17T04:30:00Z","service":"web-api","level":"ERROR","request_id":"req-7f2a","method":"GET","path":"/orders/42","status":500,"message":"failed to load order"}这里最重要的不是字段名称必须完全相同,而是语义稳定。例如 status 应始终表示 HTTP 状态码,不要有时写数字、有时写成 server_error。时间字段也应采用统一格式并明确时区,否则跨服务器排序很容易产生误判。
给每一段定义清晰职责
日志产生端负责记录有诊断价值的事实,不应依赖采集器猜测业务含义。采集器负责持续读取、记录读取位置和转发事件,避免因为进程重启反复发送整份文件。
解析环节把原始内容转换为稳定字段,并处理类型转换、字段重命名等规则。存储端负责持久化和建立适合检索的索引;查询端再利用这些字段执行过滤、聚合和可视化,而不是重新解释原始文本。
用检查点定位链路故障
第一条链路不需要一开始就追求高可用和复杂路由,但必须能逐段验证。测试时先触发一条带唯一 request_id 的请求,然后沿数据流检查:应用日志文件中是否出现该记录,采集端是否读取,解析后的字段和值是否正确,存储中是否存在对应文档,查询端能否按这个 ID 精确找到它。
如果查询不到,不要直接修改查询语句。先从最近的数据入口逐段检查,这样可以把“日志没产生”“采集没读到”“解析失败”“写入失败”和“查询条件错误”区分开来。
第一条链路的验收标准
可用的最小集中日志链路至少满足三个条件:新日志能够持续进入集中存储;时间、服务、级别和请求标识等关键字段可以单独查询;使用一个已知请求 ID 能从应用侧记录一路追踪到最终查询结果。
做到这一步后,再增加缓冲队列、数据保留策略、多副本或告警会更稳妥。集中日志平台的起点不是组件数量,而是一条能够完整传递、解释并验证日志事件的数据链路。