
可观测性与稳定性 / 系统课时
磁盘使用率过高应该怎么处理
磁盘使用率过高应该怎么处理
日志集群磁盘告警出现后,最危险的动作是直接进入数据目录删除文件。搜索引擎需要依靠分片、段文件和集群元数据保持一致,绕过 API 删除文件可能把一次容量问题变成分片损坏或无法恢复。本篇给出从确认压力来源到释放空间、恢复写入的处理顺序。
学习目标
- 按节点磁盘、索引增长、生命周期和副本配置定位容量压力
- 使用受支持的索引与生命周期 API 释放空间,而不是手工删除数据目录
- 修复后验证磁盘、分片分配和写入状态是否恢复正常
先判断是哪一类磁盘压力
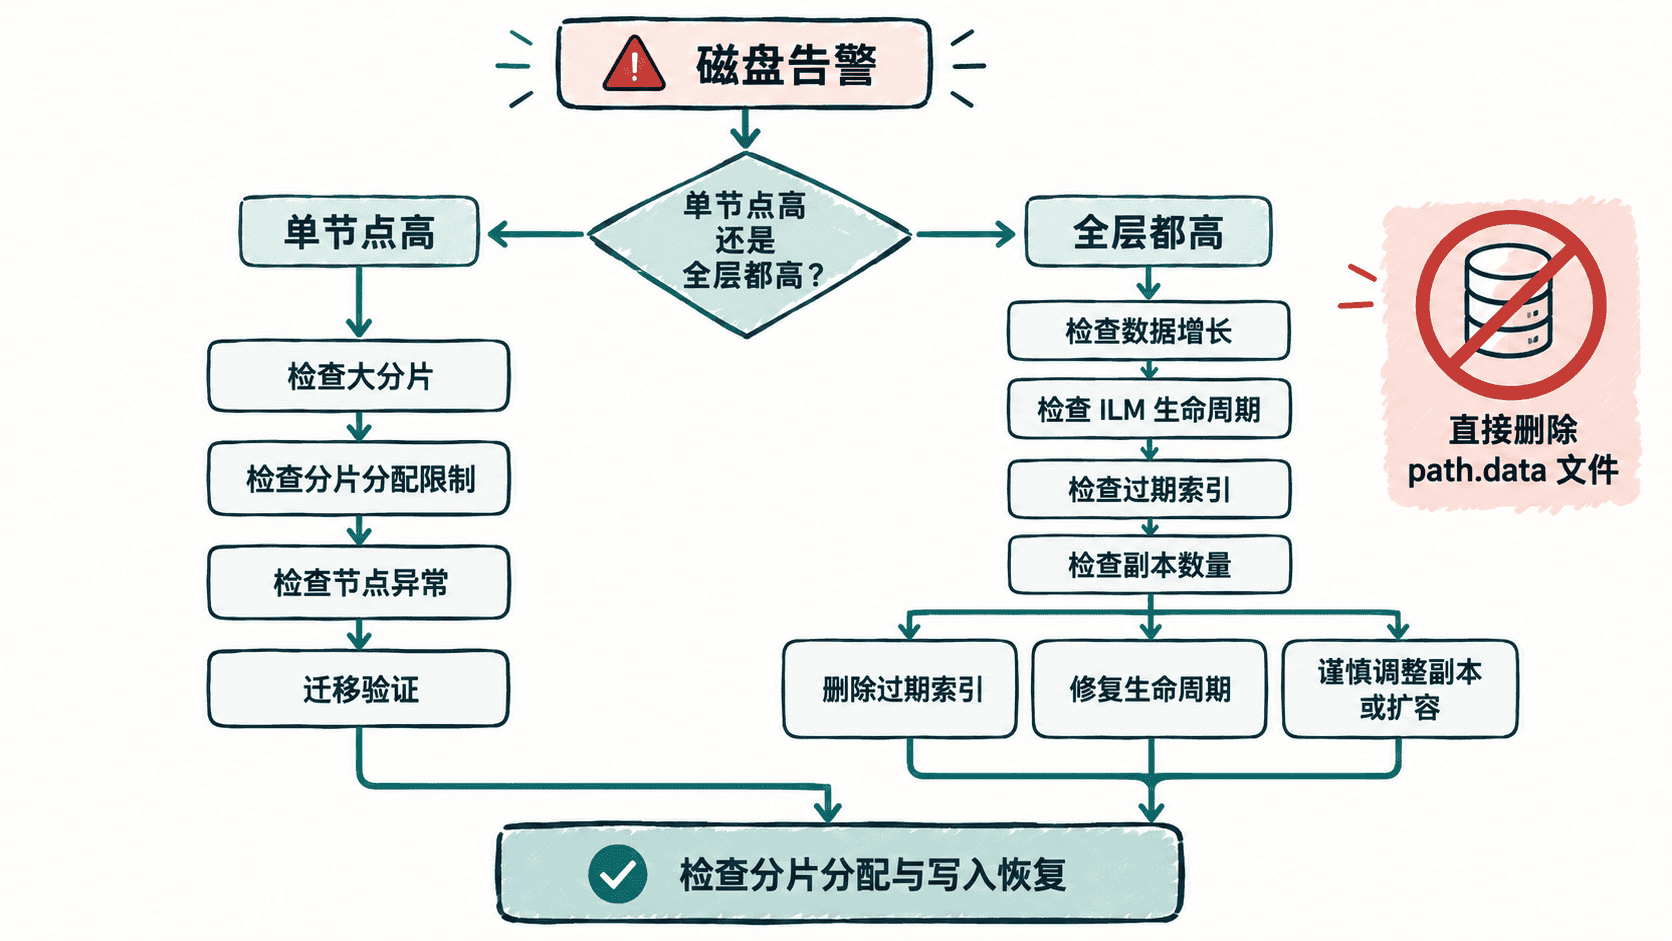
先区分“单个节点被打满”还是“整个数据层都接近容量上限”。前者可能来自分片分布不均、热点索引或节点异常;后者更可能是日志增长超过预估、保留时间过长、生命周期没有执行,或者副本数量放大了存储需求。
先查看各节点的磁盘占用。将 <PORT> 替换为实际 HTTP 端口;其余尖括号字段表示实际环境中的动态值。
curl -s "http://localhost:<PORT>/_cat/allocation?v&h=node,shards,disk.indices,disk.used,disk.avail,disk.total,disk.percent&s=disk.percent:desc"预期输出(数值会随环境变化):
node   shards disk.indices disk.used disk.avail disk.total disk.percent
<HOST> <ID>   <SIZE>       <SIZE>    <SIZE>     <SIZE>     <ID>
如果只有一个节点明显偏高,优先检查该节点承载了哪些大分片以及为什么没有迁移;如果所有节点都高,就继续检查索引增长和保留策略,单纯等待自动迁移通常解决不了总容量不足。
找出空间被谁占用
节点层面确认后,再按索引大小排序。这样可以快速识别突然增长的日志源、保留时间过长的历史索引,以及体积异常的大索引。
curl -s "http://localhost:<PORT>/_cat/indices?v&s=store.size:desc&h=health,status,index,pri,rep,docs.count,store.size,pri.store.size"预期输出(索引名和大小取决于实际集群):
health status index                  pri rep docs.count store.size pri.store.size
<STATUS> open   <INDEX>              <ID> <ID> <ID>       <SIZE>     <SIZE>
<STATUS> open   <INDEX>              <ID> <ID> <ID>       <SIZE>     <SIZE>
重点比较近期索引的增长速度与历史基线。如果“每天新增的数据量”变大,应先查采集量、重复日志和异常字段膨胀;如果旧索引一直不退出,则应检查生命周期策略是否绑定、是否卡在某个阶段,以及删除阶段是否符合实际保留期。
对使用 ILM 的索引,可以直接查看某个索引当前是否受生命周期管理以及停留的阶段。将示例索引名替换为真实目标。
curl -s "http://localhost:<PORT>/logs-app-000001/_ilm/explain?filter_path=indices.*.index,indices.*.managed,indices.*.phase,indices.*.action,indices.*.step"预期输出(阶段名称取决于策略和索引当前状态):
{"indices":{"logs-app-000001":{"index":"logs-app-000001","managed":<MANAGED>,"phase":"<PHASE>","action":"<ACTION>","step":"<STEP>"}}}如果 managed 为 false,应先检查索引或数据流是否绑定了正确的生命周期策略;如果长期停在同一个 phase、action 或 step,再针对该步骤继续排查,而不是直接删除底层文件。
按风险从低到高释放空间
优先处理已经超过保留期、确认不再需要的完整索引。删除前应确认合规要求、快照或其他归档副本是否满足恢复需求;删除时使用搜索引擎提供的 Delete Index API,让集群正确更新元数据和分片状态。
下面示例删除一个已经确认可淘汰的历史索引。索引名必须替换成经过核对的真实目标,不要使用未经确认的通配符。
curl -s -X DELETE "http://localhost:<PORT>/logs-app-2026.08.01"预期输出:
{"acknowledged":true}如果问题来自生命周期没有执行,应先修复策略或索引绑定,而不是持续人工删索引。若副本数量明显高于当前可用性需求,也可以在明确接受冗余下降的前提下临时减少副本;这属于容量应急手段,不应替代扩容和正确的保留策略。
当保留策略已经合理,但持续写入仍会很快再次触顶时,应增加数据节点或磁盘容量。提高磁盘水位阈值只能改变保护机制触发时机,不能创造真实空间,因此不应作为长期扩容方案。
不要删除数据目录里的文件
path.data 下的文件由搜索引擎管理,文件名和目录结构并不等价于“某个索引的完整数据”。手工执行 rm 删除段文件、translog 或分片目录,会绕开集群元数据与恢复机制,可能造成分片损坏、主副本不一致,甚至让节点无法正常加入集群。
正确做法是通过索引删除、生命周期、快照恢复、分片迁移和节点扩容等受支持机制处理空间。即使磁盘已经非常紧张,也应先释放可控空间或扩容,再让集群完成自己的分配与恢复流程。
修复后验证三个信号
释放空间后再次查看节点磁盘,确认高占用节点已经下降;随后检查集群健康和分片状态,确保没有持续增加的未分配分片;最后执行一条小规模日志写入或等待正常采集流量,确认目标索引能够继续写入。
curl -s "http://localhost:<PORT>/_cluster/health?filter_path=status,unassigned_shards,active_shards_percent_as_number"预期输出(具体状态取决于副本和节点情况):
{"status":"<STATUS>","unassigned_shards":<ID>,"active_shards_percent_as_number":<ID>}只有当磁盘使用率回到安全范围、分片分配稳定、日志写入恢复,并且容量趋势不会在短时间内再次触顶,才算真正解决了问题;否则只是把告警暂时清掉。