
可观测性与稳定性 / 系统课时
绘制日志总量时间趋势
绘制日志总量时间趋势
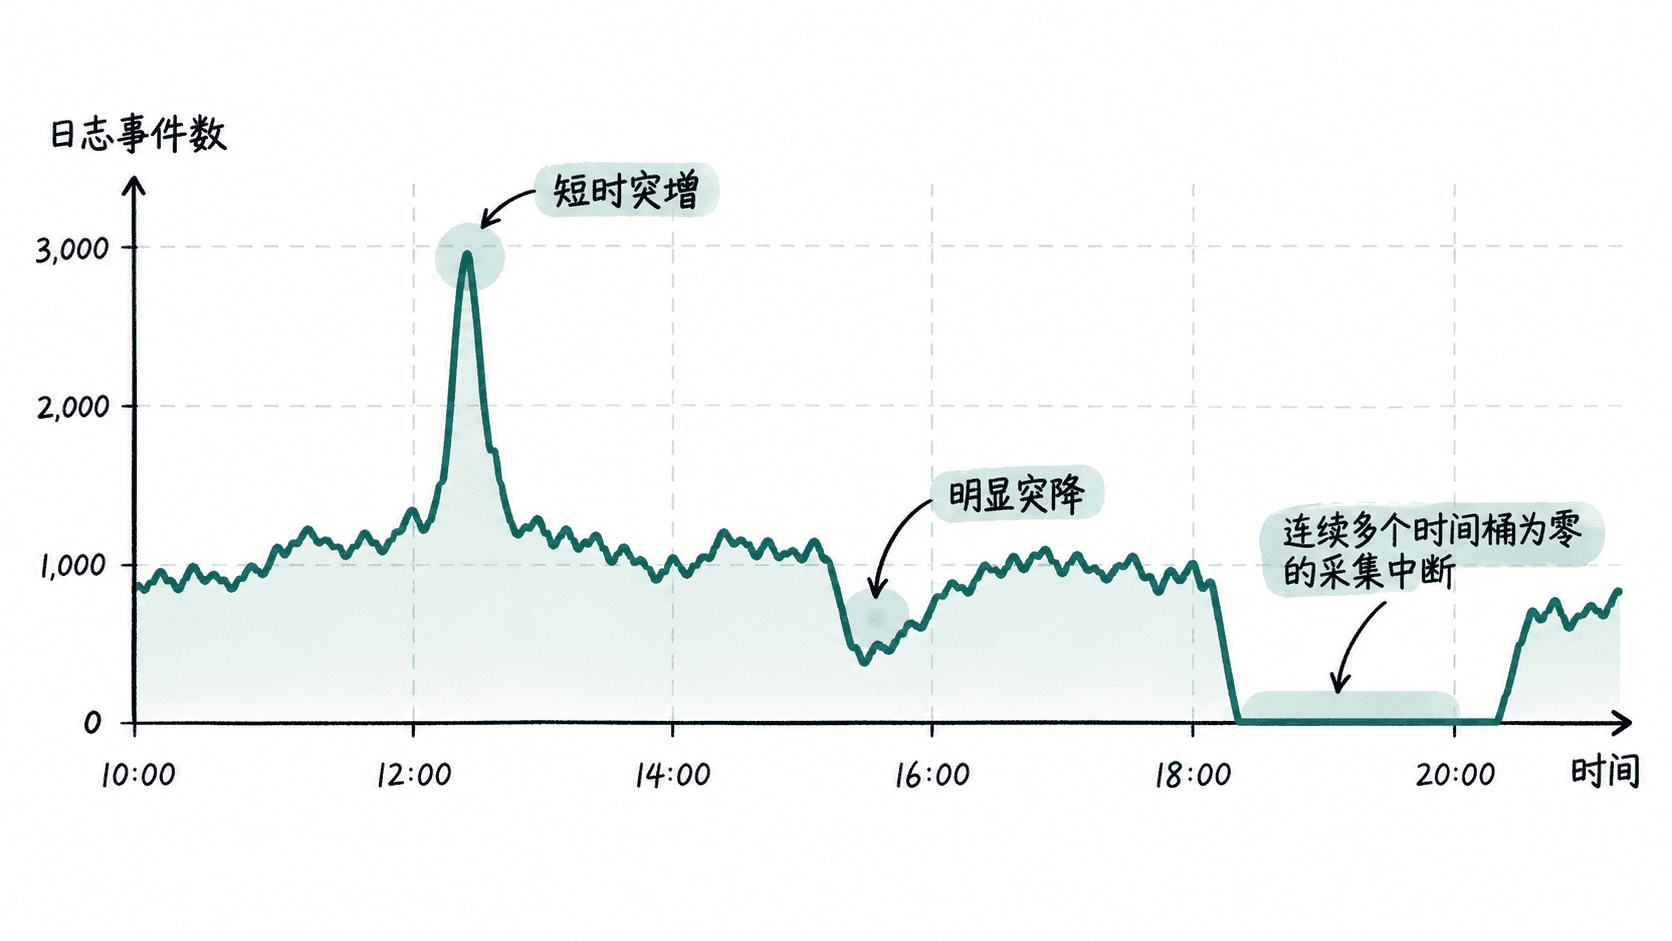
日志总量时间趋势是集中日志 Dashboard 最基础的健康信号。把事件按固定时间桶聚合后,可以识别流量突增、异常突降和采集中断;关键不只是画线,还要保证时间范围、桶宽与空桶处理一致。
学习目标
- 使用固定时间桶统计日志事件数量
- 根据观察窗口选择合适的时间粒度
- 从突增、突降和连续零值中识别不同问题
时间趋势的核心是分桶计数
趋势图的横轴是时间桶,纵轴是每个桶内的日志事件数。观察最近一小时可以使用 5 分钟桶,观察一天则可以使用更大的桶宽。桶太小会让随机波动看起来像故障,桶太大又会掩盖短暂异常。
为了识别采集中断,查询还应保留没有日志的空桶。否则“这一段没有数据”会在图上直接消失,值班人员可能把采集故障误认为业务平稳。
用聚合查询生成时间序列
下面示例面向 Elasticsearch 兼容接口,把最近一小时的 logs-* 日志按 5 分钟聚合。extended_bounds 与 min_doc_count: 0 用来保留查询窗口中的空桶。执行前将 <HOST> 和 <PORT> 替换为实际地址与端口。
curl -sS -w ' HTTP_STATUS=%{http_code}' -H 'Content-Type: application/json' -X POST 'http://<HOST>:<PORT>/logs-*/_search?filter_path=aggregations.events_over_time.buckets' -d '{"size":0,"query":{"range":{"@timestamp":{"gte":"now-1h","lte":"now"}}},"aggs":{"events_over_time":{"date_histogram":{"field":"@timestamp","fixed_interval":"5m","min_doc_count":0,"extended_bounds":{"min":"now-1h","max":"now"}}}}}'预期输出
{"aggregations":{"events_over_time":{"buckets":[{"key_as_string":"<TIME>","key":<ID>,"doc_count":<COUNT>},...]}}} HTTP_STATUS=200<TIME>、<ID> 与 <COUNT> 会随数据和执行时间变化。Dashboard 只需把 key_as_string 作为时间轴、doc_count 作为数值序列即可绘制趋势。
从曲线形态判断问题方向
突增不一定是故障,它也可能来自流量增长、重试风暴或某段代码开始重复打印日志;应继续对同一时间段按服务和级别拆分。突降则要同时检查业务流量和采集链路,避免把“日志变少”直接等同于“服务恢复”。
连续多个桶为零尤其值得关注。如果业务本应持续有请求,零值更像采集器停止、网络中断、索引写入失败或时间字段异常。此时应先验证采集链路,而不是只搜索应用错误。
让趋势图可长期使用
趋势面板应固定统计口径,例如统一使用事件条数,不要一会儿统计日志行、一会儿统计去重请求。时间范围变化时,桶宽也要随之调整,确保每张图既有足够细节,又不会产生过多桶。
当总量趋势发现异常后,再用服务、环境、日志级别等维度做第二层拆分。这样主图保持稳定、易读,细节分析则通过筛选或下钻完成。