
可观测性与稳定性 / 系统课时
为什么 grep 日志越来越难用
为什么 grep 日志越来越难用
当系统只有一台服务器时,登录主机后执行 grep 往往足够快;一旦请求跨过多台机器、多个实例和多个微服务,同一次故障的证据就会散落在不同文件里。本课用一个跨服务请求说明这种方式为什么失效,以及集中日志要解决的核心问题。
学习目标
- 识别人工登录服务器检索日志在多实例环境中的主要瓶颈
- 理解
trace_id只能关联日志,不能替代集中采集与统一检索 - 判断什么情况下应从临时
grep过渡到集中日志平台
单机 grep 为什么曾经有效
在单机应用中,日志的位置、进程和时间范围通常都很明确。已知错误关键字后,直接在本地文件中查找即可,定位路径很短:找到文件、过滤关键字、查看上下文。
下面用三个文件模拟网关、订单服务和支付服务产生的同一次请求日志。示例可直接在 Linux 或 macOS Shell 中运行。
tmpdir="$(mktemp -d)"
printf '%s\n' '2026-09-17T10:00:00Z trace_id=trace-7f3a gateway request=/checkout status=502' > "$tmpdir/gateway.log"
printf '%s\n' '2026-09-17T10:00:01Z trace_id=trace-7f3a order call=payment result=failed' > "$tmpdir/order.log"
printf '%s\n' '2026-09-17T10:00:02Z trace_id=trace-7f3a payment error="upstream timeout"' > "$tmpdir/payment.log"
grep -H 'trace-7f3a' "$tmpdir"/*.log
预期输出
<PATH>/gateway.log:2026-09-17T10:00:00Z trace_id=trace-7f3a gateway request=/checkout status=502
<PATH>/order.log:2026-09-17T10:00:01Z trace_id=trace-7f3a order call=payment result=failed
<PATH>/payment.log:2026-09-17T10:00:02Z trace_id=trace-7f3a payment error="upstream timeout"
<PATH> 是 mktemp 创建的临时目录,实际值会不同。这里三个文件都在同一台机器上,所以一次命令就能串起调用链;生产环境真正困难的地方,正是这些文件通常分散在不同主机或容器中。
多服务器会把一次查询拆成多次登录
假设一次结账请求依次经过 Gateway、Order 和 Payment,而三个服务各自运行多个实例。排查人员首先要知道请求落到了哪个实例,再分别登录对应节点,并重复执行查找命令。如果实例已经重启或被调度到其他节点,还要继续追踪日志究竟留在哪里。
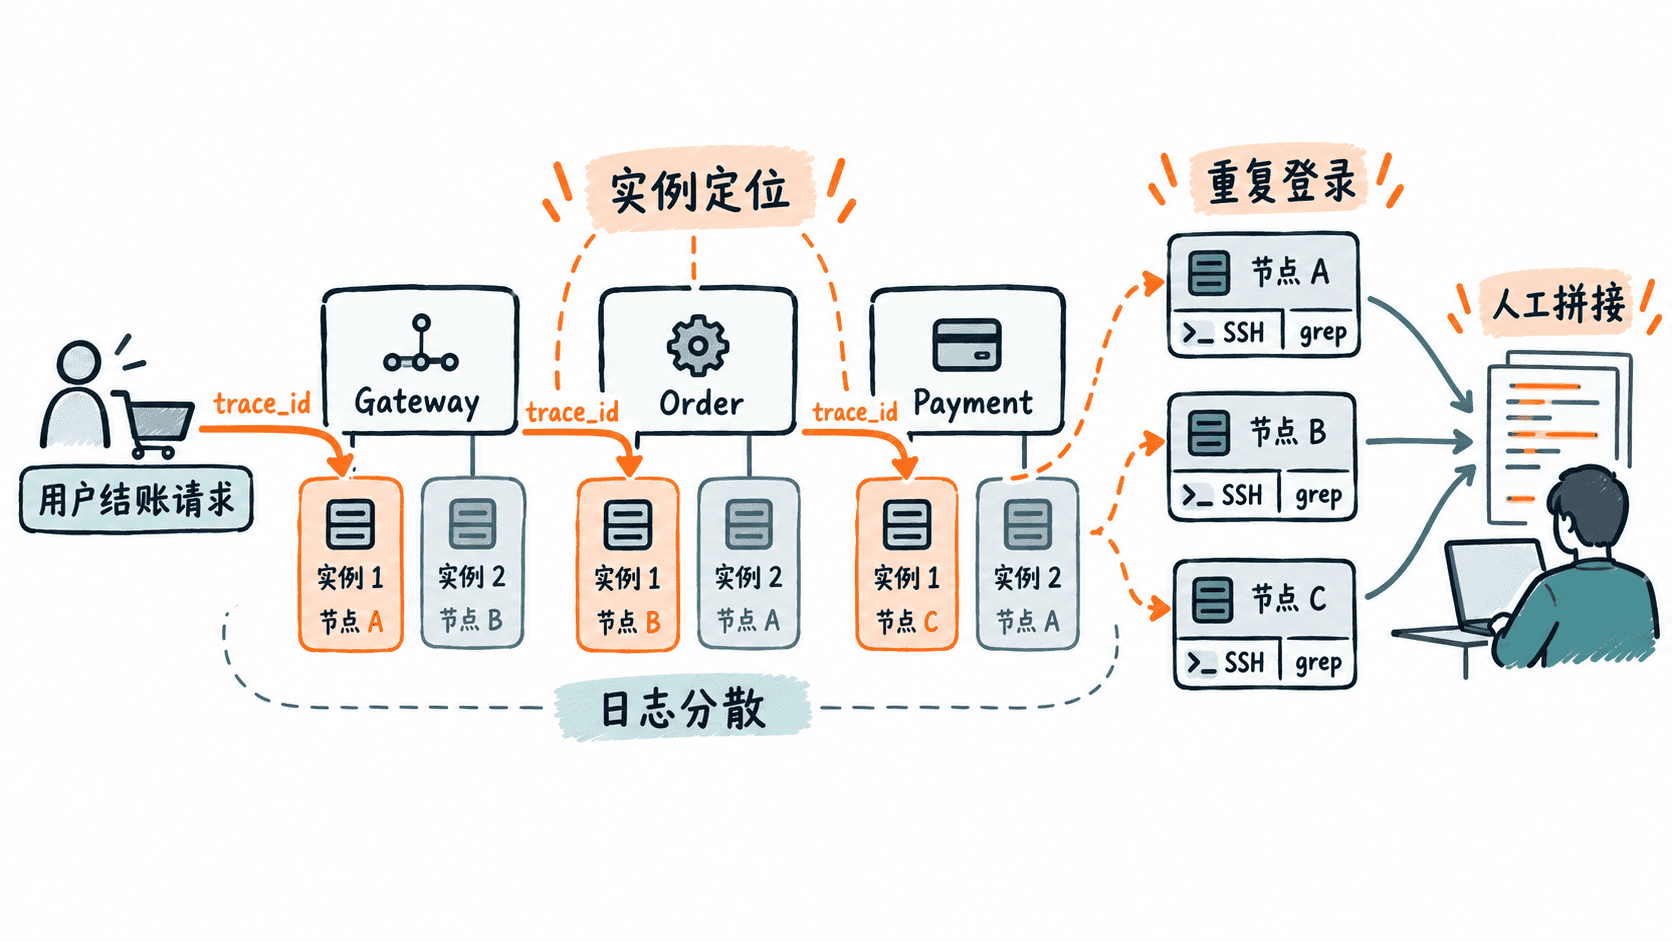
这时,查询成本不再由一条 grep 命令决定,而由“需要访问多少位置”决定。主机越多、实例生命周期越短、服务调用越深,人工检索的路径就越长。
有 trace_id 仍然不等于容易排查
统一的 trace_id 很重要,它让不同服务产生的日志可以表达“这是同一次请求”。但关联标识只解决了匹配依据,没有解决数据位置。
如果三条日志分别在三台服务器上,你仍要先找到服务器,再执行查询;如果日志格式不一致,还要人工理解不同字段;如果机器时间存在偏差,按时间排序也可能得到错误顺序。因此,跨服务排障通常还要求统一时间、结构化字段和可检索的集中存储。
grep 模式最先暴露的四类问题
人工登录模式常见的瓶颈可以归纳为四类:位置不确定,请求可能落在任意实例;查询不可复用,每个人都在手工组合命令;关联困难,需要把多个服务的结果重新按时间和请求标识拼接;留存脆弱,容器退出、文件轮转或节点故障都可能让证据消失。
grep 本身并没有失去价值。它仍适合确认单机文件、检查采集 Agent 是否读到新日志,或在已知节点上快速验证某个关键字。问题在于,当它承担跨主机、跨实例、跨服务的主要检索职责时,人已经开始手工充当“日志平台”。
什么时候该转向集中日志
如果故障定位经常需要登录两台以上主机、服务实例频繁扩缩容,或者团队已经依赖 trace_id、用户 ID、订单 ID 等字段跨服务追踪,就应把日志主动汇聚到统一入口。
集中日志平台的价值不是让 grep 消失,而是把“先找到日志在哪里”这一步从人工操作中移除,并让所有服务在同一个查询界面按时间、字段和关联标识检索。这样,排障人员关注的是请求发生了什么,而不是先花时间寻找哪台机器保存了证据。