
可观测性与稳定性 / 系统课时
节点退出后数据会不会丢失
节点退出后数据会不会丢失
节点离开 Elasticsearch 或 OpenSearch 集群时,数据是否丢失不能只看“节点没了”。真正要看的是离线节点上的分片是否还有可用副本,以及主分片能否被重新选举和分配。本篇用分片状态变化判断风险,并给出实际检查方法。
学习目标
- 理解节点退出后 Primary、Replica 与集群状态的变化
- 能通过集群健康和分片列表判断数据是“暂时不可用”还是存在实际丢失风险
- 区分副本与快照在高可用和灾难恢复中的职责
节点退出时真正发生什么
搜索集群把索引拆成 Primary Shard,并可为每个主分片维护 Replica Shard。正常情况下,同一分片的主副本不会分配在同一节点上,因此单个数据节点退出时,集群仍可能从其他节点上的副本继续提供数据。
如果退出节点承载某个主分片,而另一个节点上存在同步完成的副本,集群会把该副本提升为新的主分片。此时服务可能短暂抖动,集群常先进入 Yellow:主分片都可用,但部分副本尚未重新补齐。待新的副本恢复完成后,状态再回到 Green。
如果某个主分片没有任何可用副本,或者该分片的全部同步副本都同时不可用,主分片会变成 UNASSIGNED,集群进入 Red。对应分片中的文档此时无法正常读取;原节点后来重新加入且磁盘数据完整时可能恢复,但不能把“节点还会回来”当作数据保护方案。
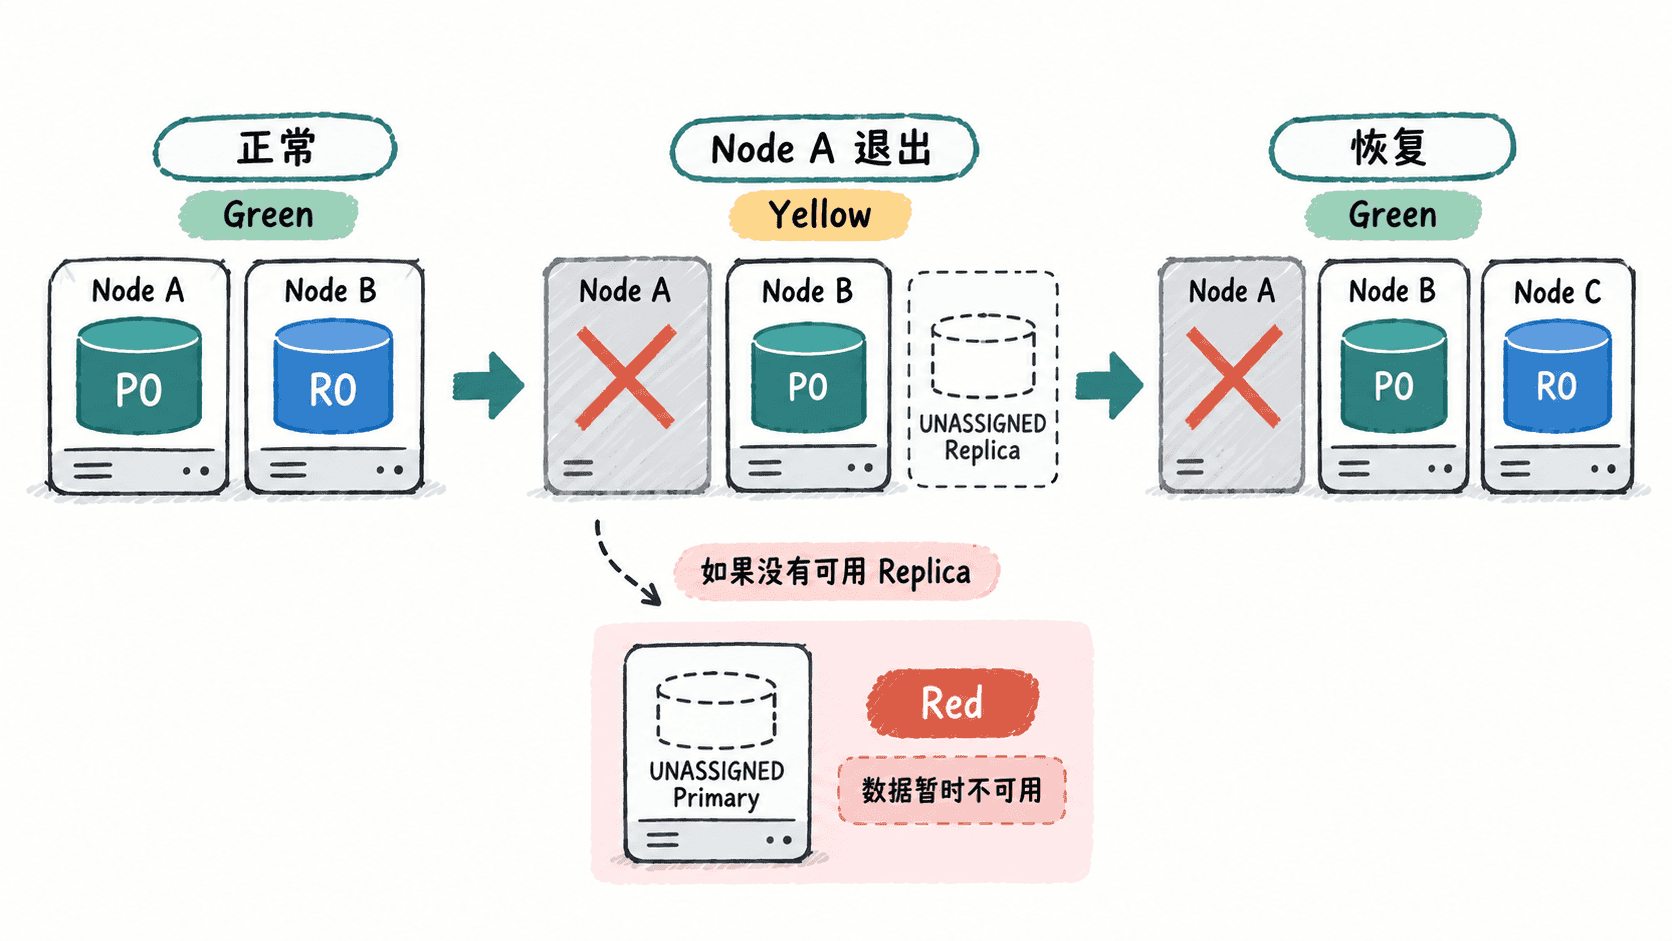
用副本判断数据风险
判断节点故障影响时,先问“这个分片还有没有另一份可用拷贝”,而不是先问“坏了几台机器”。一个节点退出可能完全不影响主分片可用性;反过来,如果关键分片只有单份数据,即使只坏一台节点也可能让索引进入 Red。
还要注意副本数量和节点数量的关系。单节点集群即使配置了 Replica,也无法把副本放到与主分片相同的节点,因此会长期 Yellow;这表示主分片可用,但副本冗余没有真正建立。要抵抗单节点故障,至少需要把同一分片的副本放在其他节点上,并在生产环境进一步考虑机架、可用区等故障域。
实际检查分片状态
节点退出后先看集群健康,再看哪些分片未分配。下面的命令假设集群允许直接访问 HTTP 接口;如果启用了 TLS 或认证,需要按环境补充 https、证书和认证参数。
curl -s "http://<HOST>:<PORT>/_cluster/health?filter_path=status,unassigned_shards"
curl -s "http://<HOST>:<PORT>/_cat/shards?v=true&h=index,shard,prirep,state,node,unassigned.reason"
预期输出
{"status":"yellow","unassigned_shards":1}
index      shard prirep state      node   unassigned.reason
logs-prod  0     p      STARTED    node-b
logs-prod 0 r UNASSIGNED NODE_LEFT实际节点名、分片数量和统计值会不同,<HOST> 与 <PORT> 也应替换为真实地址。这里最关键的是:p 仍为 STARTED,说明主分片可用;r 为 UNASSIGNED,说明当前主要问题是副本冗余不足。若看到主分片 p 为 UNASSIGNED,就应提高故障等级,并继续使用分片分配解释接口确认为什么没有可用副本。
副本不是备份
Replica 的主要作用是节点故障时维持分片可用性并支持故障转移,它会跟随主分片同步数据变化。因此误删文档、错误更新或应用写入坏数据时,这些变化也会复制到副本,Replica 不能代替独立快照。
生产环境要把两类问题分开处理:副本用于高可用和快速故障转移;Snapshot 用于节点彻底损坏、误删除和跨集群恢复等灾难恢复。只有同时具备合理的副本布局和经过验证的快照恢复流程,节点退出才不会变成不可控的数据事件。