
可观测性与稳定性 / 系统课时
怎样用 Request ID 找完整请求
怎样用 Request ID 找完整请求
当一次请求跨过网关、业务服务和下游依赖时,只看某一条错误日志很难还原全过程。Request ID 的作用,是让同一次请求产生的多条日志拥有共同标识;按这个标识检索并按时间排序,就能重建入口、调用和异常发生的顺序。
学习目标
- 理解 Request ID 为什么能把分散日志关联成一次请求
- 能按 Request ID 检索并按时间顺序还原调用过程
- 能识别 Request ID 缺失、变化或未透传导致的断链问题
Request ID 要贯穿整条调用链
理想情况下,请求进入网关时生成或接收一个 Request ID,随后通过请求头或调用上下文传给下游服务。每个服务写日志时都记录同一个值,例如 req-7f3a。
只有“同一请求、同一标识、每一跳都记录”这三个条件同时成立,集中日志平台才能用一个字段把网关、订单服务、支付服务和异常日志关联起来。若某个服务重新生成 ID,链路就会在这里断开。
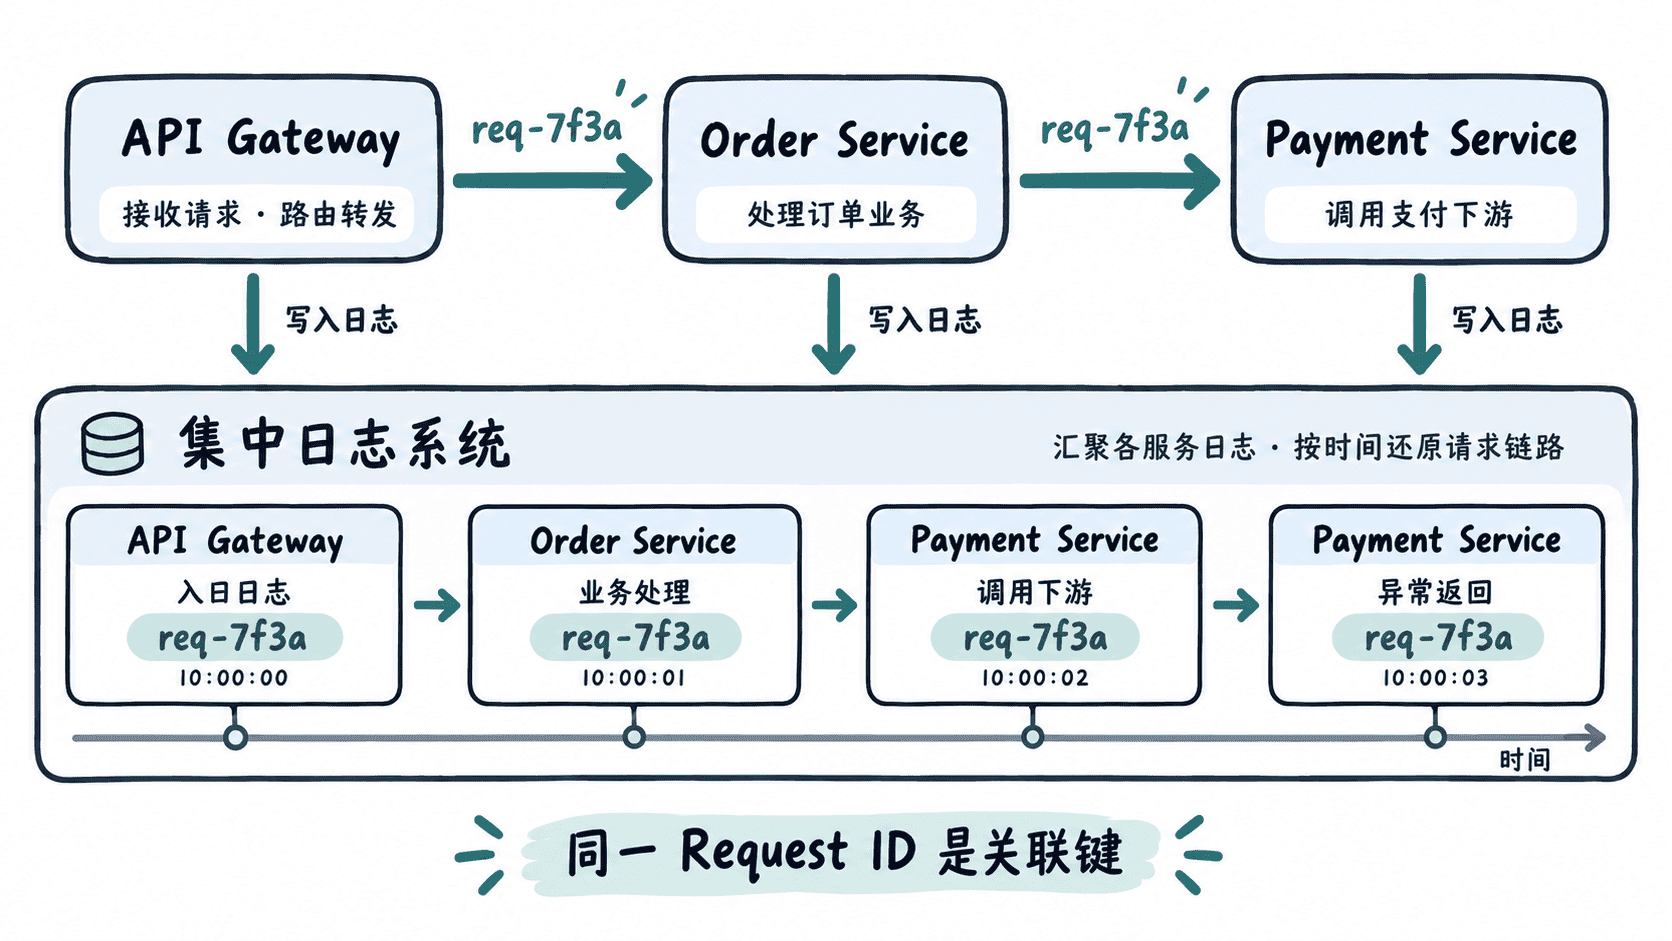
按标识检索并按时间排序
拿到 Request ID 后,不要先叠加服务名、级别等额外条件。第一步应该只查这个 ID,确认链路上到底有哪些记录;第二步再按时间升序查看执行顺序。
下面用 PostgreSQL 构造一组跨服务日志,演示如何还原请求过程。
sql
WITH logs(event_time, service, level, request_id, message) AS (
    VALUES
        ('2026-09-17 10:00:00.100'::timestamp, 'gateway',         'INFO',  'req-7f3a', 'request accepted'),
        ('2026-09-17 10:00:00.130'::timestamp, 'order-service',   'INFO',  'req-7f3a', 'create order'),
        ('2026-09-17 10:00:00.180'::timestamp, 'payment-service', 'ERROR', 'req-7f3a', 'payment timeout'),
        ('2026-09-17 10:00:00.210'::timestamp, 'order-service',   'ERROR', 'req-7f3a', 'payment failed'),
        ('2026-09-17 10:00:01.000'::timestamp, 'gateway',         'INFO',  'req-other', 'another request')
)
SELECT event_time, service, level, message
FROM logs
WHERE request_id = 'req-7f3a'
ORDER BY event_time;
预期结果
text
       event_time        |     service     | level |       message
-------------------------+-----------------+-------+----------------------
 2026-09-17 10:00:00.100 | gateway         | INFO  | request accepted
 2026-09-17 10:00:00.130 | order-service   | INFO  | create order
 2026-09-17 10:00:00.180 | payment-service | ERROR | payment timeout
 2026-09-17 10:00:00.210 | order-service   | ERROR | payment failed
从结果可以看到,请求先进入网关,再由订单服务调用支付服务,真正的首个错误发生在支付服务,随后订单服务记录了上游可见的失败。这样就不会把 payment failed 误当成最初根因。
从完整链路定位断点
还原请求时,优先寻找“最后一条正常记录”和“第一条异常记录”。两者之间通常就是最值得继续检查的调用边界。若日志在某个服务之后突然消失,要区分两种情况:请求真的没有继续执行,还是下游服务没有记录或没有透传 Request ID。
稳定的排查顺序是:先用 Request ID 收集完整记录,再按时间排序重建过程,最后才叠加服务、级别或关键字过滤。这样最不容易把真正的起因提前过滤掉。
按自己的节奏,确认真正理解。