
可观测性与稳定性 / 系统课时
日志平台不可用时会发生什么
日志平台不可用时会发生什么
当 OpenSearch 或 Elasticsearch 暂时不可达时,关键问题不是“会不会报错”,而是未发送成功的日志会在哪里等待、重试多久、磁盘最多占多少,以及缓冲区耗尽后会丢哪一部分数据。本节把这些边界一次规划清楚。
学习目标
- 解释输出失败后 Fluent Bit 的 chunk、重试调度与缓存之间的关系
- 配置文件系统缓冲和每个输出的磁盘队列上限
- 根据日志速率与可容忍中断时间估算缓冲容量,并明确容量耗尽后的数据损失方式
输出失败后数据怎样流转
Fluent Bit 会把输入记录组织成 chunk,再由输出插件尝试发送。输出插件如果返回可重试状态,调度器会安排后续重试;等待时间采用带抖动的指数退避,并可用 scheduler.base 与 scheduler.cap 控制。Retry_Limit 则在每个输出上决定最多重试多少次,False 或 no_limits 表示不限制重试次数。
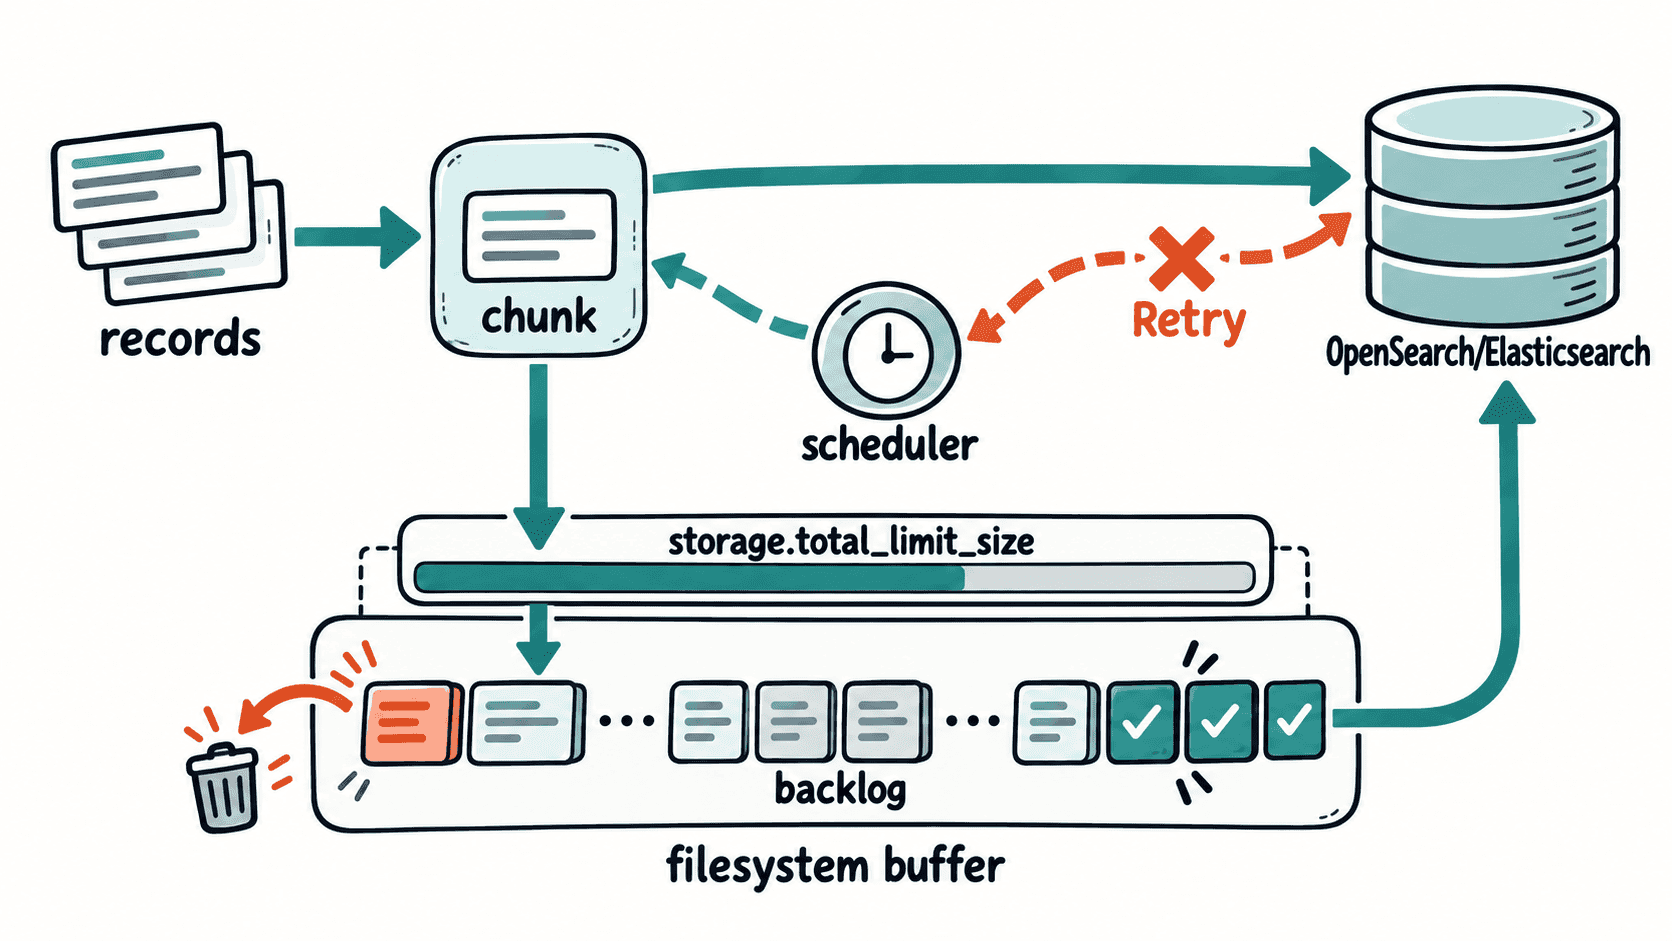
只使用内存缓冲时,目标长时间不可用会让内存压力和输入反压更快出现;文件系统缓冲则把 chunk 的副本保存在磁盘上,降低短暂故障直接造成数据损失的概率,但它依然受磁盘容量和队列上限约束。([Fluent Bit Documentation][3])
配置文件系统缓冲边界
下面的片段示例假设已有 app.demo 日志输入和本地 OpenSearch。storage.path 必须替换成 Fluent Bit 进程可写、且有足够空间的实际目录。
[SERVICE]
    Flush                     1
    Log_Level                 info
    storage.path              <PATH>/flb-storage
    storage.sync              normal
    storage.backlog.mem_limit 50M
    scheduler.base            3
    scheduler.cap             30

[INPUT]
    Name          dummy
    Tag           app.demo
    Dummy         {"service":"checkout","message":"buffer-test"}
    storage.type  filesystem

[OUTPUT]
    Name                      opensearch
    Match                     app.*
    Host                      127.0.0.1
    Port                      9200
    Index                     fluentbit-buffer-test
    Suppress_Type_Name        On
    Retry_Limit               False
    storage.total_limit_size  5G
这份配置的关键不是 5G 本身,而是三层边界:输入用 storage.type filesystem 把 chunk 纳入文件系统缓冲;输出用 Retry_Limit False 持续重试可恢复故障;storage.total_limit_size 5G 限制这个输出逻辑队列最多占用的磁盘空间。当前官方文档明确说明,达到该上限后会丢弃队列中最旧的 chunk,为新数据腾出空间。([Fluent Bit Documentation][3])
用业务中断目标反推磁盘大小
缓冲容量应从“峰值日志速率 × 允许平台中断时间”反推,而不是随手填一个很大的值。假设峰值日志量约为每秒 5 MB,希望搜索平台故障 10 分钟内不因队列上限主动淘汰数据,再预留约 50% 安全余量,所需容量约为 4.5 GB,因此可以把单输出上限规划为约 5 GB,并另外保留文件系统自身的安全空间。
这个估算只解决容量,不解决磁盘吞吐。如果日志突发速度高于磁盘持续写入能力,或者缓冲目录与系统关键文件共用一个快满的分区,Agent 仍可能失去可用空间。更稳妥的做法是把缓冲目录放在可监控的持久磁盘上,并为宿主机保留独立的剩余空间阈值。
用故障演练验证恢复行为
在测试环境中先让 Fluent Bit 持续产生记录,再临时停止搜索平台。此时应观察到输出重试,同时 <PATH>/flb-storage 中出现或增长缓冲数据。可以用下面的命令观察目录占用,实际数值会随日志速率和测试时长变化。
du -sh <PATH>/flb-storage预期输出
<SIZE> <PATH>/flb-storage恢复 OpenSearch 或 Elasticsearch 后,继续观察输出错误是否停止,并检查目标索引的文档数量是否继续增长。缓冲数据被成功回放后,磁盘队列应逐步释放;如果平台已经恢复但 backlog 长时间不下降,则应继续检查目标吞吐、批量写入错误、认证失败或重试队列是否仍在累积。
故障设计的目标不是追求“绝不丢日志”,而是明确可承受的故障窗口和丢失策略:短暂故障靠重试与磁盘缓冲吸收,长时间故障由 storage.total_limit_size 控制磁盘上限,并通过监控在进入淘汰最旧日志之前触发处置。