
可观测性与稳定性 / 系统课时
制作服务错误排行
制作服务错误排行
多服务系统出现大量错误时,先逐个翻日志效率很低。服务错误排行把同一时间窗口内的错误按 service 聚合并按数量降序展示,让你先看到错误最集中的组件,再进入对应服务的日志、指标和调用链继续定位。
学习目标
- 按服务字段统计错误数量并生成 Top N 排行。
- 区分“错误数高”和“错误率高”两种不同信号。
- 识别字段缺失、高流量服务和低样本量造成的误判。
排行前先定义什么算错误
服务排行必须先固定时间窗口与错误条件。用于服务端故障排查时,通常先统计 5xx;如果把 4xx 也纳入,需要明确它们可能来自客户端输入、鉴权或路由,而不一定代表服务自身异常。
聚合字段应是可精确分组的 keyword 类型。若 service 被映射为 text,常见做法是使用 service.keyword;如果你的 service 本身就是 keyword,直接聚合该字段即可。
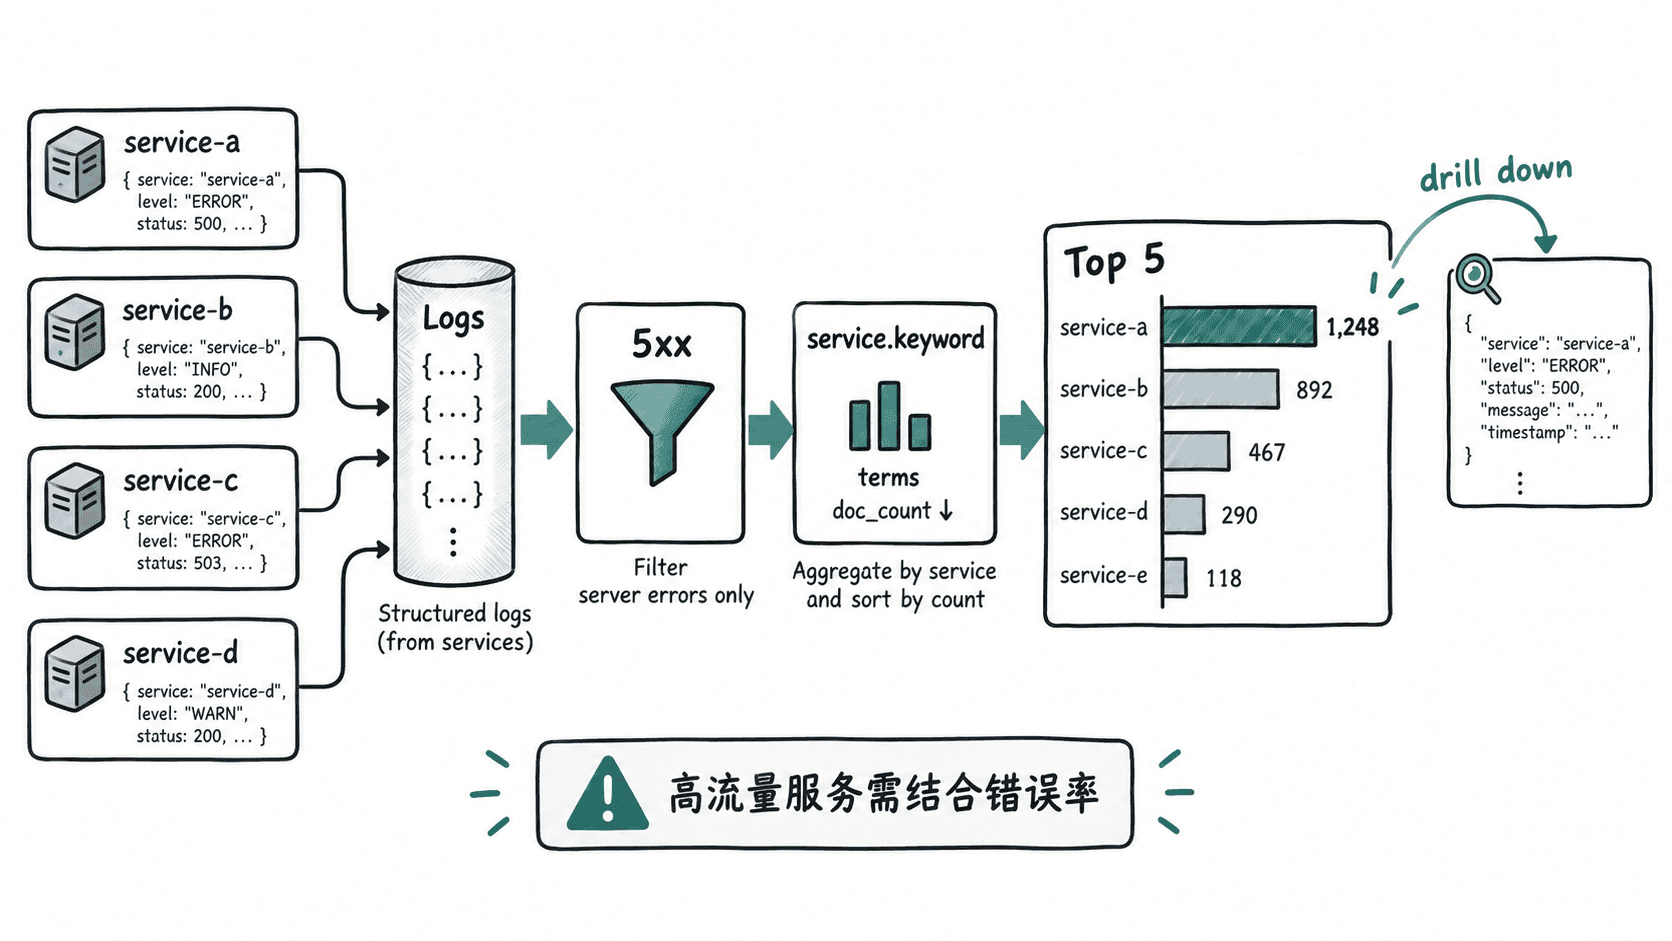
用 terms 聚合得到 Top N 服务
下面的片段示例可在 Elasticsearch 或 OpenSearch Dev Tools 中执行。它统计最近 15 分钟的 5xx,并返回错误数量最高的 10 个服务。
POST logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        {
          "range": {
            "@timestamp": {
              "gte": "now-15m",
              "lt": "now"
            }
          }
        },
        {
          "range": {
            "status": {
              "gte": 500,
              "lt": 600
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "services": {
      "terms": {
        "field": "service.keyword",
        "size": 10,
        "order": {
          "_count": "desc"
        }
      }
    }
  }
}预期结果:aggregations.services.buckets 按 doc_count 从高到低返回服务。实际服务名与数量取决于当前日志数据。
<SERVICE_1>  <COUNT_1>
<SERVICE_2>  <COUNT_2>
<SERVICE_3>  <COUNT_3>
...
若返回 Fielddata is disabled on text fields 一类错误,说明你正在对 text 字段做聚合。应改用已有的 keyword 子字段,或调整 Mapping;不要为了图表临时开启高内存开销的 fielddata。
把排行画成横向条形图
排行图更适合横向条形图:服务名放在类别轴,错误数放在数值轴,并按错误数降序,只展示 Top 5 或 Top 10。服务很多时,完整列表会把注意力分散到长尾组件,失去“优先定位”的意义。
图表时间范围必须与排障窗口一致。一个常见做法是 Dashboard 顶部统一控制时间,排行、错误趋势和原始日志面板共享同一时间过滤器,这样从异常时刻切换到服务排行时不会改变统计口径。
数量排行不等于故障率排行
错误数量高的服务可能只是请求量大。比如 A 服务 100000 次请求出现 100 个 5xx,B 服务 500 次请求出现 20 个 5xx;按数量 A 更高,但按错误率 B 更异常。因此数量排行适合回答“错误主要集中在哪里”,错误率排行更适合回答“哪个服务相对更不健康”。
排行结果要能继续下钻
点击某个服务后,下一步应把 service=<SERVICE> 作为过滤条件,保留相同时间窗口,再查看错误类型、实例、接口路径和原始日志。如果某个服务突然冲到第一名,却只有极少请求,还应检查样本量,避免把偶发单点错误当成系统性故障。
一个可靠的服务错误排行不是“谁排第一谁就一定坏了”,而是把多服务环境中的搜索范围快速缩小到最值得继续验证的组件。