
可观测性与稳定性 / 系统课时
查询越来越慢应该怎么分析
查询越来越慢应该怎么分析
日志检索变慢时,不要先把问题归结为“机器不够快”。更有效的做法是固定同一条查询,先量化耗时与分片范围,再依次检查时间跨度、通配搜索、高基数聚合和分片扇出,最后用 profile 验证时间究竟花在哪个查询阶段。
学习目标
- 用可重复请求建立慢查询基线,而不是凭页面体感判断。
- 分辨查询范围、通配模式、高基数字段和分片数量带来的不同成本。
- 使用 Search Profile 找到真正耗时的查询组件。
先固定一条可重复的基线
先把索引、时间范围、查询条件和返回条数固定下来。下面示例只统计最近 15 分钟内包含 connection timeout 的日志,不返回原始文档,便于反复比较。
HOST="<HOST>"
PORT="<PORT>"
INDEX="<INDEX>"

curl -sS -X POST "http://${HOST}:${PORT}/${INDEX}/_search?filter_path=took,timed_out,_shards,hits.total" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "track_total_hits": true,
    "query": {
      "bool": {
        "filter": [
          {
            "range": {
              "@timestamp": {
                "gte": "now-15m",
                "lte": "now"
              }
            }
          }
        ],
        "must": [
          {
            "match": {
              "message": {
                "query": "connection timeout",
                "operator": "and"
              }
            }
          }
        ]
      }
    }
  }'
预期结果
HTTP 请求成功后,响应应包含 took、timed_out、_shards 和 hits.total。
took 与命中数取决于当前数据;比较优化前后时应保持索引、时间范围和查询条件一致。
如果同一请求在短时间窗口很快、扩大到数天后明显变慢,先处理查询范围和索引范围,而不是立即调 JVM 或扩机器。
按成本来源逐层排查
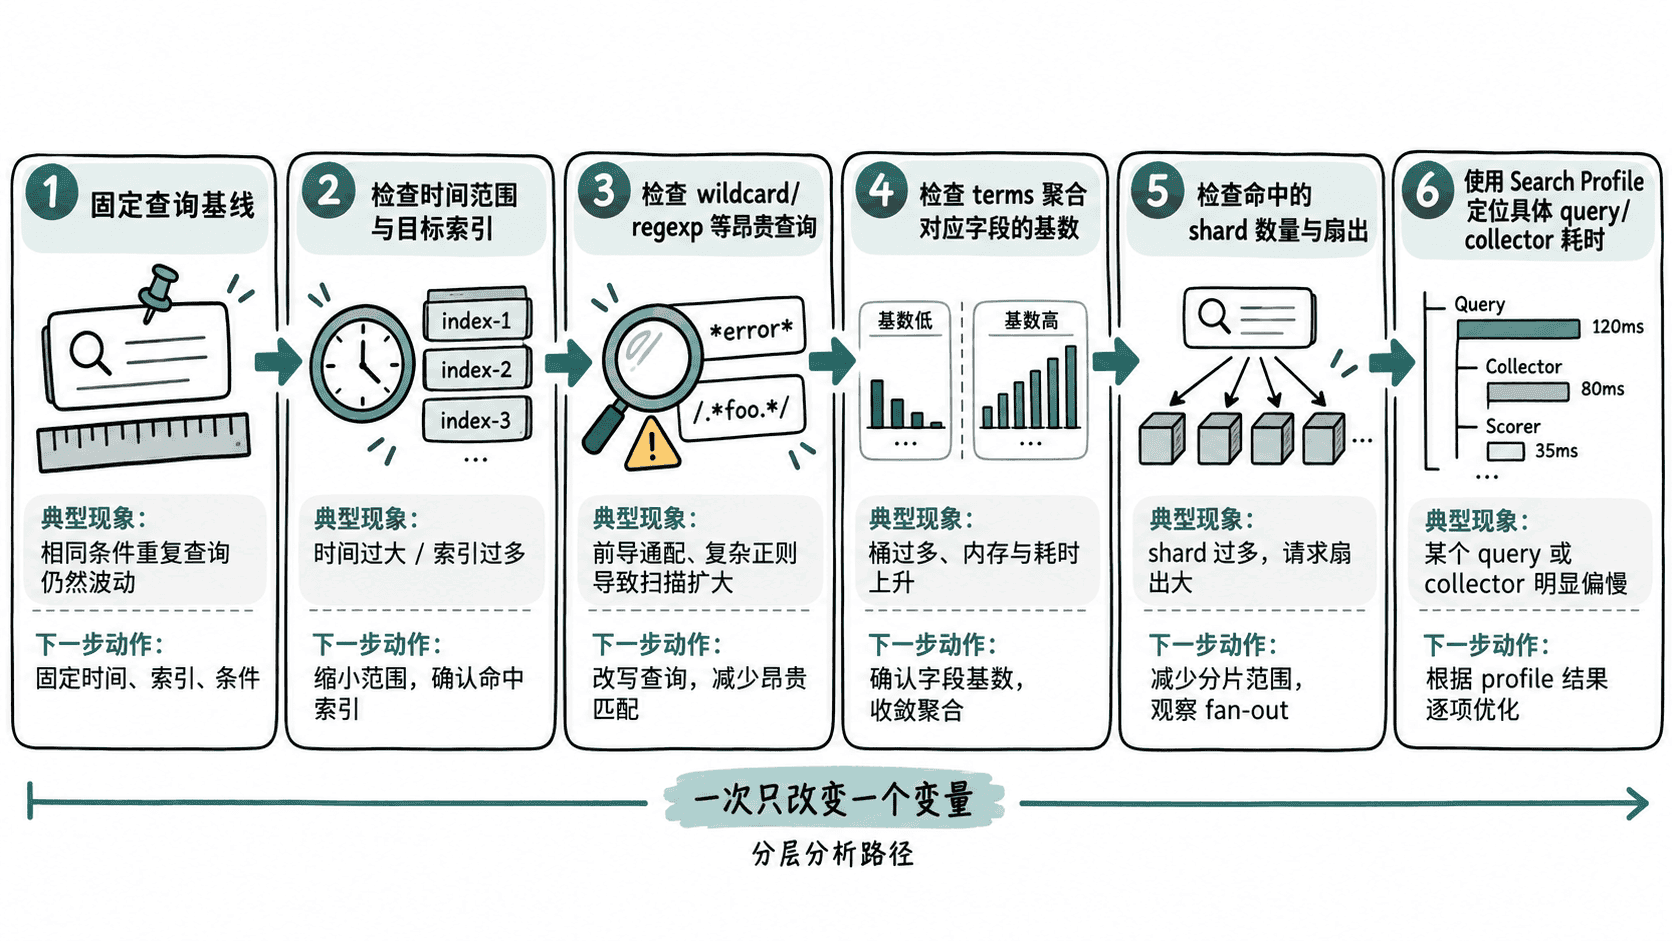
时间范围越大,通常需要访问的数据段越多;使用日期索引或数据流时,还要确认请求是否扫到了远超需要的历史索引。第一步常常是收紧时间,再看性能是否恢复。
通配和正则搜索要看字段与模式。前导通配符如 *timeout 往往比精确词项、前缀或正常 match 更昂贵;对日志消息做大范围 wildcard 时尤其容易放大 CPU 消耗。能用结构化字段过滤时,优先过滤 service、level、status_code 等明确字段。
高基数字段主要在聚合、排序和某些去重场景中带来成本。例如对 request_id 这类几乎每条日志都不同的字段做大规模 terms 聚合,可能需要维护大量桶。高基数并不等于“这个字段不能查”,关键是操作类型与结果规模。
分片过多会让一次查询同时向更多 shard 扇出。即使每个 shard 数据不大,协调节点仍要等待、合并多个结果。因此要同时观察“查询本身做了多少工作”和“这份工作被拆给多少 shard”。
用 Search Profile 验证猜测
当范围、查询形式和分片扇出仍不能解释慢点时,再打开 profile。Profile 会增加额外开销,所以适合诊断请求,不应作为常规生产查询选项。
HOST="<HOST>"
PORT="<PORT>"
INDEX="<INDEX>"

curl -sS -X POST "http://${HOST}:${PORT}/${INDEX}/_search?filter_path=took,profile.shards.id,profile.shards.searches.query.type,profile.shards.searches.query.description,profile.shards.searches.query.time_in_nanos" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "profile": true,
    "query": {
      "match": {
        "message": {
          "query": "connection timeout",
          "operator": "and"
        }
      }
    }
  }'
预期结果
响应包含 took 和 profile.shards。
每个 shard 下可看到查询组件的 type、description 与 time_in_nanos。
具体 shard ID、组件数量和耗时会随索引与数据不同而变化。
先找耗时最大的 shard 与 query 组件,再回到查询语句验证原因。若主要时间消耗在 wildcard/regexp,应改查询方式或字段设计;若大量 shard 都不慢但总耗时仍高,则更应关注扇出、协调与并发压力,而不是只盯单个 Lucene 查询。
优化时一次只改一个变量
排查的顺序应保持可验证:先缩短时间范围,再减少不必要的目标索引;然后替换昂贵通配查询;再检查高基数聚合的桶数量;最后评估 shard 规划。每次修改后都用同一基线请求复测 took 与分片范围。