
可观测性与稳定性 / 系统课时
绘制 4xx 和 5xx 错误趋势
绘制 4xx 和 5xx 错误趋势
单看错误总量只能知道“出问题了”,时间趋势才能回答异常从什么时候开始、持续多久以及是否正在恢复。本节用 HTTP 状态码把 4xx 与 5xx 分开聚合,再把时间桶结果画成两条趋势线,形成可用于值班排查的基础图表。
学习目标
- 用状态码范围分别统计 4xx 与 5xx。
- 按固定时间桶生成可绘图的错误序列。
- 根据流量、发布和错误类型判断趋势是否值得告警或下钻。
先统一图表口径
趋势图至少需要两个字段:时间字段 @timestamp 和数值型状态码字段 status。横轴使用时间,纵轴使用错误数量;4xx 与 5xx 必须拆成两条序列,否则客户端请求问题和服务端故障会被混在一起。
建议先从“错误数量”开始。若业务流量昼夜差异很大,再补充错误率,否则高峰期仅因请求量增加就可能出现错误数量同步上升。
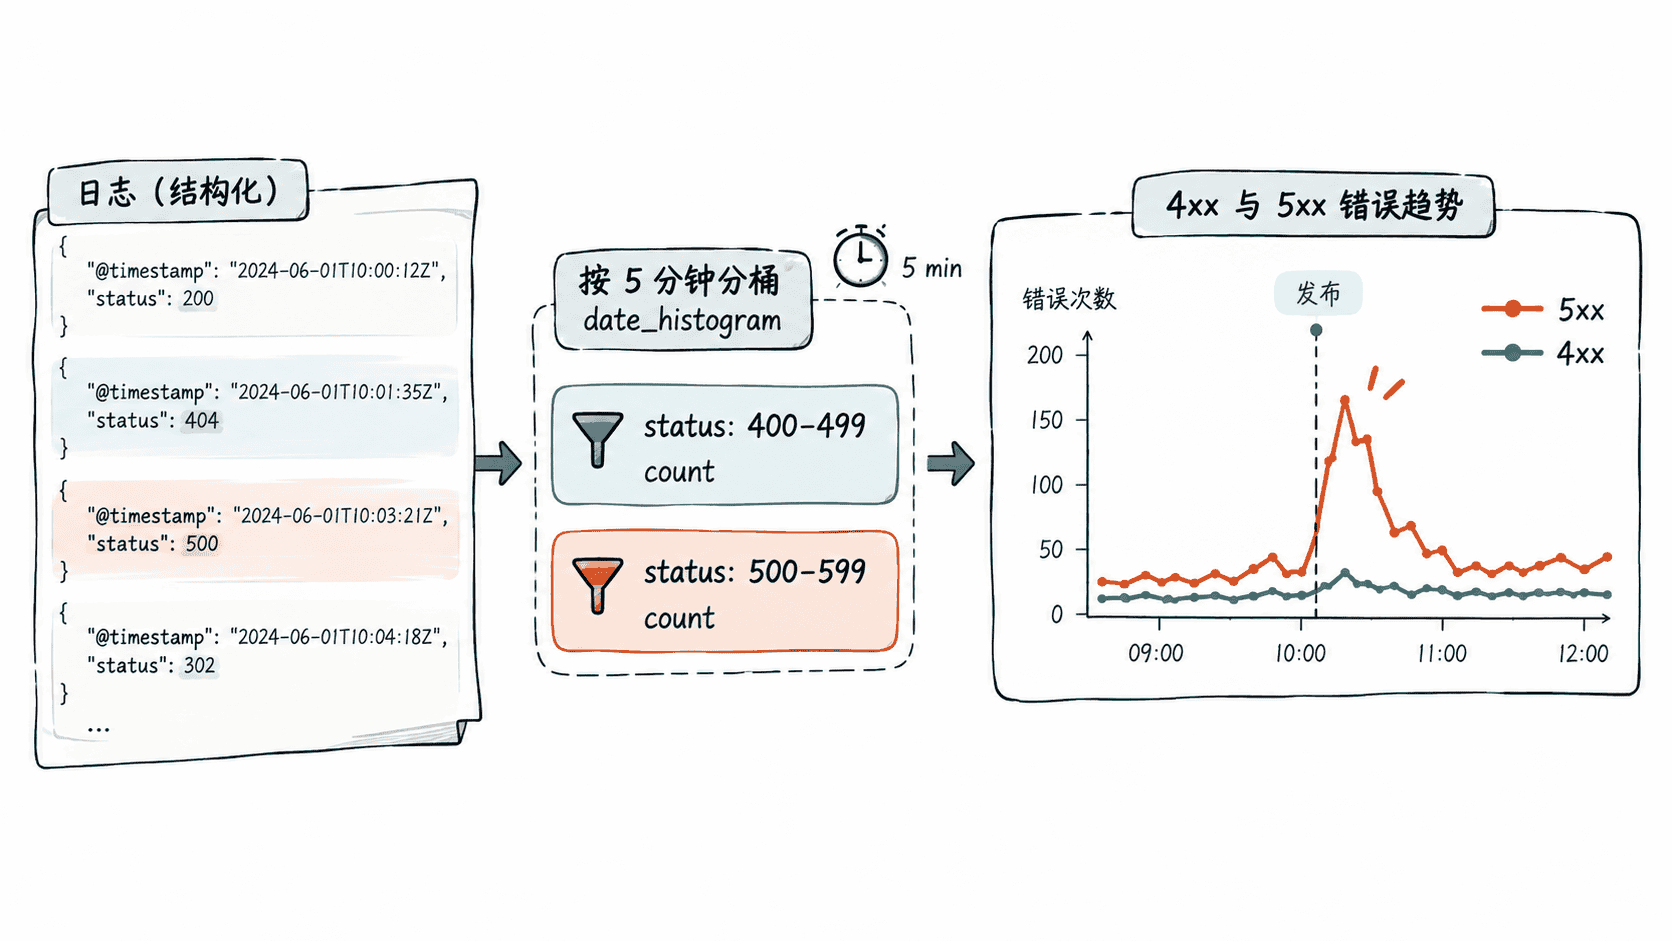
用时间桶生成两类错误序列
下面的片段示例适合直接放进 Elasticsearch 或 OpenSearch 的 Dev Tools。它查询最近 1 小时日志,每 5 分钟生成一个时间桶,并在每个桶内分别统计 4xx 和 5xx。若你的状态码字段不是数值类型,应先修正 Mapping,而不是直接对文本字段做范围查询。
POST logs-*/_search
{
  "size": 0,
  "query": {
    "range": {
      "@timestamp": {
        "gte": "now-1h",
        "lt": "now"
      }
    }
  },
  "aggs": {
    "timeline": {
      "date_histogram": {
        "field": "@timestamp",
        "fixed_interval": "5m",
        "min_doc_count": 0
      },
      "aggs": {
        "status_class": {
          "filters": {
            "filters": {
              "4xx": {
                "range": {
                  "status": {
                    "gte": 400,
                    "lt": 500
                  }
                }
              },
              "5xx": {
                "range": {
                  "status": {
                    "gte": 500,
                    "lt": 600
                  }
                }
              }
            }
          }
        }
      }
    }
  }
}
预期结果:响应中的 aggregations.timeline.buckets 会按 5 分钟排列,每个桶都包含 4xx 与 5xx 的 doc_count。实际时间与数量取决于索引数据。
<TIME>  4xx=<COUNT_4XX>  5xx=<COUNT_5XX>
<TIME>  4xx=<COUNT_4XX>  5xx=<COUNT_5XX>
...
min_doc_count: 0 很重要,它会保留没有错误的时间桶,使折线在“0 错误”时仍连续,而不是把空档误看成采集缺失。
在 Dashboard 中画成两条线
无论使用 Kibana 还是 OpenSearch Dashboards,图表配置都应保持同一口径:时间范围与查询一致,X 轴按 @timestamp 聚合,两个系列分别过滤 400 <= status < 500 和 500 <= status < 600。时间桶可先使用 5 分钟,再根据观察窗口缩放。
短窗口适合定位突发故障,长窗口适合判断趋势。若把一天的数据仍按 1 分钟分桶,噪声会很多;如果把最近 15 分钟按 1 小时分桶,又会把尖峰抹平。时间粒度必须与排障问题匹配。
读图时先判断是哪一类变化
4xx 突升通常先检查请求参数、鉴权、路由或客户端版本;5xx 突升则优先检查应用异常、依赖超时、数据库和下游服务。两者同时上涨时,还要结合总请求量判断是否只是流量激增。
趋势出现拐点后,应把该时间点与发布、配置变更、扩缩容或上游事件对齐,再下钻原始日志。图表负责缩小时间范围,原始日志负责提供具体错误证据,二者不要互相替代。