
可观测性与稳定性 / 系统课时
怎样把日志和监控指标关联起来
怎样把日志和监控指标关联起来
监控指标适合回答“什么时候、哪个服务开始异常”,日志更适合回答“为什么异常”。把 Prometheus 的异常时间窗口、服务标签和实例信息带入日志查询,可以把全量搜索压缩为少量高相关记录,显著缩短根因定位路径。
学习目标
- 从监控曲线提取可用于日志检索的时间窗口和标签
- 把 Prometheus 指标与日志字段按服务、实例和时间对齐
- 用双向验证避免把时间上相邻的日志误判为根因
先从指标确定异常窗口
假设应用暴露 http_requests_total,可以先查询 5xx 请求速率,确定哪个服务在什么时间开始异常。下面通过 Prometheus HTTP API 查询一个时间范围;指标名和标签需按实际采集规则调整。
curl -sG "http://<HOST>:<PORT>/api/v1/query_range" \
  --data-urlencode 'query=sum by (service) (rate(http_requests_total{status=~"5.."}[5m]))' \
  --data-urlencode 'start=<START_TIME>' \
  --data-urlencode 'end=<END_TIME>' \
  --data-urlencode 'step=30s'
预期输出:
HTTP 200。
响应体 status 为 success,data.result 中包含各 service 的时间序列;异常服务会在 <TIME> 附近出现 5xx 速率上升。
<START_TIME> 与 <END_TIME> 可以是 Prometheus API 支持的 RFC3339 时间或 Unix 时间戳,具体值按现场填写。得到异常服务和时间后,不要把整天日志都拉出来,而是围绕突变点建立一个短窗口,例如前后各 5 分钟。
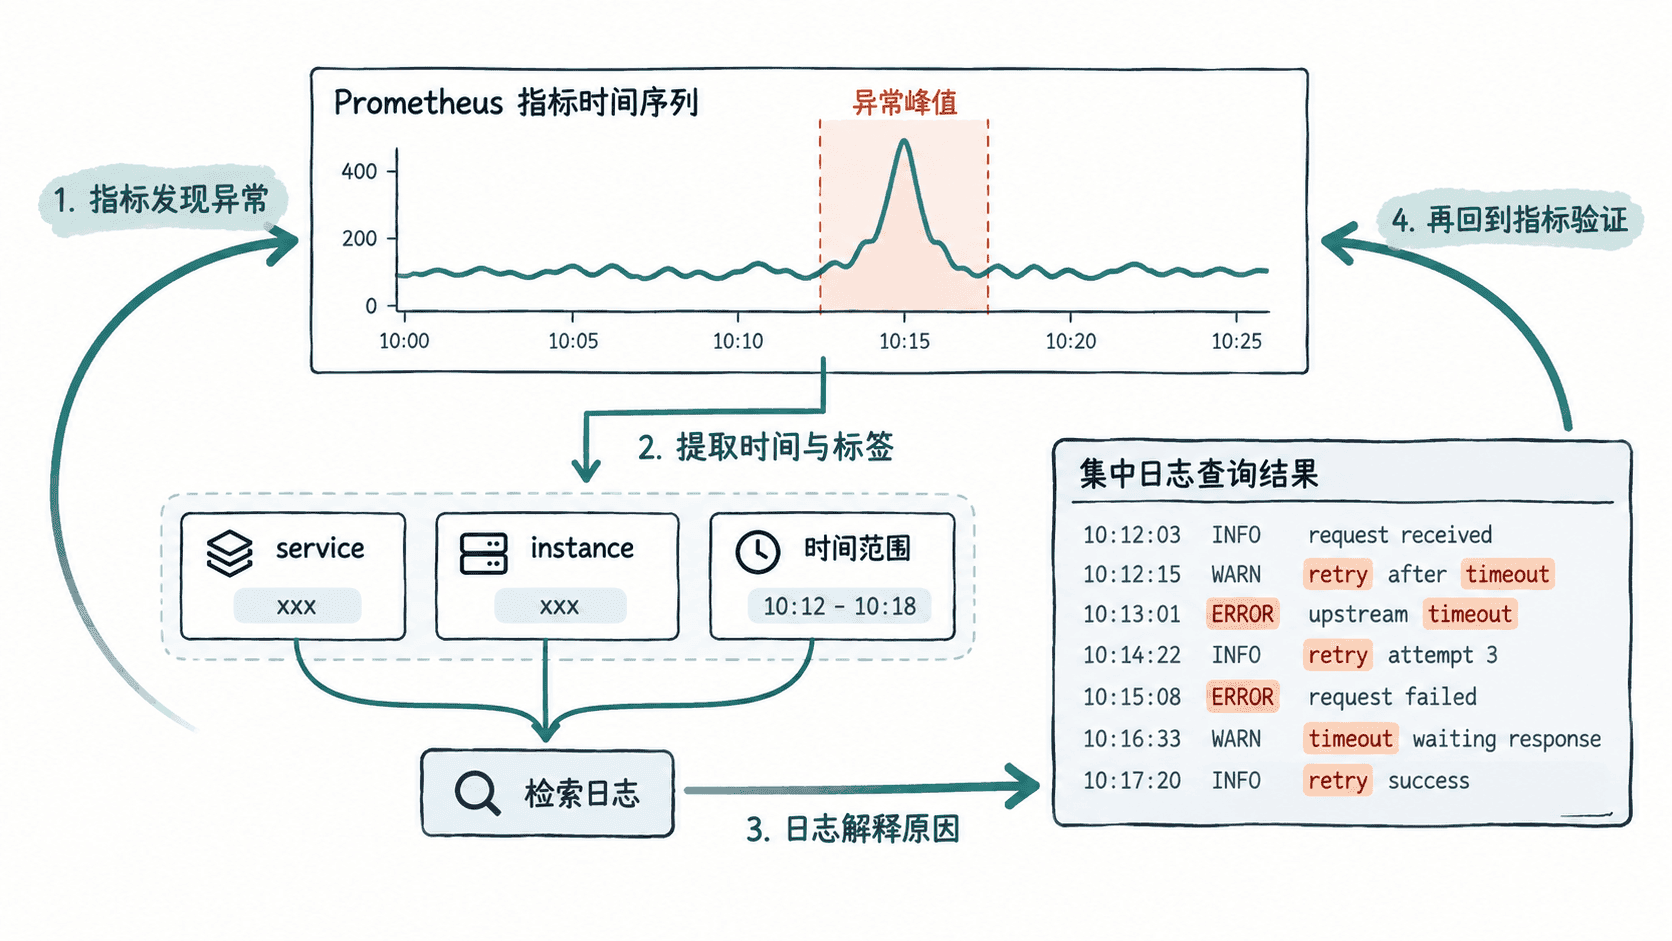
把监控标签翻译成日志条件
最常用的关联键是 service、instance、pod、namespace、cluster 和环境标签。监控里看到 checkout 服务异常,就应优先在同一服务、同一实例和同一时间段内查日志;如果两边标签命名不同,需要先建立映射规则。
下面示例在 Elasticsearch 中查同一时间窗口内的 checkout 日志,并优先返回 ERROR 和 WARN。
curl -s -X POST "https://<HOST>:<PORT>/logs-*/_search" \
  -H 'Content-Type: application/json' \
  -d '{
    "size": 50,
    "query": {
      "bool": {
        "filter": [
          {"range": {"@timestamp": {"gte": "<START_TIME>", "lt": "<END_TIME>"}}},
          {"term": {"service": "checkout"}}
        ],
        "should": [
          {"term": {"level": "ERROR"}},
          {"term": {"level": "WARN"}}
        ],
        "minimum_should_match": 1
      }
    },
    "sort": [
      {"@timestamp": {"order": "asc"}}
    ]
  }'
预期输出:
HTTP 200;hits.hits 返回时间窗口内 checkout 服务的 WARN/ERROR 日志,并按 @timestamp 升序排列。
如果没有命中,应先核对时间范围、时区和 service 字段的实际值。
如果监控已经精确到实例,再加入 instance、pod 或主机字段,通常可以把结果继续缩小。若监控只到服务级别,则先看所有实例,再比较是否只有某个实例在同一时间出现异常。
处理时间和维度不一致
指标和日志最容易出现两类错位。第一类是时间错位:Prometheus 通常按抓取时间记录样本,而日志按事件时间记录;第二类是维度错位:指标中的 instance 可能是抓取目标地址,日志里的实例字段却是 Pod 名或主机名。
用双向证据确认根因
找到可疑日志后,要回到指标验证影响是否吻合。例如日志显示连接池耗尽,就观察同一时间是否伴随请求延迟、错误率或连接数变化;如果日志只出现一次且指标没有对应波动,它可能只是伴随事件。
反过来也一样:如果 CPU、延迟或错误率先变化,而日志几分钟后才出现错误,根因往往发生在第一批错误日志之前。最终要形成可解释的时间链:指标告诉你异常从哪里开始,日志给出机制证据,指标再验证该机制是否影响了系统行为。