
可观测性与稳定性 / 系统课时
怎样找故障开始的准确时间
怎样找故障开始的准确时间
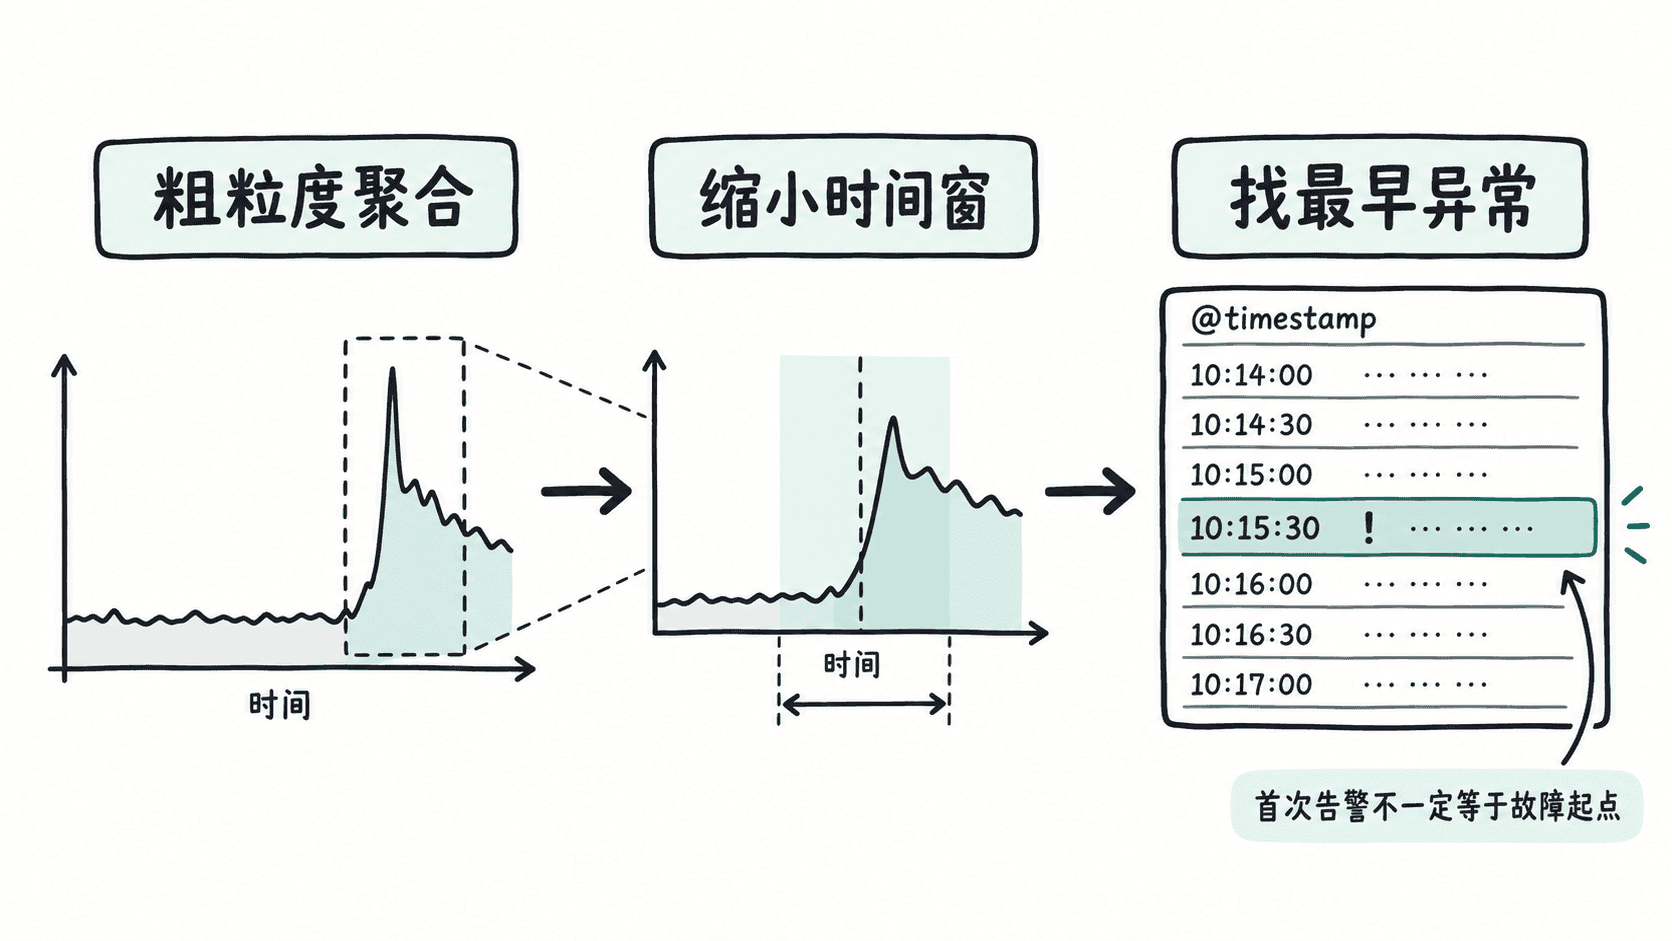
线上故障的“开始时间”不应靠第一条告警或用户反馈来猜。更可靠的方法是先按时间聚合错误量,找到异常突增的分钟级区间,再缩小窗口并按时间升序检索,定位最早出现的异常日志。
学习目标
- 用时间聚合找到错误量开始异常的区间
- 在窄时间窗口内定位最早异常记录
- 区分“首次报错时间”和“真正根因开始时间”
先用聚合找突增点
直接在全天日志里按时间排序会得到大量噪声。先对错误日志做 date_histogram 聚合,把每分钟的错误量压缩成一条时间序列,更容易发现从正常基线突然抬升的位置。
下面假设日志索引为 logs-*,错误级别字段为 level,时间字段为 @timestamp。如果实际 Mapping 使用 level.keyword,把查询字段替换为对应的 keyword 字段。
bash
curl -s -X POST "https://<HOST>:<PORT>/logs-*/_search" \
  -H 'Content-Type: application/json' \
  -d '{
    "size": 0,
    "query": {
      "bool": {
        "filter": [
          {"range": {"@timestamp": {"gte": "<START_TIME>", "lt": "<END_TIME>"}}},
          {"term": {"level": "ERROR"}}
        ]
      }
    },
    "aggs": {
      "errors_over_time": {
        "date_histogram": {
          "field": "@timestamp",
          "fixed_interval": "1m",
          "min_doc_count": 0
        }
      }
    }
  }'
预期输出:
text
HTTP 200;aggregations.errors_over_time.buckets 按分钟返回 doc_count。
异常开始附近会出现某个 bucket 的错误量明显高于前后基线。<HOST>、<PORT>、<START_TIME>、<END_TIME> 按实际环境填写;认证参数也应按集群安全配置补充。聚合得到的是“候选故障窗口”,例如发现 <TIME> 附近开始陡增,下一步只查这一小段。
缩小窗口找第一条异常
把聚合发现的突增点前后各扩几分钟,再按时间升序取第一条错误日志。这样既避免漏掉突增前已经发生的异常,也能快速找到最早可见证据。
bash
curl -s -X POST "https://<HOST>:<PORT>/logs-*/_search" \
  -H 'Content-Type: application/json' \
  -d '{
    "size": 1,
    "query": {
      "bool": {
        "filter": [
          {"range": {"@timestamp": {"gte": "<START_TIME>", "lt": "<END_TIME>"}}},
          {"term": {"level": "ERROR"}}
        ]
      }
    },
    "sort": [
      {"@timestamp": {"order": "asc"}}
    ]
  }'
预期输出:
text
HTTP 200;hits.hits 中最多返回 1 条记录。
如果窗口内存在错误日志,这条记录应是该查询条件下时间最早的一条。
找到第一条错误后,不要立即把它当成根因。继续查看它之前几十秒到几分钟的 WARN、超时、重试、依赖异常和配置变更日志,常能发现“先异常、后大量报错”的因果链。
注意时间字段是否可信
故障时间分析依赖时间戳一致性。至少确认三件事:服务主机时钟已同步;日志时间统一使用 UTC 或已明确时区;采集延迟没有把“事件发生时间”误当成“日志到达时间”。
验证故障起点
一个可信的故障起点通常能同时解释后续现象:从该时间之后错误量持续上升,相关服务开始超时或重试,并且与部署、配置变更、依赖故障等事件时间接近。若最早错误前已经存在异常信号,就继续向前扩展窗口,直到找到能够解释整条故障链的最早证据。
按自己的节奏,确认真正理解。