
可观测性与稳定性 / 系统课时
日志突然写不进去应该查什么
日志突然写不进去应该查什么
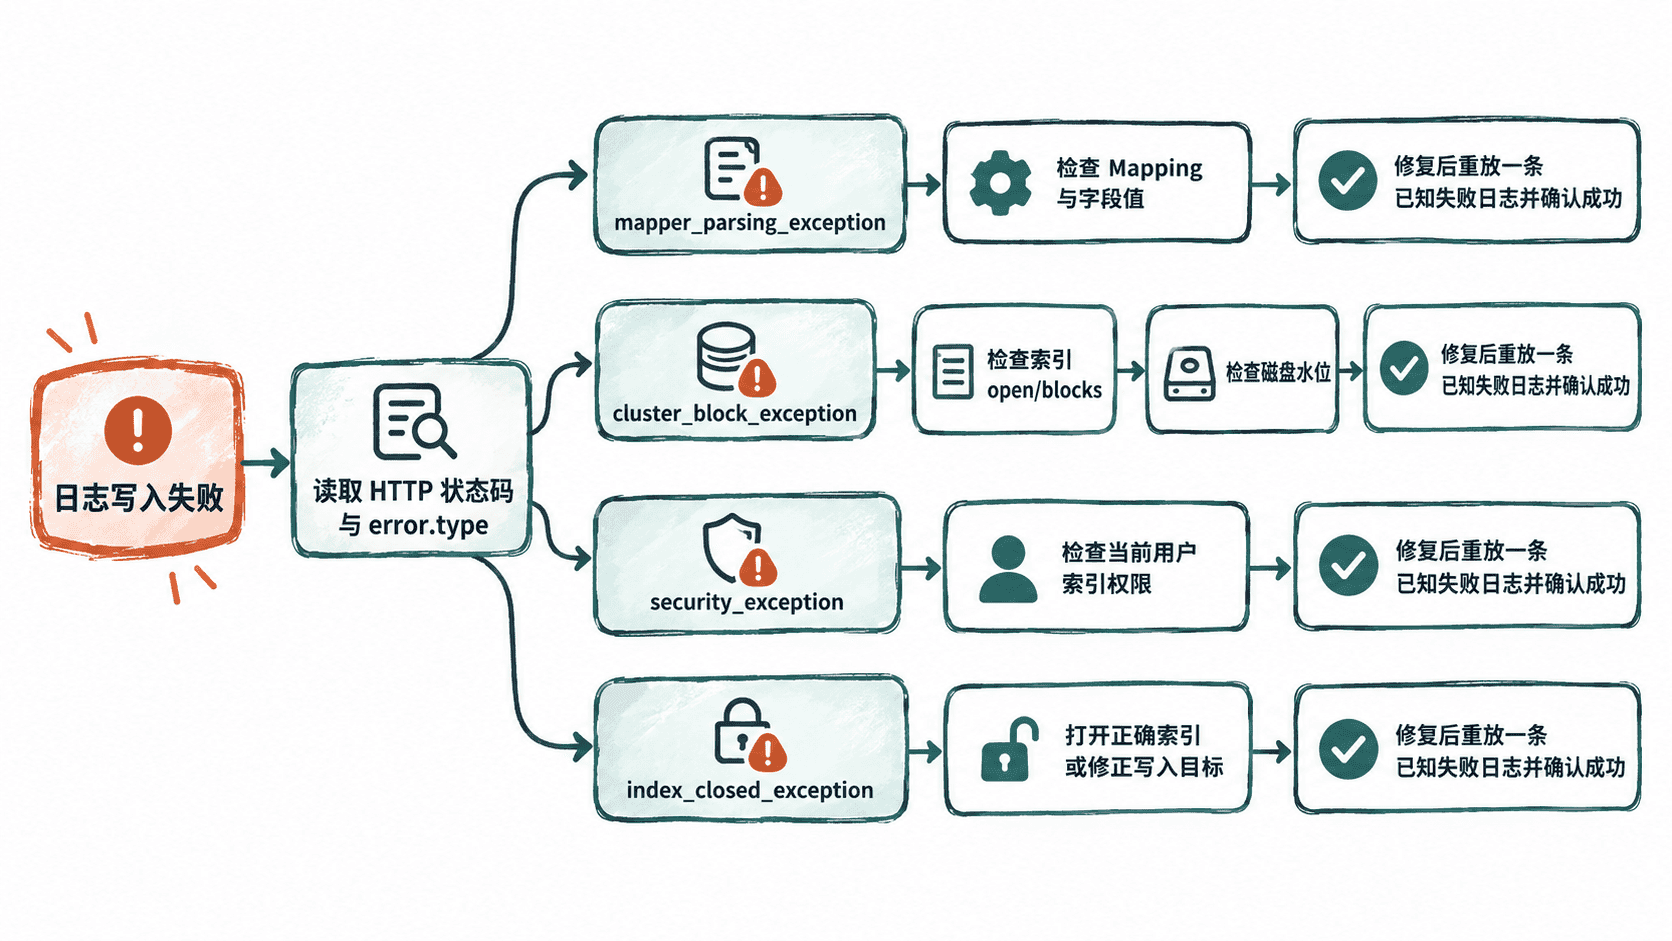
日志写入突然中断时,最有效的做法不是先重启采集器,而是保留一条失败响应,再沿着“字段映射 → 索引状态 → 磁盘 → 权限”缩小范围。这样既能避免误修,也能判断问题发生在数据内容、索引保护机制还是访问控制。
学习目标
- 从写入错误中的
error.type和原因快速选择排查方向。 - 检查字段类型、索引写入块、磁盘水位和当前账号权限。
- 修复后用最小验证确认写入链路真正恢复。
先保留失败请求的原始错误
先从采集器、Logstash、应用 SDK 或反向代理日志中找一条完整失败响应。不要只记录“写入失败”这四个字;HTTP 状态码、error.type、目标索引和具体 reason 才能决定下一步。
常见线索可以这样归类:字段值无法按现有 Mapping 解析时,通常会看到 mapper_parsing_exception;索引被写保护时会看到 cluster_block_exception;认证或索引权限不足时常见 security_exception。如果目标索引被关闭,也应先恢复索引状态,而不是修改采集端重试参数。
一次采集四组诊断信息
下面以 Elasticsearch 为例。将 <INDEX> 替换为实际写入索引,将 <FIELD> 替换为失败日志涉及的字段;命令只读取状态,不修改集群。
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/<INDEX>/_mapping"
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/_cat/indices/<INDEX>?v=true&h=health,status,index"
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/<INDEX>/_settings?filter_path=*.settings.index.blocks.*"
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/_cat/allocation?v=true&h=node,disk.percent,disk.avail,disk.total"
预期输出
{"<INDEX>":{"mappings":{"properties":{"<FIELD>":{"type":"<TYPE>"}}}}}
health status index
green  open   <INDEX>
{}
node    disk.percent disk.avail disk.total
<NODE>  <PERCENT>    <SIZE>     <SIZE>
实际值会随集群变化。重点不是追求固定数字,而是确认四件事:失败字段的既有类型是什么、索引是否 open、是否存在 index.blocks.write 或 index.blocks.read_only_allow_delete、承载该索引分片的节点是否已经接近磁盘保护阈值。
字段冲突先修数据契约
如果错误指向某个字段,例如历史数据把 status_code 建成 long,新日志却发送 "OK",那么同一字段不能靠重试自动变成另一种类型。先确认生产者为什么改变了数据类型,再决定是修正日志格式、改用新字段名,还是写入带正确 Mapping 的新索引并迁移。
对于按天或滚动生成的多个日志索引,还可以用 Field Capabilities 检查同名字段是否在不同索引里出现多种类型。发现跨索引类型不一致时,应同时检查索引模板,避免下一个新索引再次生成错误 Mapping。
索引块要继续追到磁盘原因
当 index.blocks.read_only_allow_delete 出现时,不要把“解除只读”当成第一修复动作。Elasticsearch 在节点达到 flood-stage 磁盘水位时会用该块保护磁盘;磁盘使用下降到高水位以下后,系统会自动解除这类保护。
因此应先扩容、清理可安全删除的旧索引或让分片重新分配,再确认写入块是否消失。若索引是 closed,则确认它是否本来就应该接收日志;只有目标确实正确时才重新打开,避免把数据写进已经归档的索引。
权限问题用当前账号直接验证
如果错误是 security_exception,不要只检查“账号能否登录”。日志账号需要对实际目标索引拥有与写入动作匹配的索引权限。可以让当前账号检查自己的权限:
curl -sS -u <USER>:<PASSWORD> -X POST "https://<HOST>:<PORT>/_security/user/_has_privileges" -H "Content-Type: application/json" -d '{"cluster":[],"index":[{"names":["<INDEX>"],"privileges":["create_doc","index","write"]}]}'预期输出
{
  "username": "<USER>",
  "has_all_requested": <BOOLEAN>,
  "cluster": {},
  "index": {
    "<INDEX>": {
      "create_doc": <BOOLEAN>,
      "index": <BOOLEAN>,
      "write": <BOOLEAN>
    }
  },
  "application": {}
}
若所需权限为 false,应修正角色对目标索引或数据流的授权,而不是直接给日志账号管理员权限。还要确认实际写入名称:采集器可能写的是数据流或滚动后的新索引,权限只覆盖旧索引模式时也会突然失败。
修复后验证链路而不是只看一个接口
修复后重新发送一条已经失败过、且内容可识别的测试日志,再确认采集端不再重试、Elasticsearch 返回成功、目标数据流或索引能检索到该记录。若写入恢复但积压仍持续增长,继续检查采集端队列、Bulk 重试和下游消费速度;这说明根因已经从“拒绝写入”转成了“恢复后的吞吐追赶”。