
可观测性与稳定性 / 系统课时
字段类型冲突为什么很麻烦
字段类型冲突为什么很麻烦
同一个日志字段如果先写入数字、后来又写入文本,Elasticsearch 可能已经依据前一批数据确定了字段类型,后续文档就会因为解析失败而被拒绝。本节用一个可复现的冲突示例说明问题发生的位置,并给出从日志源头降低冲突风险的方法。
学习目标
- 理解动态 Mapping 为什么会把首次出现的数据类型固化下来
- 复现“先写数字、后写文本”导致的索引失败
- 通过字段规范和显式 Mapping 降低生产环境中的类型冲突
冲突发生在写入阶段
假设 response_time_ms 第一次收到的是数字 120。在允许动态映射时,Elasticsearch 会为它建立数值类型。之后如果另一个采集器把超时状态写成字符串 "timeout",这个值无法解析成原来的数字类型,该文档就可能写入失败。
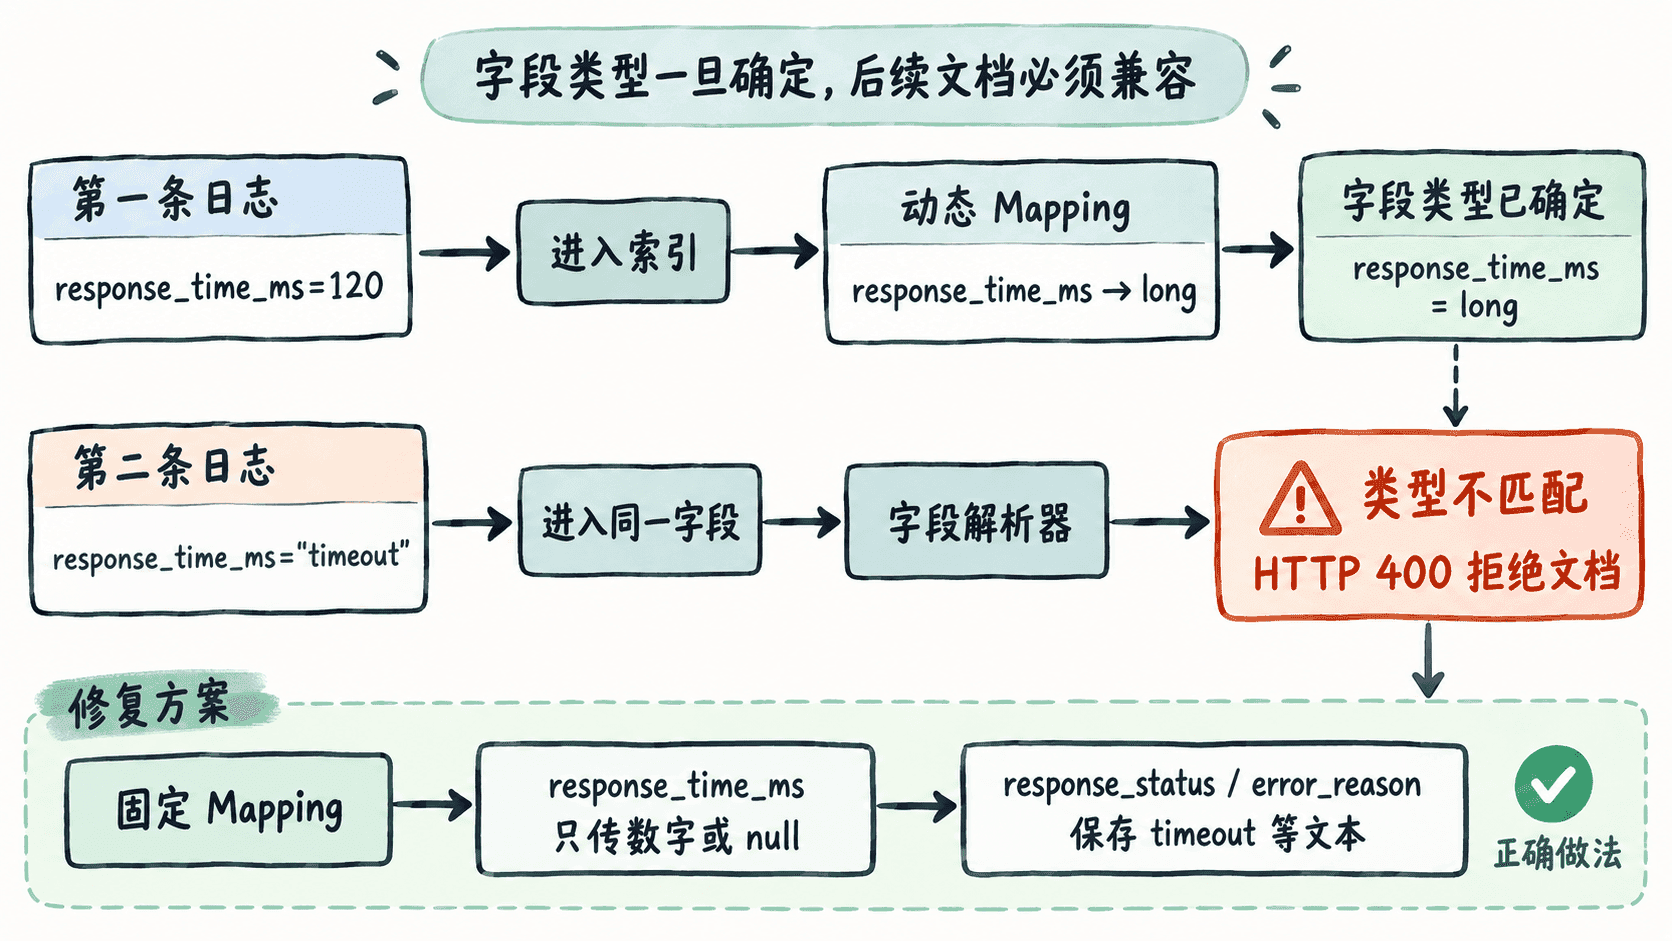
麻烦之处不只是“这一条报错”。日志流水线通常是持续写入的,类型冲突会让一部分事件被拒绝,造成检索数据缺口;如果多个服务共用索引模式,某个服务的异常值还可能影响其他服务的正常写入。
复现先数字后文本的失败
下面创建一个空索引,让第一次写入触发动态 Mapping。示例中的 <PORT> 请替换为 Elasticsearch 实际端口。
ES="http://localhost:<PORT>"

curl -s -o /dev/null -w 'create=%{http_code}\n' \
  -X PUT "$ES/type-conflict-demo"

curl -s -o /dev/null -w 'first=%{http_code}\n' \
  -X PUT "$ES/type-conflict-demo/_doc/1" \
  -H 'Content-Type: application/json' \
  -d '{"response_time_ms":120}'

curl -s -o /dev/null -w 'second=%{http_code}\n' \
  -X PUT "$ES/type-conflict-demo/_doc/2" \
  -H 'Content-Type: application/json' \
  -d '{"response_time_ms":"timeout"}'
预期输出:
create=200
first=201
second=400
第一条文档把 response_time_ms 建成数值字段;第二条文档中的 "timeout" 不能按数值解析,因此请求返回 400。具体错误对象会随 Elasticsearch 版本和响应格式略有差异,所以排查时应关注 HTTP 状态码以及错误中的字段名和解析原因,而不是依赖完整报错文本逐字匹配。
不要用“什么都转字符串”规避冲突
把所有字段都改成 keyword 看似能避免解析失败,但代价是失去正确的数值语义。响应时间、字节数、状态码需要做范围筛选、排序、平均值和分位数分析,字符串类型并不适合这些操作。
更可靠的做法是把“数值”和“状态”拆开。例如 response_time_ms 只接受数字或空值,超时原因放到 response_status 或 error_reason。这样字段语义单一,异常情况也不会挤进数值字段。
用显式 Mapping 提前暴露坏数据
生产环境中,与其让首批数据决定类型,不如通过索引模板或数据流模板提前声明关键字段。下面给出一个最小 Mapping:响应时间固定为整数,错误原因使用 keyword。
curl -s -o /dev/null -w 'mapping=%{http_code}\n' \
  -X PUT "$ES/type-safe-logs" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "response_time_ms": {"type": "integer"},
        "error_reason": {"type": "keyword"}
      }
    }
  }'

curl -s -o /dev/null -w 'document=%{http_code}\n' \
  -X PUT "$ES/type-safe-logs/_doc/1" \
  -H 'Content-Type: application/json' \
  -d '{
    "response_time_ms": null,
    "error_reason": "timeout"
  }'
预期输出:
mapping=200
document=201
这里没有把 "timeout" 塞进 response_time_ms,因此写入可以保持稳定。若采集器错误地发送文本到数值字段,显式 Mapping 会立即暴露问题,便于把修复点放回采集、解析或应用日志格式,而不是在查询阶段掩盖错误。
排查时先定位第一个错误字段
遇到批量写入失败时,先检查失败文档对应的字段名、原始值和当前 Mapping,再追查是谁改变了数据形态。重点对比正常事件与异常事件:是否多了单位、空字符串、占位词、数组或对象,是否不同服务复用了同名但不同语义的字段。
一旦字段已经以错误类型写入,通常不能直接把现有字段无损改成另一种类型。更稳妥的做法是修正 Mapping 后写入新索引,再按需要重建或迁移数据。把字段规范放在采集入口,并用显式 Mapping 固定关键字段,能把这类问题从“线上数据缺口”提前变成可检测的格式错误。