
可观测性与稳定性 / 系统课时
日志进入搜索引擎后变成什么
日志进入搜索引擎后变成什么
一条日志被采集并解析后,通常不再只是整段文本,而会作为一篇带字段的文档写入 OpenSearch 或 Elasticsearch。理解“日志事件 → 文档 → 可检索字段”的变化,是后续设计 Mapping、查询条件和聚合分析的基础。
学习目标
- 理解一条日志事件为什么通常对应一篇文档
- 识别日志文档中的业务字段、时间字段和元数据
- 理解字段化保存如何支撑全文检索、过滤与聚合
从日志事件到文档
假设应用最初输出一条文本日志:时间、级别、服务名、请求路径和耗时都挤在同一行。采集器可以先解析这些信息,再将它们组织成 JSON 对象。搜索引擎接收到这个对象后,会把它作为一篇文档写入目标 Index。
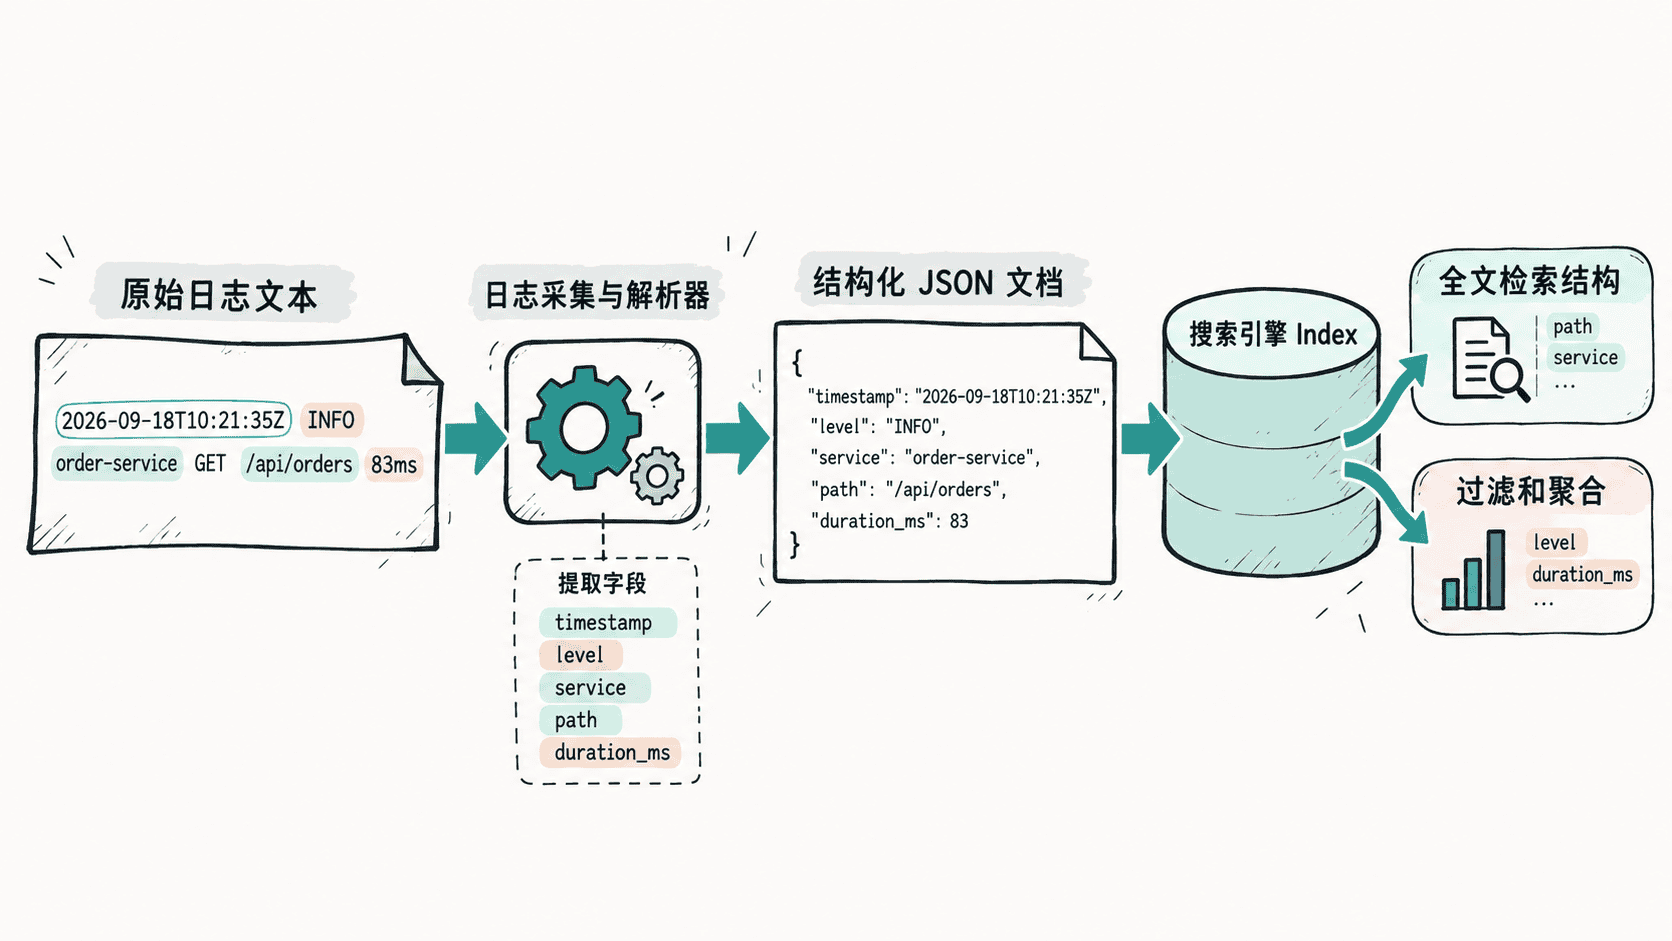
一篇典型日志文档可以表示为:
{
  "@timestamp": "2026-09-17T04:20:31Z",
  "level": "ERROR",
  "service": "checkout-api",
  "path": "/orders",
  "duration_ms": 842,
  "message": "payment gateway timeout"
}
这是数据结构示例,不需要直接执行。实际字段由采集器的解析规则以及搜索引擎的 Mapping 决定;写入后可以通过查询接口检查文档中的字段和值是否符合预期。
文档中保存的不只是 message
message 往往保留适合人工阅读的原始消息,但集中日志真正有价值的部分是结构化字段。例如 service 可以筛选指定服务,level 可以统计错误数量,duration_ms 可以计算延迟分布,@timestamp 则用于限定查询时间范围和绘制趋势图。
搜索引擎还会根据 Mapping 决定字段怎样建立索引。字符串可能用于全文检索或精确匹配,数值可以执行范围查询和聚合,日期字段可以进行时间过滤。如果本应是数值的耗时被识别为普通字符串,后续统计就会变得困难。
一条日志不一定等于原始的一行
“一个日志事件通常对应一篇文档”比“文本文件中的一行对应一篇文档”更准确。Java 异常堆栈等多行日志,采集器通常会先把连续多行合并成一个事件,再解析并写成一篇文档。否则一次异常可能被拆成十几篇互不关联的文档。
同样,采集器还可能补充主机名、容器名、环境、数据源等元数据。这些字段并不是应用原始消息的一部分,却非常适合用于跨主机、跨服务检索。
搜索引擎为什么要把日志变成文档
如果只保存完整文本,搜索系统只能不断对字符串做匹配;字段化之后,同一批数据可以同时支持全文检索、精确过滤、范围查询和聚合。例如排查故障时,可以先限定 service 与时间范围,再筛选 level,最后检索 message 中的关键字。
因此,进入搜索引擎后的日志应当理解为“描述一次事件的结构化文档”。后续的 Index 设计、Mapping、查询和可视化,实际上都围绕这些文档及其字段展开。