
可观测性与稳定性 / 系统课时
Replica 解决什么问题
Replica 解决什么问题
Primary Shard 把索引数据拆开后,如果某个节点故障而数据只有一份,对应分片就可能暂时不可用。Replica 通过保存 Primary Shard 的副本,让集群可以在节点失效时继续提供数据,并把部分读取请求分散到更多分片副本上。
学习目标
- 理解 Replica Shard 与 Primary Shard 之间的复制关系
- 说明副本如何参与节点故障后的可用性恢复
- 区分 Replica 对读取扩展的帮助与它无法解决的问题
Replica 复制的是什么
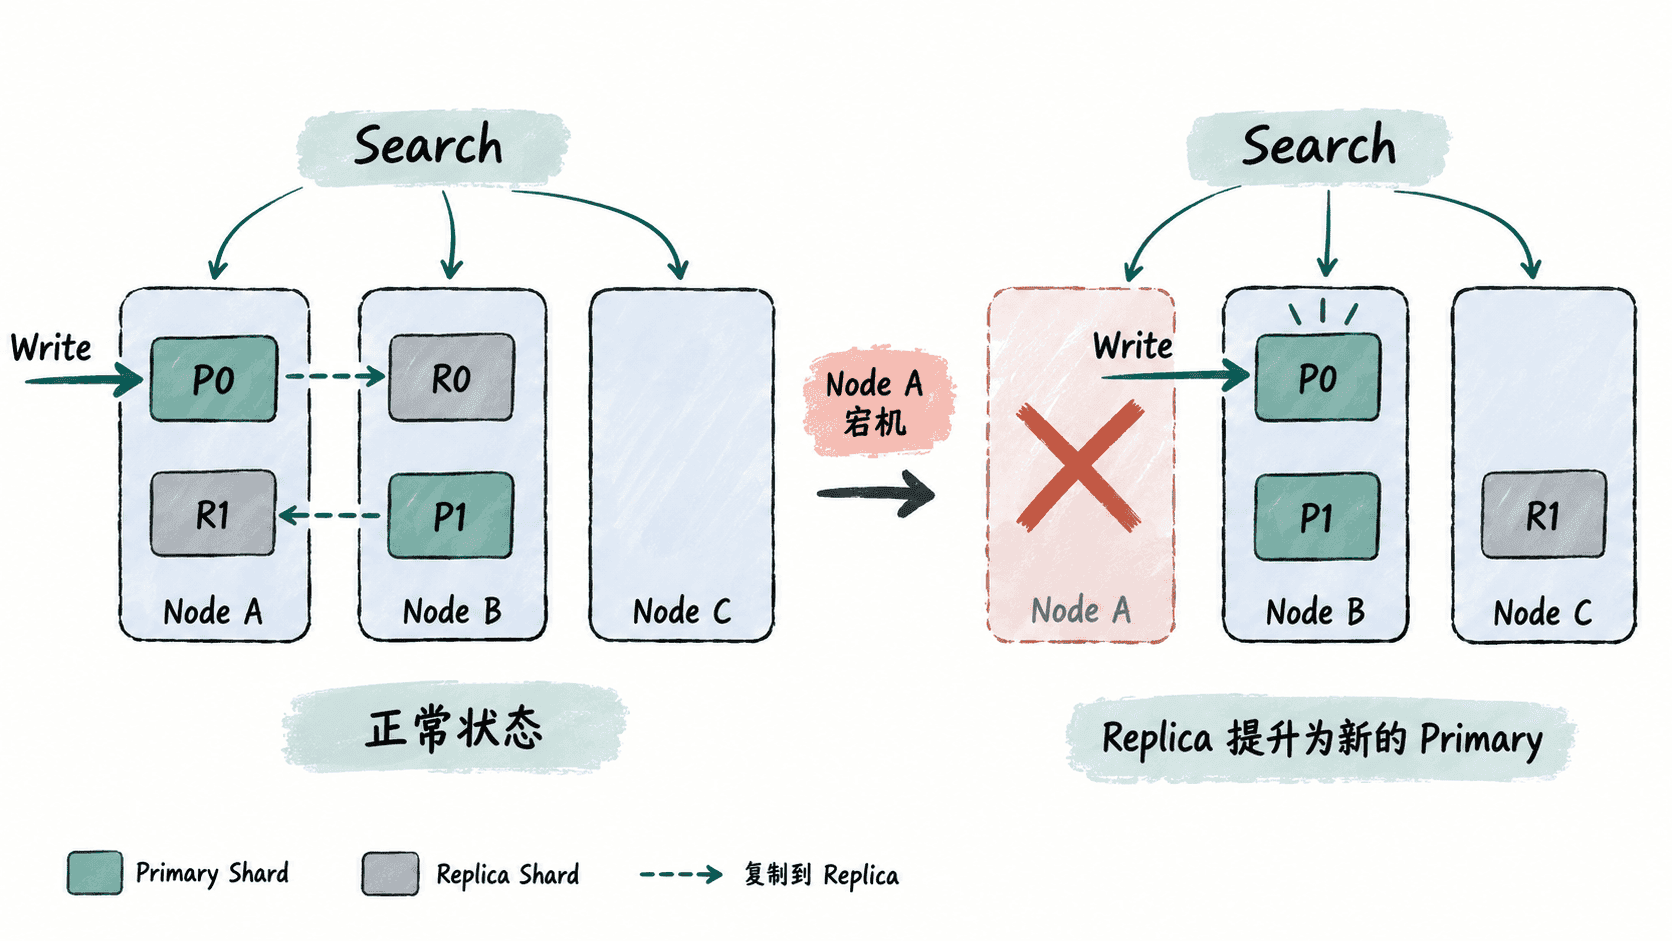
一个 Replica Shard 对应某个 Primary Shard 的副本。写入首先由目标 Primary Shard 处理,然后相关变更会复制到它的 Replica,使这些分片保存相同的逻辑数据。
例如索引包含 Primary Shard P0 和 P1,并为每个 Primary 配置一个 Replica,那么集群还会有 R0 和 R1。为了避免单机故障同时带走原始数据和副本,搜索引擎通常不会把同一分片的 Primary 与 Replica 分配到同一个节点。
节点故障时 Replica 如何发挥作用
假设 P0 位于 Node A,而它的 Replica R0 位于 Node B。当 Node A 故障后,集群发现 P0 不再可用,可以把保存同一份数据的 R0 提升为新的 Primary。这样应用仍然可以通过索引名称访问数据,而不需要知道具体哪个节点发生了角色变化。
恢复并不意味着故障完全没有影响。集群需要检测节点离线、重新选定 Primary,并在有足够资源时重新建立缺失的 Replica。在这段过程中,副本是否足够、剩余节点是否健康以及分片能否重新分配,都会影响实际可用性。
Replica 为什么还能扩展读取
搜索请求不一定只能由 Primary Shard 执行。由于 Replica 保存相同的数据,读取请求可以在某个 Primary 及其 Replica 之间分配,从而让更多节点共同承担查询负载。
这对集中日志场景尤其有用:日志写入持续发生的同时,开发人员、告警系统和仪表盘可能不断执行搜索与聚合。增加 Replica 可以提供更多可用于读取的分片副本,在节点资源充足且查询确实成为瓶颈时,有机会提高整体读取吞吐。
但写入不会因为 Replica 更多就变得更轻。每次写入还需要把变更复制给更多副本,因此 Replica 数量增加会消耗额外磁盘空间、网络带宽和写入处理能力。
Primary 与 Replica 要一起看
Primary Shard 决定索引数据被拆成多少份,Replica 则决定这些分片额外保存多少份副本。两者解决的问题不同:前者关注数据分布与横向扩展,后者关注冗余、故障接管和读取扩展。
规划日志索引时,如果只增加 Primary 而没有 Replica,数据虽然能分散到多台机器,却缺少分片级冗余;如果配置大量 Replica,则会显著增加存储与复制成本。因此应根据节点数量、故障容忍目标、读写比例和磁盘预算共同决定副本数量,而不是把 Replica 当成免费的性能开关。