
可观测性与稳定性 / 系统课时
日志 Agent 为什么要部署在主机旁
日志 Agent 为什么要部署在主机旁
集中日志首先要解决的不是“把日志传多远”,而是稳定拿到刚写入文件的新增内容。把 Agent 部署在产生日志的主机或节点旁,可以让采集直接依赖本地文件变化,再把记录独立转发到远端平台。
学习目标
- 解释日志 Agent、日志文件与集中日志平台之间的职责边界
- 理解为什么本地采集比远程直接读取日志文件更稳健
- 用一个最小实验观察“文件新增一行,采集端立即看到一行”的行为
Agent 实际站在数据链路哪里
应用进程只负责把运行记录写入本机文件,例如 /var/log/myapp/app.log。Agent 位于同一主机或同一节点,持续跟踪文件偏移量;发现新行后,再通过网络把事件发送到集中日志平台。这样,应用是否能继续写本地日志,不需要和远端检索平台的瞬时可用性绑在一起。
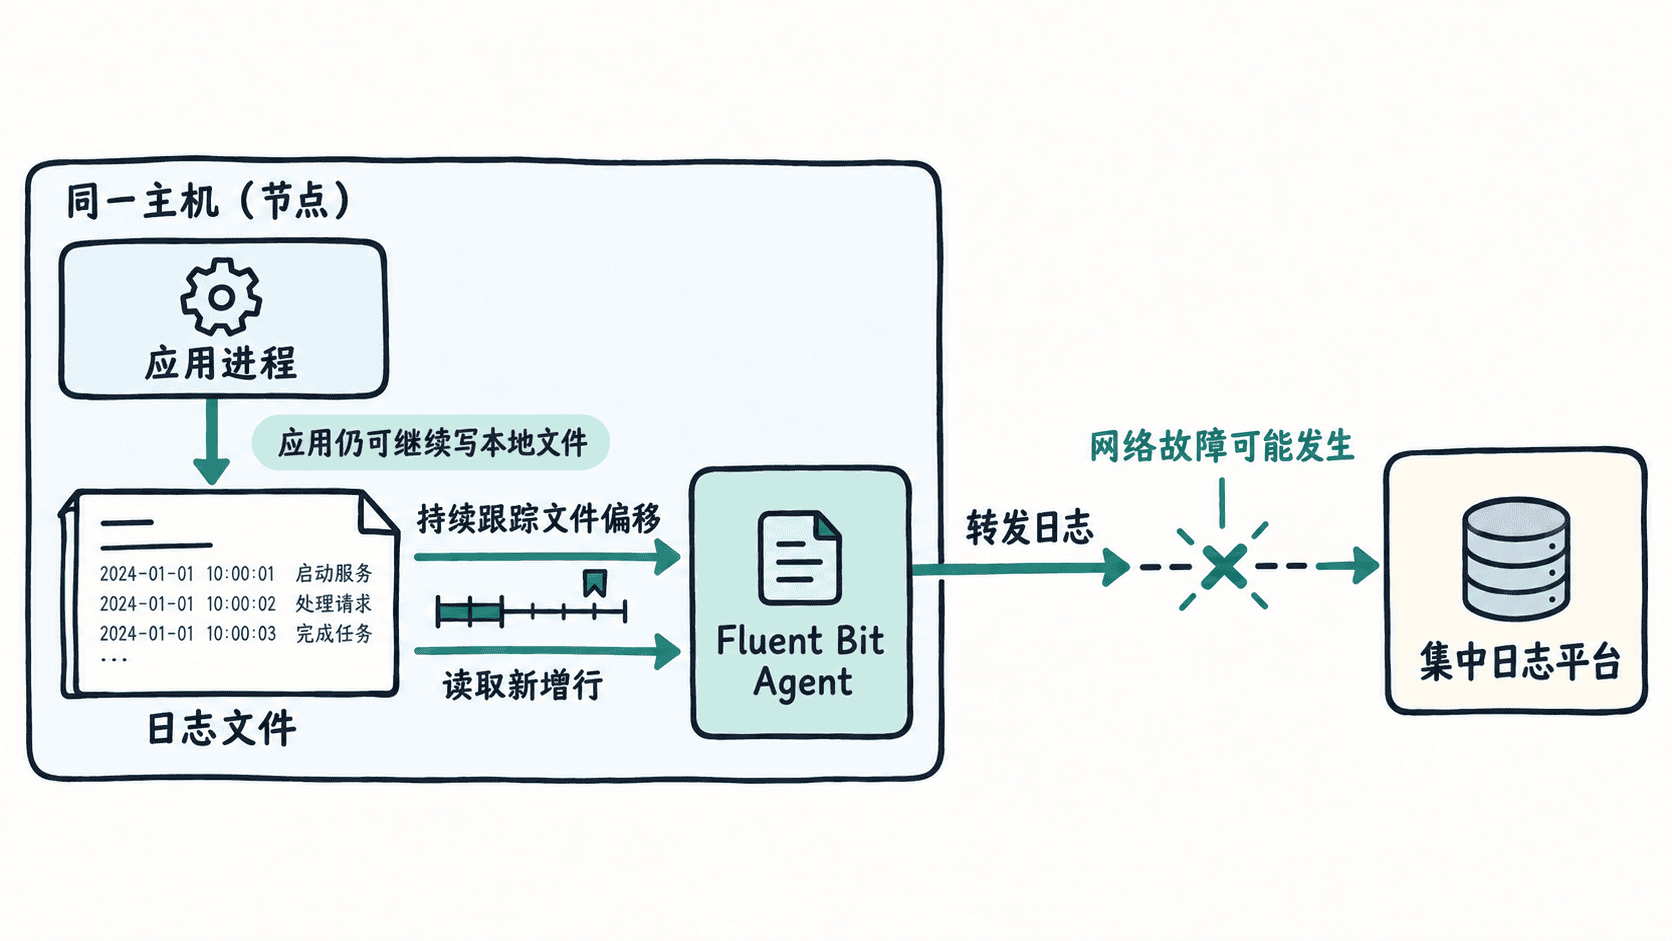
“部署在旁”强调的是数据源附近,不一定要求和业务进程放在同一个进程里。虚拟机环境常见做法是每台主机运行一个 Agent;容器平台则常按节点部署,让 Agent 读取该节点上的容器日志。
为什么不让中心服务直接远程读文件
如果集中平台跨网络直接读取每台机器上的日志文件,采集会同时依赖文件共享、网络连通性、权限和远端服务状态。任何一层短暂抖动,都可能表现为读不到文件、重复读取或采集延迟。
主机旁 Agent 把问题拆成两段:前半段只关心本地文件有没有新增内容,后半段负责转发。Agent 还可以保存读取位置,在重启后继续从已知偏移附近恢复,而不是让中心系统重新猜测每个文件读到了哪里。
这种设计还有一个运维优势:业务应用无需知道 Elasticsearch、OpenSearch、Loki 或其他后端的地址。更换集中日志平台时,通常只调整 Agent 的输出配置,而不修改业务程序的日志代码。
用本地跟踪验证核心行为
在 Linux 主机上可以先不用任何日志产品,用 tail -F 模拟 Agent 对本地文件的持续跟踪。下面的命令创建临时日志文件,启动跟踪,再追加一条记录,最后清理现场。
set -e

workdir="$(mktemp -d)"
log_file="$workdir/app.log"
: > "$log_file"

tail -n 0 -F "$log_file" &
tail_pid=$!

sleep 1
printf '%s\n' 'order_id=1001 status=created' >> "$log_file"
sleep 2

kill "$tail_pid"
wait "$tail_pid" 2>/dev/null || true
rm -rf "$workdir"
预期输出
order_id=1001 status=created这个实验刻意只观察“新增内容”而不是读取历史文件:文件已经存在,跟踪程序记住当前位置,随后应用追加一行,采集端只拿到这一行。真实 Agent 会在此基础上增加偏移持久化、解析、过滤、缓冲、重试和远端输出。
部署得近,不等于和应用强耦合
Agent 适合以独立系统服务或节点级进程运行。这样即使业务应用重启,Agent 仍能继续跟踪文件;Agent 升级或修改输出目的地时,也不要求重新构建业务应用。
权限也应保持最小化:Agent 只需要读取指定日志目录,以及写入自身状态或缓冲目录。不要为了“省事”让采集进程获得整个主机的无关文件权限。
什么时候这种部署最有价值
当日志首先落到本地文件、机器数量持续增长、远端平台偶尔会出现网络抖动时,主机旁 Agent 能把“日志产生”和“日志传输”解耦。后续使用 Fluent Bit 时,Tail 输入插件承担的正是这段本地跟踪职责:盯住目标文件,识别新增记录,再交给后续输出链路。