
可观测性与稳定性 / 系统课时
match 查询为什么适合消息内容
match 查询为什么适合消息内容
日志里的 message 往往是一整句错误描述,例如连接超时、调用失败或资源不存在。直接做精确值匹配很容易漏掉结果;match 会先分析查询文本,再按词项去匹配 text 字段,因此更适合从自然语言日志中找“包含这些含义词”的消息。
学习目标
- 理解
match与text字段分析过程的关系 - 能用
operator控制多词查询的宽松或严格程度 - 能判断何时应改用
term等精确匹配查询
match 的核心是先分析再匹配
假设 message 映射为 text。搜索 connection timeout 时,match 不会把整串字符当成一个不可拆分的值,而是使用字段对应的分析器处理查询文本,再用得到的词项构造查询。Elastic 官方文档也明确说明,match 是全文检索的标准查询,输入文本会在匹配前被分析。([Elastic][1])
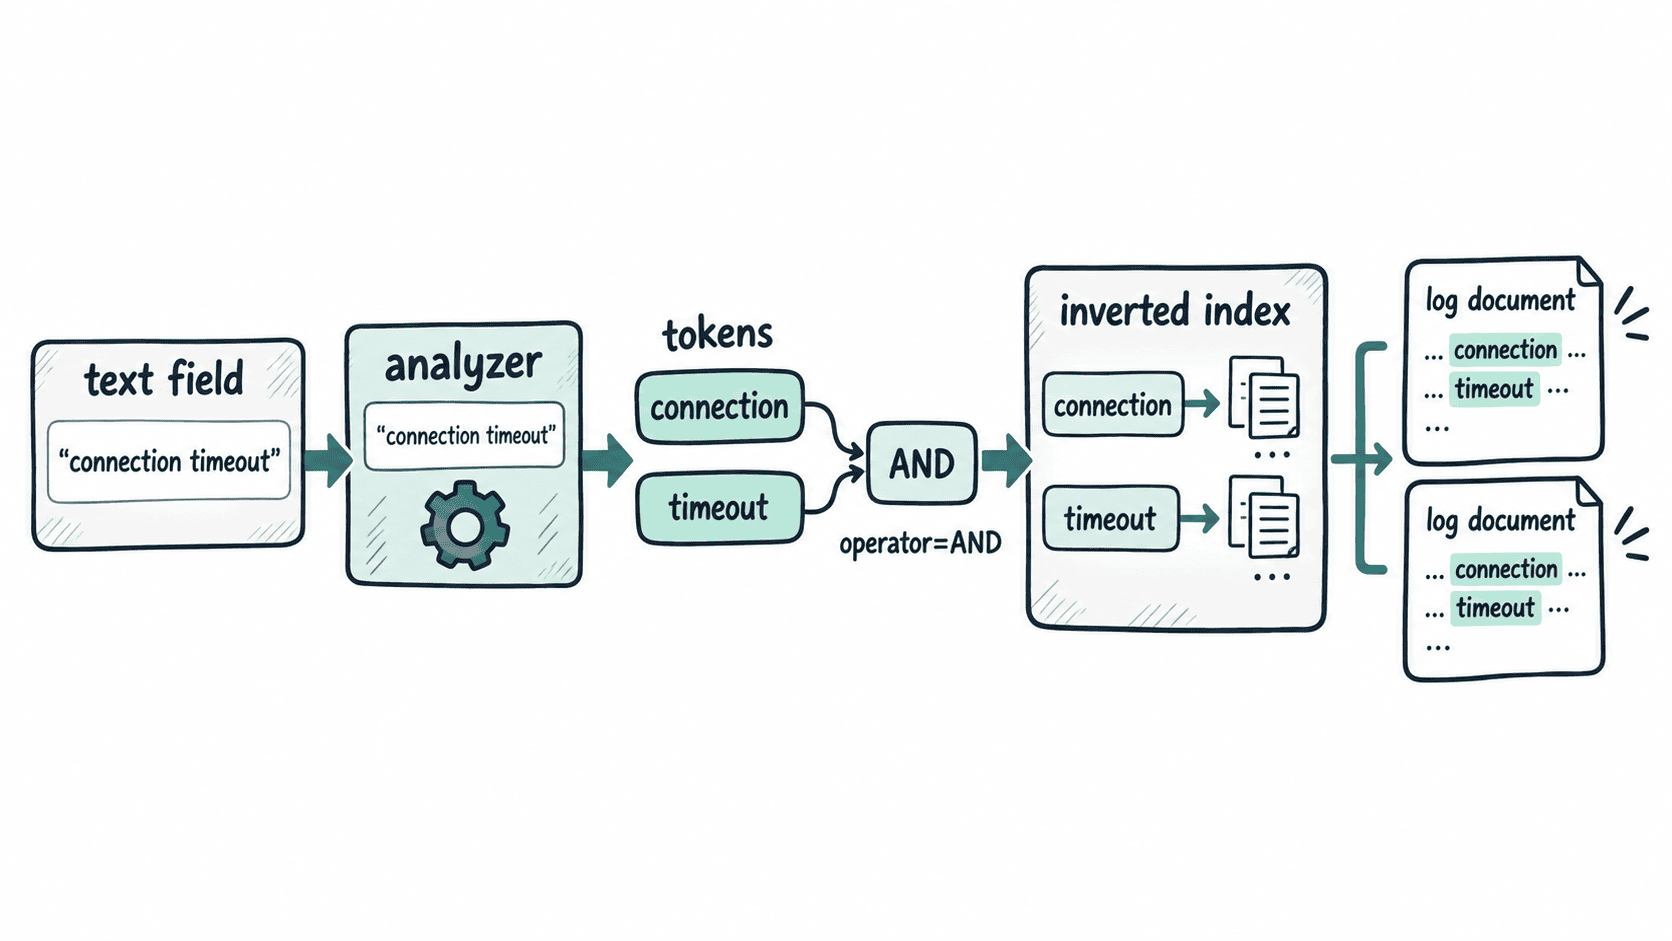
这正是日志消息的常见需求:你通常关心“这条错误描述里是否出现了 timeout、connection、refused 之类的词”,而不是整条 message 是否逐字符等于某个固定字符串。
用一个最小索引验证
下面的命令会创建一个演示索引,写入三条日志,再用 match 搜索同时包含 connection 和 timeout 的消息。示例假设 Elasticsearch 可通过 http://localhost:9200 访问。
curl -s -X DELETE "http://localhost:9200/logs-match-demo" >/dev/null || true
curl -s -X PUT "http://localhost:9200/logs-match-demo" -H "Content-Type: application/json" -d '{"mappings":{"properties":{"message":{"type":"text"},"service":{"type":"keyword"}}}}' >/dev/null
curl -s -X POST "http://localhost:9200/logs-match-demo/_bulk?refresh=wait_for" -H "Content-Type: application/x-ndjson" --data-binary @- >/dev/null <<'NDJSON'
{"index":{}}
{"message":"Database connection timeout after 30 seconds","service":"checkout"}
{"index":{}}
{"message":"User login succeeded","service":"auth"}
{"index":{}}
{"message":"Connection refused while calling payment service","service":"checkout"}
NDJSON
curl -s -X GET "http://localhost:9200/logs-match-demo/_search?filter_path=hits.total,hits.hits._source" -H "Content-Type: application/json" -d '{"query":{"match":{"message":{"query":"connection timeout","operator":"and"}}}}'
预期输出
{"hits":{"total":{"value":1,"relation":"eq"},"hits":[{"_source":{"message":"Database connection timeout after 30 seconds","service":"checkout"}}]}}operator: "and" 要求分析后的查询词项都满足,所以第三条只包含 connection 的日志不会返回。若省略 operator,match 默认使用 OR,查询会更宽松;也可以用 minimum_should_match 做介于两者之间的控制。([Elastic][1])
不要把全文搜索和精确值搜索混在一起
match 适合 message、stack_trace 摘要等自然语言 text 字段;而 service、host.name、trace.id、固定错误码等通常需要精确匹配。对已分析的 text 字段直接使用 term 往往得不到预期结果,Elastic 也建议在 text 字段上优先使用 match。([Elastic][2])
例如,要把消息内容与服务名一起过滤,可以让 message 使用 match,让 service 使用精确条件。这样既保留全文检索能力,也不会把结构化字段当自然语言处理。
什么时候调整严格程度
用户输入完整错误描述但只记得几个关键词时,默认 OR 往往更容易找到候选日志;排障时如果必须同时出现多个关键症状,可以使用 operator: "and"。当关键词较多、又不希望全部强制命中时,再考虑 minimum_should_match。
核心判断很简单:需要对自然语言做分词后检索,就优先考虑 match;需要比较一个结构化字段的准确值,就不要依赖 match 的全文分析语义。