
可观测性与稳定性 / 系统课时
ELK 和 OpenSearch Stack 有何关系
ELK 和 OpenSearch Stack 有何关系
搭建集中日志平台时,经常会同时看到 ELK、Elastic Stack 和 OpenSearch Stack。它们解决的问题高度相似,但组件名称、项目来源和生态并不完全相同。理解各组件承担的职责,才能在选型和迁移时避免把它们误认为完全等价的产品组合。
学习目标
- 说清 Elasticsearch、Logstash、Kibana 在 ELK 中的职责
- 理解 OpenSearch、Data Prepper、OpenSearch Dashboards 的组件定位
- 判断两套技术栈中哪些组件可以按职责类比,哪些不能简单一一替换
两套技术栈解决的是同一类问题
ELK 最初由 Elasticsearch、Logstash、Kibana 三个名字组成。集中日志场景中,Logstash 负责接收、解析和转换数据,Elasticsearch 负责索引与检索,Kibana 负责查询结果展示、仪表盘和分析。后来 Elastic 的产品范围继续扩大,因此更常见的名称是 Elastic Stack。
OpenSearch 项目则围绕 OpenSearch 搜索与分析引擎构建生态。OpenSearch Dashboards 提供可视化与交互式分析能力,Data Prepper 可以承担数据接收、处理和输出工作。对于日志平台,可以把三类职责概括为“采集与处理 → 存储与检索 → 查询与可视化”。
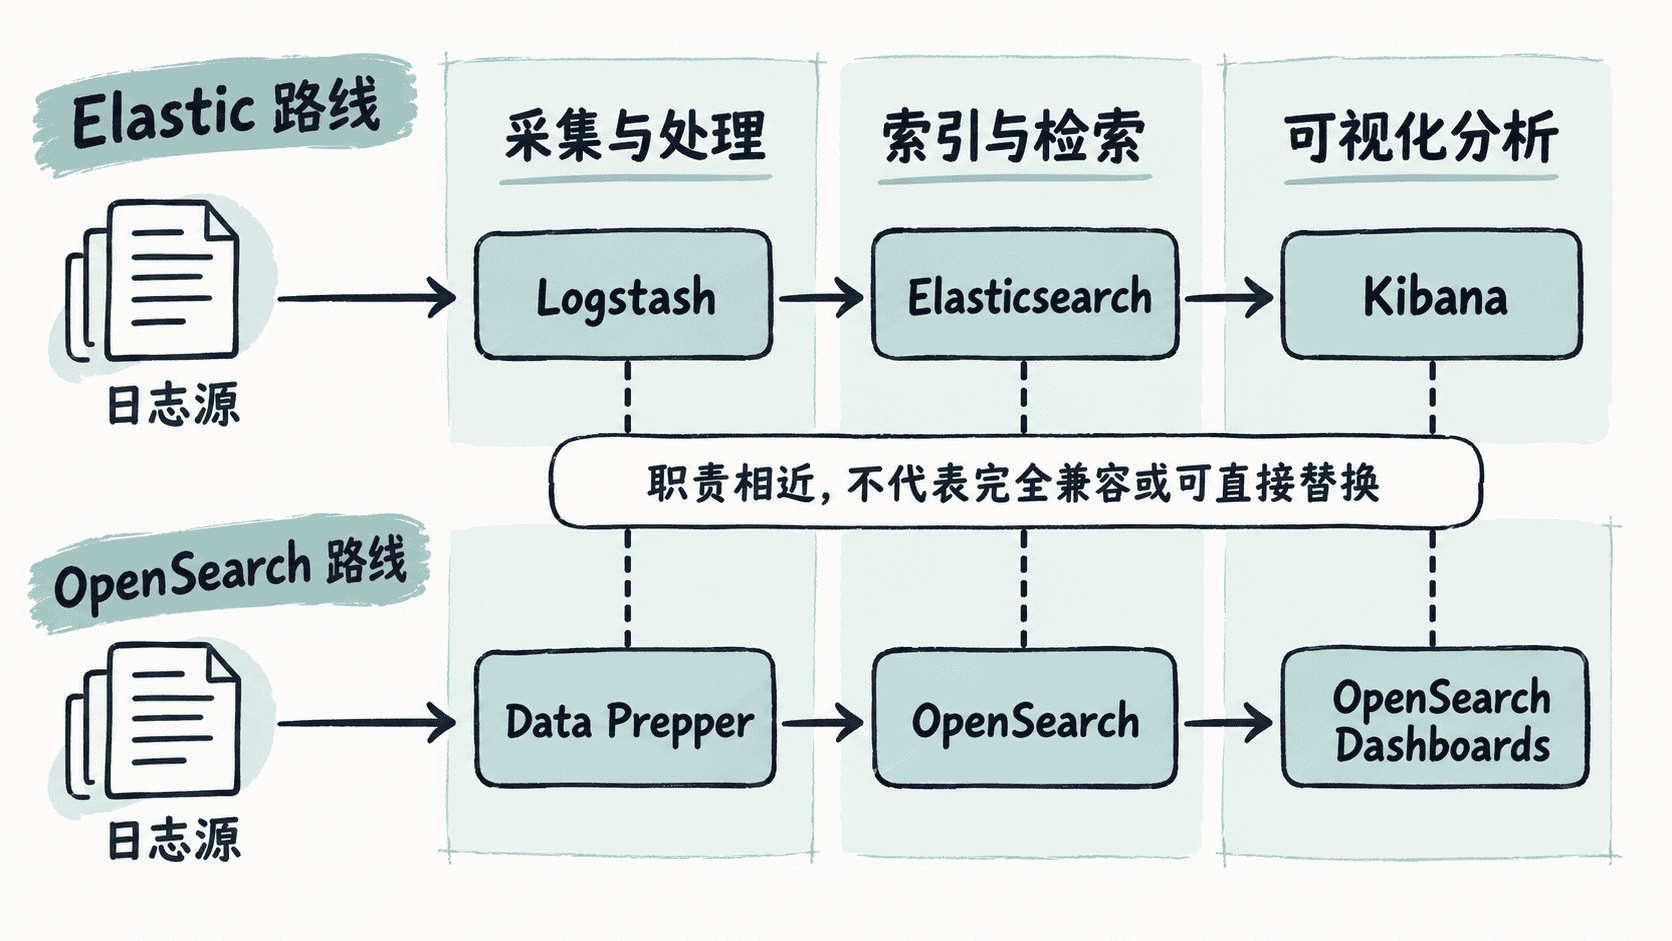
组件可以按职责理解,但不是简单换名字
两套技术栈最容易形成以下心智模型:
| 主要职责 | Elastic 体系常见组件 | OpenSearch 体系常见组件 |
|---|---|---|
| 数据接收、过滤、转换 | Logstash | Data Prepper |
| 建立索引并执行搜索分析 | Elasticsearch | OpenSearch |
| 查询、图表与仪表盘 | Kibana | OpenSearch Dashboards |
这个表格表达的是职责对应关系,不是二进制兼容关系。例如 Logstash 拥有成熟的插件生态和自己的 pipeline 配置语法,Data Prepper 也有独立的处理器、Source、Sink 与配置方式,因此不能把 Logstash 配置文件直接改个组件名就交给 Data Prepper 运行。
同样,应用程序从 Elasticsearch 切换到 OpenSearch 时,也不应仅根据 REST API 看起来相似就假定所有客户端、插件、查询特性和版本行为都兼容。实际迁移必须核对目标版本的 API、客户端和插件支持范围。
日志平台不必只使用这六个组件
真实环境往往会把采集端与中心处理端拆开。例如服务器可以运行 Fluent Bit、Filebeat 或其他 Agent,把日志发送到消息队列或处理服务,再写入搜索集群。因此,“ELK”或“OpenSearch Stack”更适合作为架构家族名称,而不是要求每套部署必须同时运行表格中的全部组件。
选择组件时应从职责出发:先确认谁采集日志、谁负责解析和缓冲、数据最终写到哪里、用户通过什么界面检索。只要这条数据链路明确,就不会因为产品名称相似而错误地认为两套技术栈可以无条件互换。