
可观测性与稳定性 / 系统课时
集群 Green、Yellow 和 Red 表示什么
集群 Green、Yellow 和 Red 表示什么
当日志检索集群变色时,先别把 Green、Yellow、Red 当成笼统的“好、中、坏”。这三个状态直接反映 Primary Shard 与 Replica Shard 是否成功分配;看懂分片分配关系,才能判断是冗余下降,还是已经出现数据不可用。
学习目标
- 根据 Primary、Replica 的分配情况判断 Green、Yellow、Red。
- 用集群健康与分片接口定位未分配的是主分片还是副本分片。
- 区分“还能读写”和“已经影响数据可用性”的风险级别。
先把颜色还原成分片状态
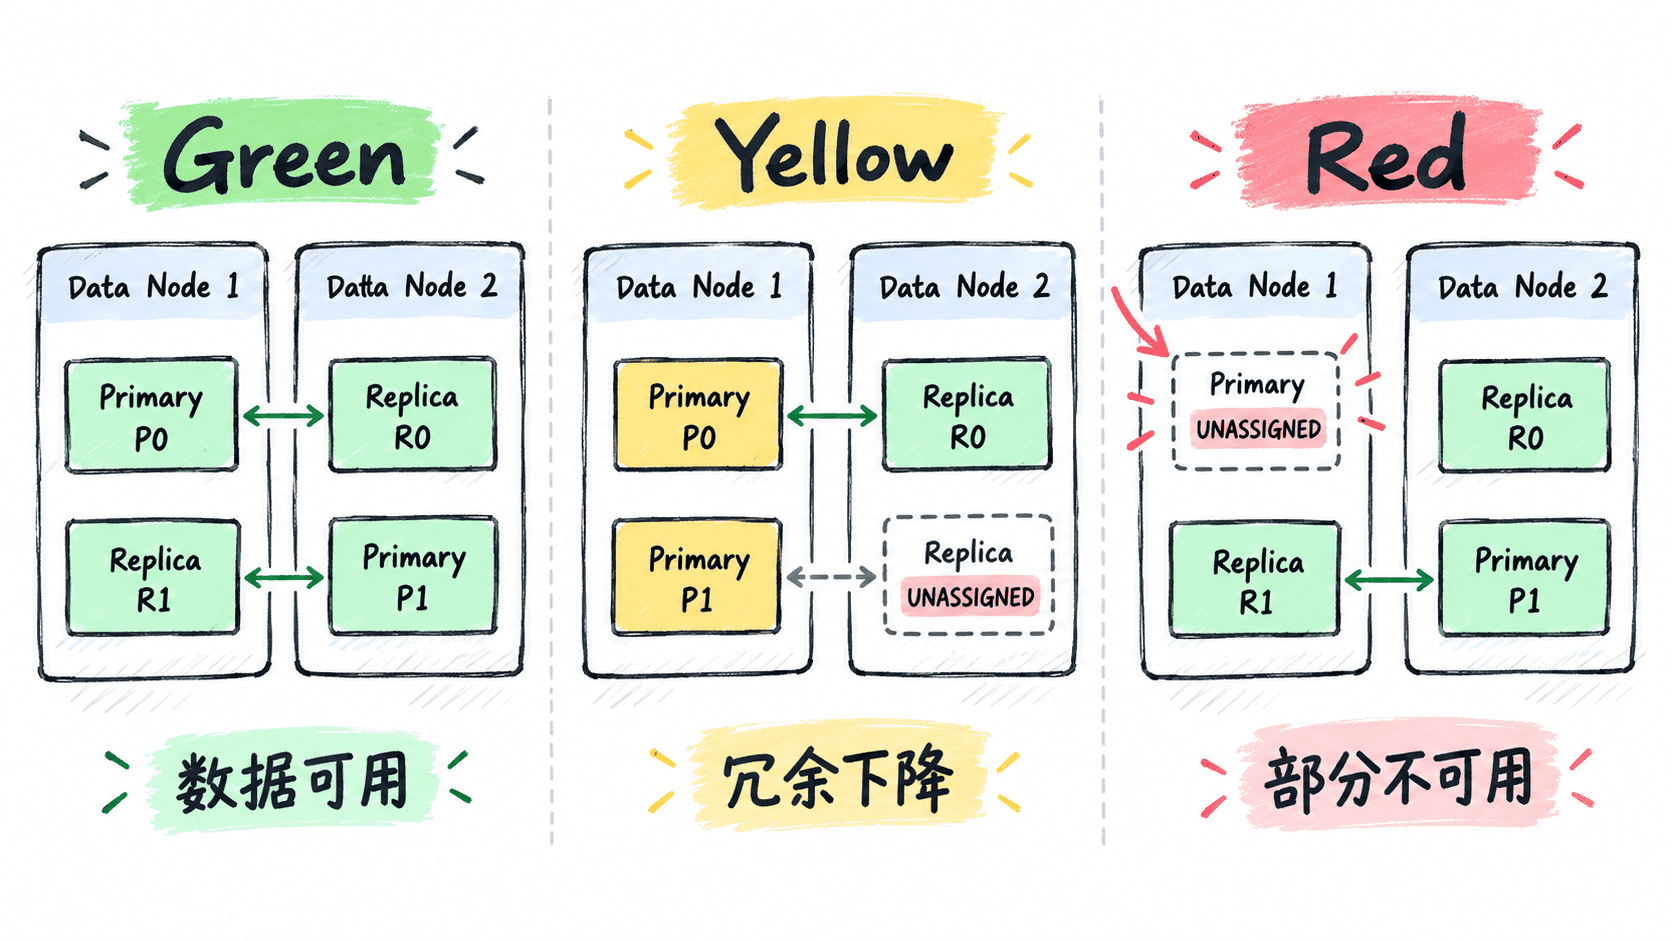
Elasticsearch 的健康状态是由分片分配决定的,而且整体状态取最差结果。Green 表示所有 Primary 与 Replica 都已分配;Yellow 表示 Primary 都已分配,但至少一个 Replica 未分配;Red 表示至少一个 Primary 未分配,因此对应数据可能无法搜索或写入。
| 状态 | Primary Shard | Replica Shard | 主要含义 |
|---|---|---|---|
| Green | 全部分配 | 全部分配 | 数据可用,副本冗余也满足配置 |
| Yellow | 全部分配 | 至少一个未分配 | 当前主分片仍可服务,但容错能力下降 |
| Red | 至少一个未分配 | 可能同时未分配 | 部分数据不可用,相关搜索或写入可能失败 |
用接口确认是哪类分片没分配
只看集群颜色不够,值班时要同时看 unassigned_primary_shards 和 _cat/shards。下面以启用 HTTPS 与基础认证的 Elasticsearch 为例;实际节点数量、分片数量和索引名会不同。
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/_cluster/health?filter_path=status,active_primary_shards,active_shards,unassigned_shards,unassigned_primary_shards"
curl -sS -u <USER>:<PASSWORD> "https://<HOST>:<PORT>/_cat/shards?v=true&h=index,shard,prirep,state,node,unassigned.reason&s=state"
预期输出
{"status":"yellow","active_primary_shards":<COUNT>,"active_shards":<COUNT>,"unassigned_shards":<COUNT>,"unassigned_primary_shards":0}
index        shard prirep state      node       unassigned.reason
logs-<DATE>  0     r      UNASSIGNED            <REASON>
logs-<DATE>  0     p      STARTED    <NODE>
prirep 为 p 代表 Primary,为 r 代表 Replica。若健康状态是 Yellow 且 unassigned_primary_shards 为 0,说明主分片仍在;若该值大于 0,则已经进入 Red 风险,需要优先处理主分片恢复。
Yellow 不等于可以长期忽略
单节点集群配置了 Replica 时,副本不能和对应 Primary 放在同一节点,因此会长期 Yellow。这种状态不一定意味着当前查询立刻失败,但它表示冗余目标没有实现;节点再发生故障时,数据可用性风险会明显上升。
多节点集群出现 Yellow,则继续查节点是否离线、磁盘分配阈值、分配过滤或分片数量是否满足约束。若无法从分片列表直接看出原因,可再使用 _cluster/allocation/explain 针对未分配分片获取分配决策,而不是靠重启节点碰运气。
Red 要先确定影响范围
Red 不是“整个集群所有数据都不可用”,而是至少存在一个未分配 Primary。先从 _cat/shards 找到具体索引和分片,再判断这些索引是否属于当前日志写入目标、Kibana 依赖的系统索引或关键查询数据。
处理优先级可以归纳为:先恢复 Primary,再恢复 Replica,最后追求 Green。颜色只是入口;真正决定处置动作的是哪个分片未分配、为什么未分配,以及它承载的数据是否处于关键链路。