
可观测性与稳定性 / 系统课时
收到接口报错应该先查什么
收到接口报错应该先查什么
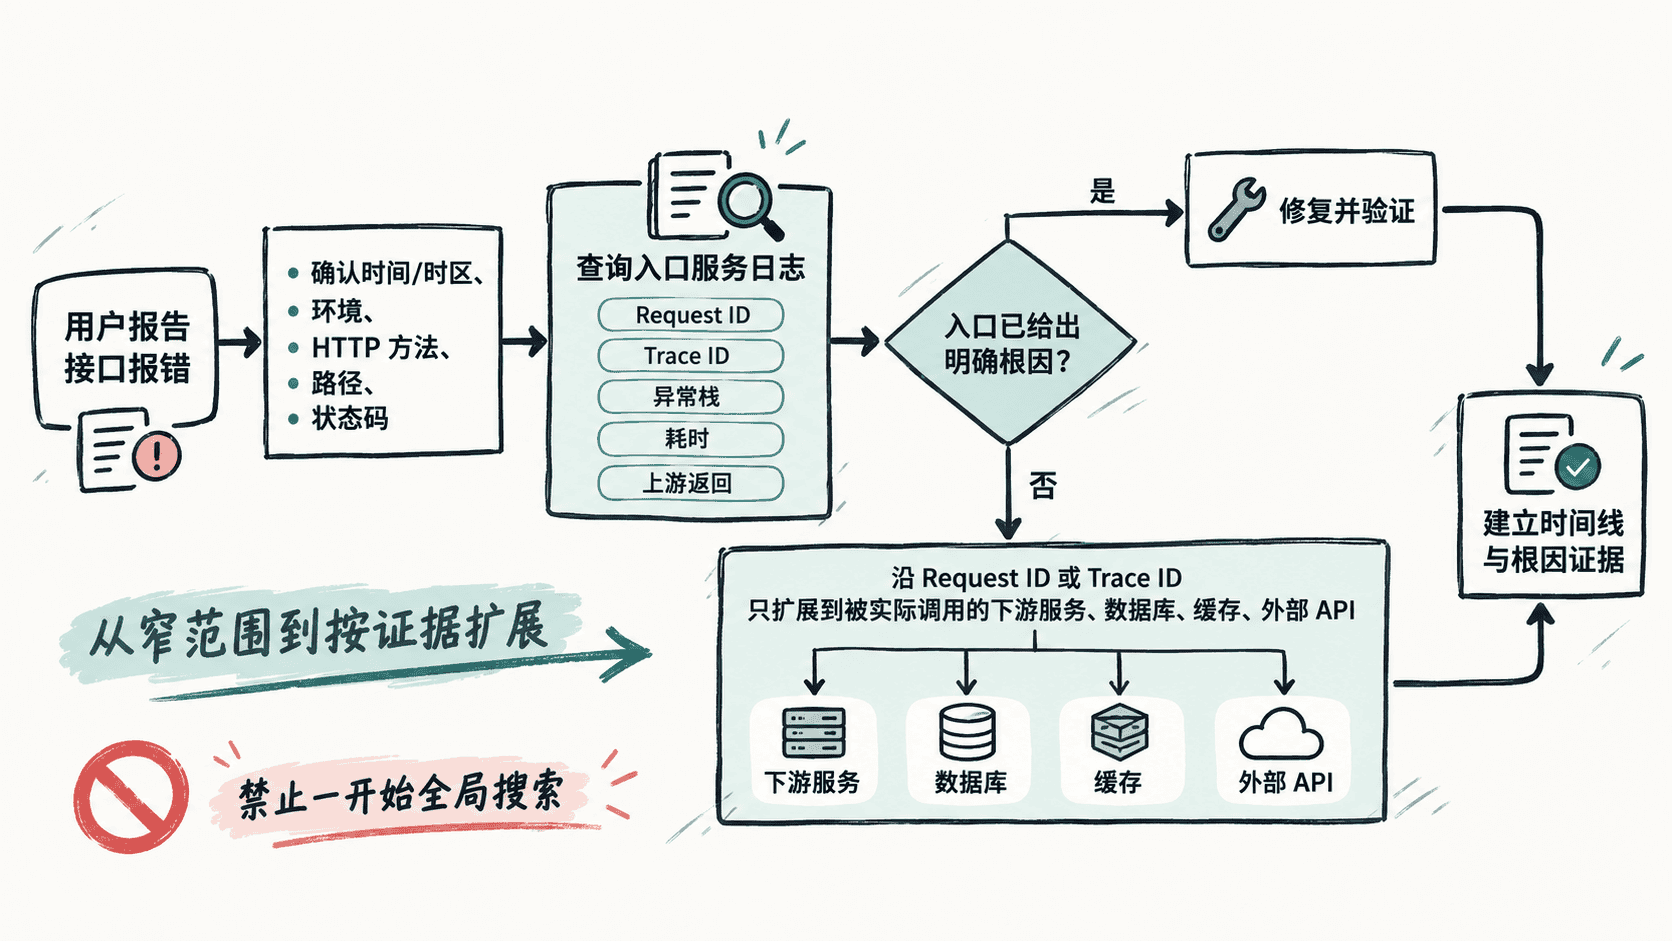
线上接口出现 5xx、超时或业务错误时,最容易浪费时间的做法是直接在所有服务里搜“error”。更高效的起点是先锁定故障时间、请求路径和入口服务,再利用 Request ID 或 Trace ID 沿调用链扩展。本篇给出一套可重复的集中日志排查顺序。
学习目标
- 能从故障时间、接口路径和状态码快速缩小日志搜索范围
- 能优先定位入口服务的关键日志,而不是无目标地全局搜索
- 能根据日志证据决定何时继续检查数据库、缓存或下游服务
先把故障范围缩到一个窗口
收到“接口报错”后,先补齐最小定位信息:发生时间及其时区、环境、HTTP 方法、请求路径、返回状态码,以及可用的 Request ID、Trace ID 或业务 ID。没有这些条件,日志量越大,误命中越多。
时间窗口不要一开始就拉得很宽。若用户能给出 14:32 左右的报错时间,可以先查前后 2~5 分钟;确认入口日志后,再根据实际调用耗时向前后扩展。这样既减少无关日志,也能避免因为服务器时区或采集延迟造成几秒到几十秒的偏差。
从入口服务开始查
入口服务最接近客户端请求,通常能同时看到方法、路径、状态码、总耗时和关联 ID。下面示例假设集中日志索引为 logs-*,字段名为 timestamp、service、method、path、status、request_id 和 message;实际环境应按自己的 Mapping 调整。
curl -s -X POST "http://<HOST>:<PORT>/logs-*/_search?filter_path=hits.hits._source" -H "Content-Type: application/json" -d @- <<'JSON'
{
  "size": 20,
  "sort": [{"timestamp": "asc"}],
  "query": {
    "bool": {
      "filter": [
        {"range": {"timestamp": {"gte": "<TIME>", "lte": "<TIME>"}}},
        {"term": {"service.keyword": "api-gateway"}},
        {"term": {"method.keyword": "POST"}},
        {"term": {"path.keyword": "/checkout"}}
      ]
    }
  }
}
JSON
预期输出
{"hits":{"hits":[{"_source":{"timestamp":"<TIME>","service":"api-gateway","method":"POST","path":"/checkout","status":500,"request_id":"<ID>","message":"upstream request failed"}}]}}<TIME>、<PORT>、<HOST> 和 <ID> 的实际值会随环境变化。若已拿到 request_id,下一轮查询应优先按该 ID 精确检索,因为它通常比“接口路径 + 时间”更能排除并发请求干扰。
什么时候扩大到下游依赖
先看入口日志中有没有明确证据。若入口已经记录参数校验失败、权限拒绝或本服务异常栈,优先处理本服务,不必立即搜索数据库和所有下游。若日志显示“调用 payment 超时”或“数据库连接失败”,再把搜索范围扩展到对应依赖。
扩展时沿关联 ID 和时间顺序走,而不是按服务清单逐个碰运气。重点比较三个时间点:入口收到请求、调用下游、入口返回错误。如果某个下游调用前日志正常、调用后立刻出现超时或异常,它才值得进入下一轮深挖。
排查结束时留下什么证据
一次可复盘的日志排查至少应留下故障请求的绝对时间、入口服务、关联 ID、关键错误日志、实际失败的依赖和最终根因。不要只记录“重启后恢复”,因为这无法解释为什么发生,也无法判断问题是否会再次出现。
修复后用同一接口重新发起请求,并在集中日志中确认新的请求获得新的关联 ID、入口返回预期状态、下游调用耗时恢复正常且不再出现原异常。这样“接口恢复”与“根因已消失”才能由同一条日志链路闭环验证。