
可观测性与稳定性 / 系统课时
日志仪表盘应该回答什么问题
日志仪表盘应该回答什么问题
日志 Dashboard 的价值不是“把日志画出来”,而是让值班人员在几十秒内回答两个问题:服务现在是否异常,以及异常主要集中在哪里。设计时先确定问题,再决定指标、分组和下钻路径,避免堆满图表却无法支持判断。
学习目标
- 把日志 Dashboard 拆成“判断异常”和“定位异常”两层问题
- 选择能支撑判断的总量、错误量、错误率与服务维度
- 设计从概览到日志明细的最短下钻路径
先定义仪表盘要回答的问题
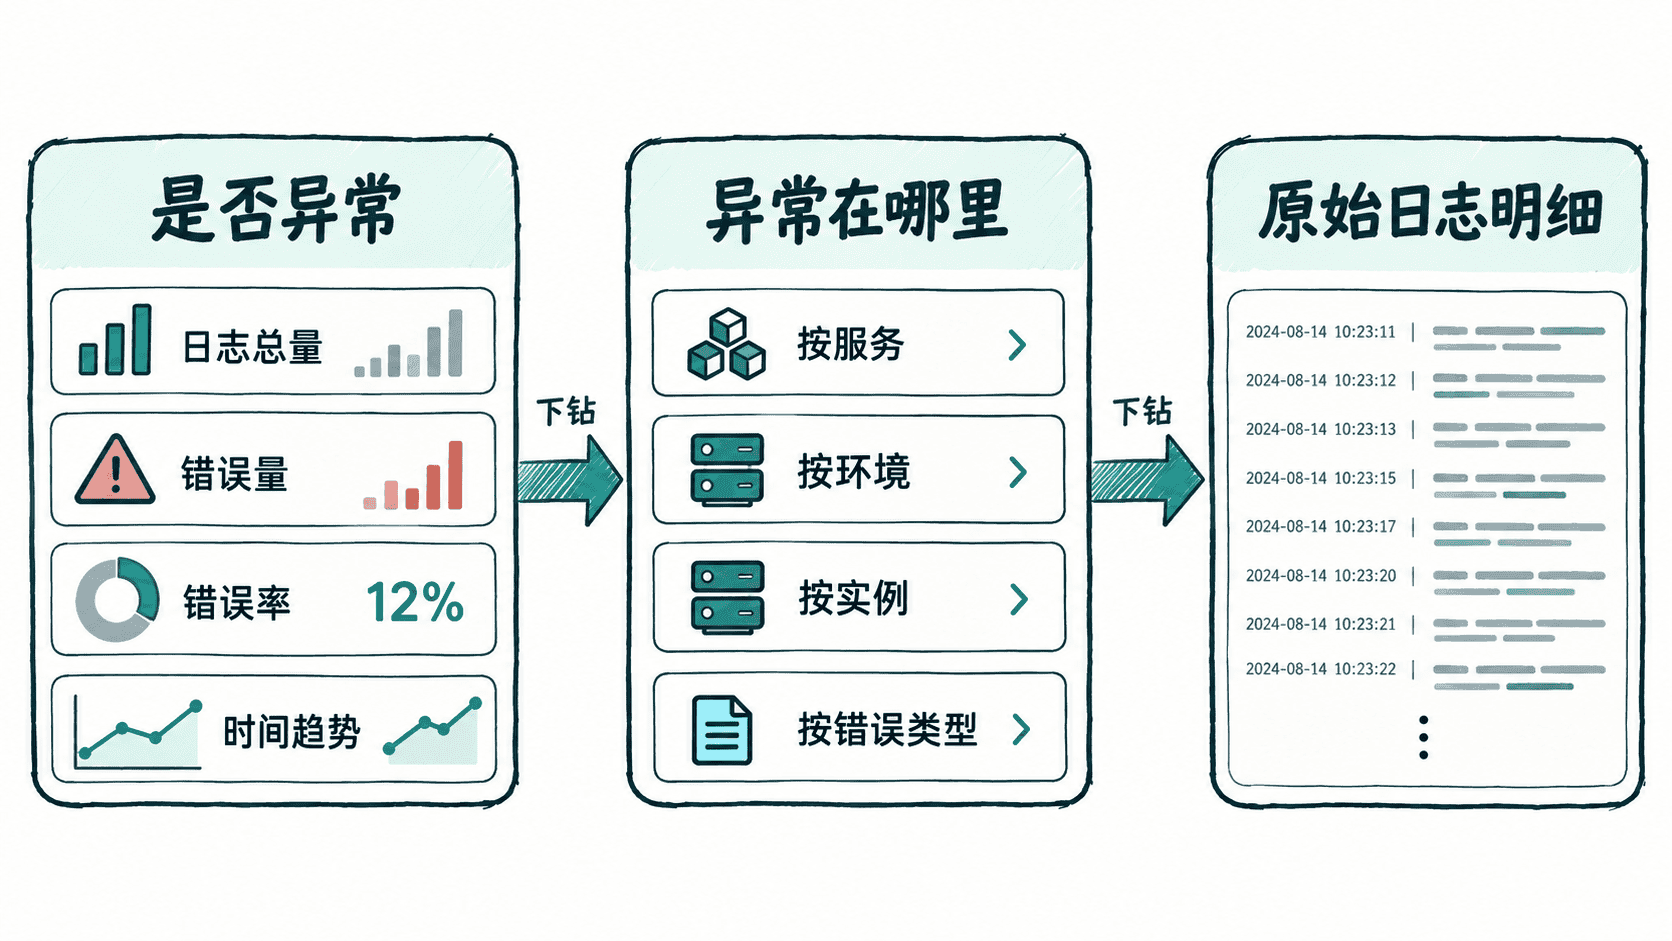
第一层只回答“现在有没有异常”。适合放在最上方的信号通常是日志总量、错误日志量、错误率,以及它们相对最近一段时间的变化。这里的目标是快速发现偏离,不要一开始就展示几十个服务或错误码。
第二层回答“异常在哪里”。当错误率升高后,页面应能继续按服务、环境、实例或错误类型拆分,并最终跳到原始日志。这样使用者可以从全局异常一路缩小范围,而不必重新组织查询条件。
用最小数据验证问题设计
下面的可运行示例用一组日志事件模拟首页概览。它同时计算全局错误率和各服务错误率,分别对应“是否异常”和“异常集中在哪个服务”。
from collections import Counter

events = [
    {"service": "checkout", "level": "INFO"},
    {"service": "checkout", "level": "ERROR"},
    {"service": "checkout", "level": "INFO"},
    {"service": "payments", "level": "ERROR"},
    {"service": "payments", "level": "ERROR"},
    {"service": "payments", "level": "INFO"},
]

total = len(events)
errors = sum(1 for event in events if event["level"] == "ERROR")
service_total = Counter(event["service"] for event in events)
service_error = Counter(
    event["service"] for event in events if event["level"] == "ERROR"
)

print(f"events={total} errors={errors} error_rate={errors / total:.1%}")
for service in sorted(service_total):
    rate = service_error[service] / service_total[service]
    print(
        f"{service}: events={service_total[service]} "
        f"errors={service_error[service]} error_rate={rate:.1%}"
    )
预期输出
events=6 errors=3 error_rate=50.0%
checkout: events=3 errors=1 error_rate=33.3%
payments: events=3 errors=2 error_rate=66.7%
这个例子里,全局 50% 的错误率说明需要关注,而按服务拆分后可以马上看到 payments 更突出。真实日志平台只需把内存统计替换成聚合查询,Dashboard 的问题结构并不改变。
面板应该按判断顺序排列
概览区优先放能说明当前状态的少量指标和趋势;定位区再放服务、环境或错误类型的分组。只有当某个维度确实用于排障时才值得常驻,否则应留给筛选器或下钻页面。
一个实用的阅读顺序是:先看总量与错误率是否偏离,再看趋势发生在什么时间,随后按服务或环境拆分,最后查看具体错误日志。这个顺序把“发现、定位、取证”串成一条路径。
避免看起来丰富但无法决策
只展示日志总量而没有错误率,会把正常流量增长误判为故障;只展示 Top N 错误而没有时间趋势,又难以判断问题是否仍在持续。服务数量很多时,也不要把所有服务同时画成折线,否则异常信号会被视觉噪声淹没。
一个合格的日志 Dashboard 不需要覆盖所有日志字段,而要让使用者先确认异常,再缩小范围,并能顺畅进入原始日志验证判断。