
可观测性与稳定性 / 系统课时
怎样判断异常是个例还是批量发生
怎样判断异常是个例还是批量发生
找到一条异常后,下一步不是立即重启服务,而是判断它是单次偶发、单实例故障,还是正在扩散的系统性问题。本节从时间趋势、服务分布和实例分布三个维度统计同类错误,帮助你确定故障范围和后续排查方向。
学习目标
- 能定义“同类错误”的稳定筛选条件,避免被动态文本拆散
- 能按时间、服务和实例统计异常数量
- 能根据分布特征区分个例、局部故障和批量故障
先定义什么叫同一种异常
直接按完整 message 聚合通常不可靠,因为消息里可能包含订单号、用户 ID、IP、时间戳等动态值,同一种根因会因此被拆成很多组。更稳妥的做法是使用采集阶段生成的稳定错误签名,例如 error.signature 或 error.fingerprint。
如果暂时没有签名字段,可以先用 error.type 加归一化后的错误消息、关键错误码或第一条业务栈帧组合筛选。目标是让“同一根因”尽量落入同一组,而不是让字符串细节决定分组结果。
同时看三个维度
判断是否系统性故障,至少要同时看时间、服务和实例。时间维度回答“错误是否突然增多”,服务维度回答“影响是否跨服务”,实例维度回答“是否集中在某一台机器或某个 Pod”。
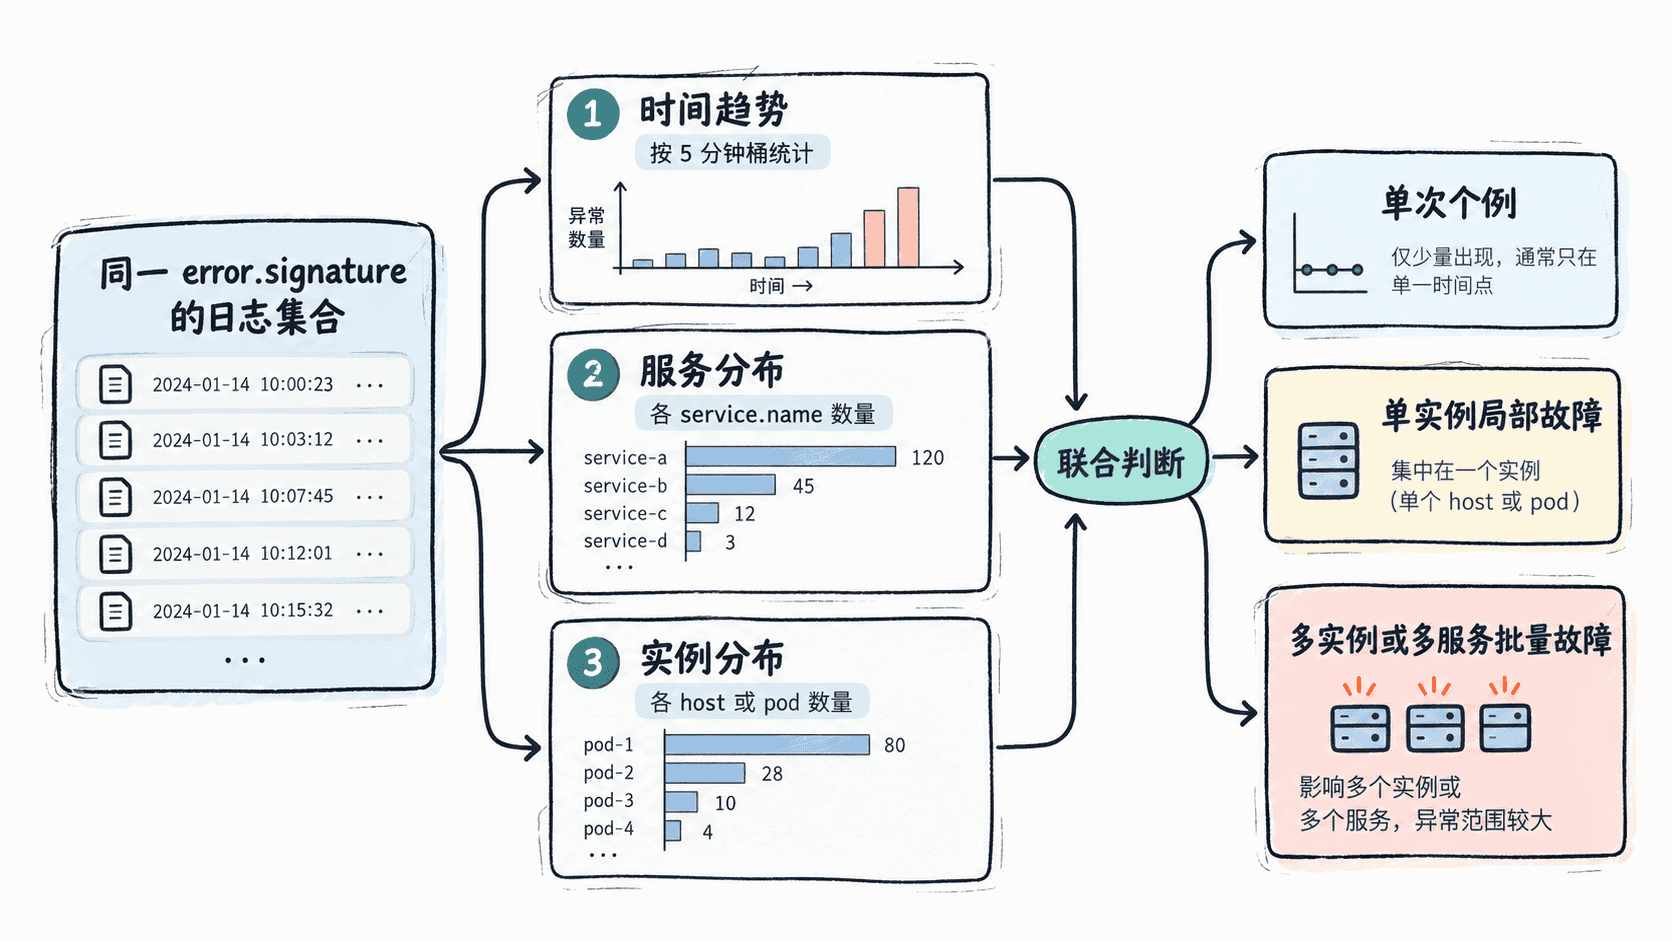
下面示例假设 error.signature、service.name 和 host.name 都是可聚合的 keyword 类字段。查询只返回聚合结果,不拉取原始文档,因此适合快速判断范围。
ES_URL="http://<HOST>:<PORT>"
curl -sS "$ES_URL/logs-*/_search" -H 'Content-Type: application/json' -d '{"size":0,"query":{"bool":{"filter":[{"range":{"@timestamp":{"gte":"<TIME_START>","lte":"<TIME_END>"}}},{"term":{"error.signature":"<ID>"}}]}},"aggs":{"by_5m":{"date_histogram":{"field":"@timestamp","fixed_interval":"5m","min_doc_count":0}},"by_service":{"terms":{"field":"service.name","size":20}},"by_instance":{"terms":{"field":"host.name","size":50}}}}'
预期输出
HTTP 200
aggregations.by_5m.buckets:每个 5 分钟时间桶包含 key_as_string 与 doc_count=<COUNT>
aggregations.by_service.buckets:每个服务包含 key=<SERVICE> 与 doc_count=<COUNT>
aggregations.by_instance.buckets:每个实例包含 key=<INSTANCE> 与 doc_count=<COUNT>
如果实例运行在 Kubernetes,也可以把 host.name 换成实际记录 Pod 的字段。关键不是字段名称,而是选择能区分运行副本的维度。
用分布特征判断故障范围
三类常见模式可以帮助快速判断范围:
| 观察结果 | 更可能的范围 | 下一步 |
|---|---|---|
| 长时间窗口里只有 1~2 次,分散且不持续 | 个例或偶发输入 | 回看单请求上下文,确认是否可重现 |
| 错误集中在一个实例,其他实例正常 | 局部实例故障 | 检查该实例资源、配置、连接池和近期变更 |
| 多实例同时上升,甚至跨服务出现 | 批量或系统性故障 | 检查共享依赖、数据库、缓存、网络和发布变更 |
这里不能只看“总数”。例如 100 条错误若集中在单一实例,和 100 条错误均匀分布在 20 个实例上,处置方向完全不同。还应把错误量与请求量一起看:请求量突增时,错误条数上升不一定代表错误率恶化。
避免把症状当成根因
同一底层故障可能在不同服务里产生不同异常。例如数据库不可用时,API 服务可能记录超时,订单服务记录连接失败,任务服务记录重试耗尽。若只按错误文本统计,容易把一次系统性故障拆成多个“小问题”。
因此,当多个服务在同一时间窗口同时出现异常峰值时,应进一步对齐共同依赖和发布事件。反过来,如果只有一个实例持续报错,优先检查该实例特有的配置、磁盘、内存、网络连接和部署版本。
最终的判断应能落到可操作范围:是单个请求、单个实例、单个服务,还是多个服务共同受影响。范围越明确,后续排查共享依赖、回滚发布或隔离实例时就越少走弯路。