
可观测性与稳定性 / 系统课时
集群节点之间怎样保存数据
集群节点之间怎样保存数据
在集中日志系统里,索引看起来像一个整体,但数据并不是完整地放在某一台服务器上。理解集群、节点、索引和分片之间的关系,才能判断某个节点故障时哪些数据受影响,以及为什么扩容后数据会在节点之间重新分布。
学习目标
- 说清集群、节点、索引和分片各自承担的职责
- 理解主分片与副本分片为什么会分布到不同节点
- 能根据分片分配关系判断节点故障对日志数据的影响
真正落盘的是分片
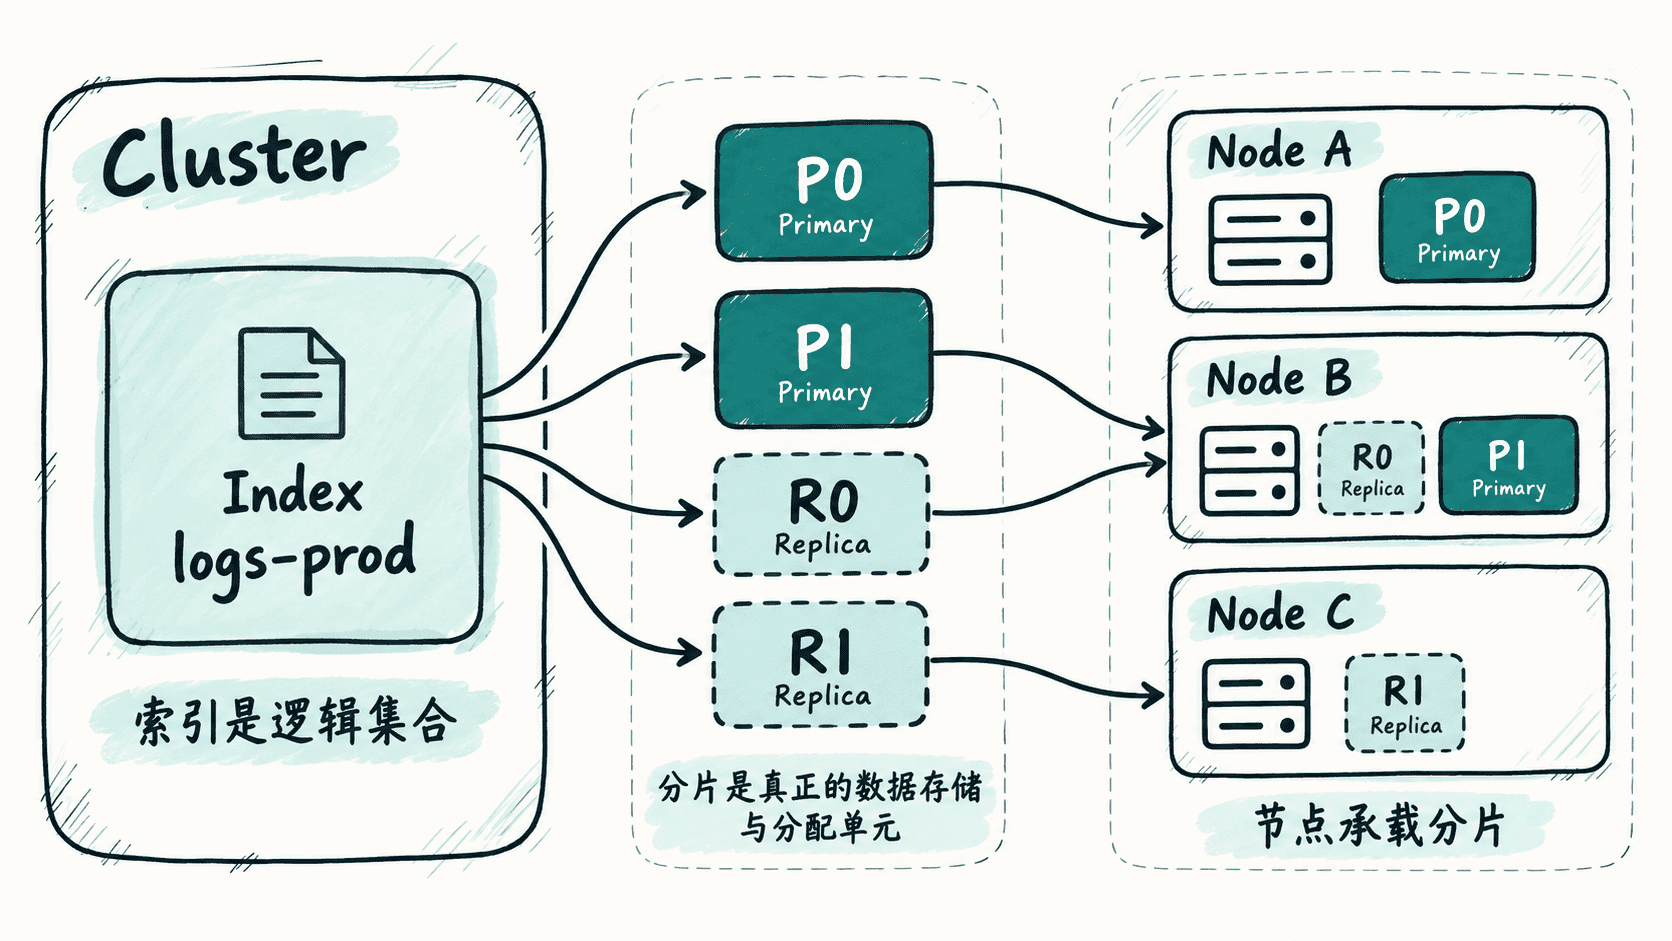
以 Elasticsearch 为例,集群是一组共同工作的节点,节点是实际运行搜索引擎进程的服务器或实例,索引则是应用看到的逻辑数据集合。索引本身不是一个必须完整存放在单台节点上的目录,它会被拆成若干分片。
每个分片都是可以独立存储和查询的数据单元。节点磁盘上真正保存的是这些分片对应的数据文件,因此判断数据位于哪里时,应该问“这个分片分配到了哪个节点”,而不是“这个索引属于哪个节点”。
主分片决定数据属于哪一份
创建索引时会确定主分片数量。写入一条日志文档后,搜索引擎根据路由值计算它应该进入哪个主分片;默认情况下,文档的 _id 会参与这一过程。因此,同一个索引中的文档会被分散到不同主分片,而不是每台节点都保存一份完整索引。
假设一个索引有两个主分片,可以把它理解为两份互不重复的数据集合:P0 保存一部分文档,P1 保存另一部分文档。一次针对整个索引的搜索通常需要访问相关分片,再由协调节点汇总结果。
主分片数量还影响后续横向分布能力。如果只有一个主分片,即使增加很多节点,这一个主分片本身也不能被进一步同时拆到多台节点上承担存储。
副本分片提供冗余和读取能力
副本分片保存某个主分片的数据副本。例如 R0 是 P0 的副本,R1 是 P1 的副本。在正常分配条件下,一个副本不会与对应主分片放在同一个节点,否则该节点故障时两份数据会同时不可用。
假设三个节点上的分配如下:
| 节点 | 承载的分片 |
|---|---|
| Node A | P0、R1 |
| Node B | P1、R0 |
| Node C | 其他索引的分片或等待重新分配 |
如果 Node A 故障,P0 暂时丢失,但 Node B 上的 R0 仍保存同一份数据。集群可以把可用副本提升为主分片,并在条件允许时重新创建新的副本。这正是副本能够提高可用性的原因。
节点变化会触发分片重新分配
节点加入或离开集群后,集群会重新评估各分片应该放在哪里。例如新增节点时,部分分片可能迁移到新节点以降低原有节点的磁盘和查询压力;节点故障时,则可能提升副本并补建缺失副本。
因此,运维中看到“节点磁盘突然下降”“网络流量升高”或“部分分片正在迁移”时,不应只观察节点数量,还要结合分片分配状态判断。索引是否健康,本质上取决于它需要的主分片和副本分片是否都得到了合适的分配。
把这几个对象连起来看就很清楚:集群管理节点,节点承载分片,索引由多个主分片组成,副本分片复制主分片的数据。后续排查集群状态时,真正需要追踪的核心对象就是“某个分片当前位于哪个节点,以及它是否还有可用副本”。