
可观测性与稳定性 / 系统课时
为什么分片不能越多越好
为什么分片不能越多越好
日志索引拆成分片后可以并行写入和查询,但分片不是免费的并行单元。分得过细会让节点维护更多元数据、段文件和搜索任务,最终出现数据量不大却集群很忙的现象。本篇用日志索引场景说明如何识别过度分片,并给出可落地的控制思路。
学习目标
- 解释主分片和副本分片为什么都会产生资源开销
- 根据单索引数据量、保留周期和查询模式判断是否存在过度分片
- 使用分片统计结果为新索引选择更合理的初始分片数
分片增加的不只是并行度
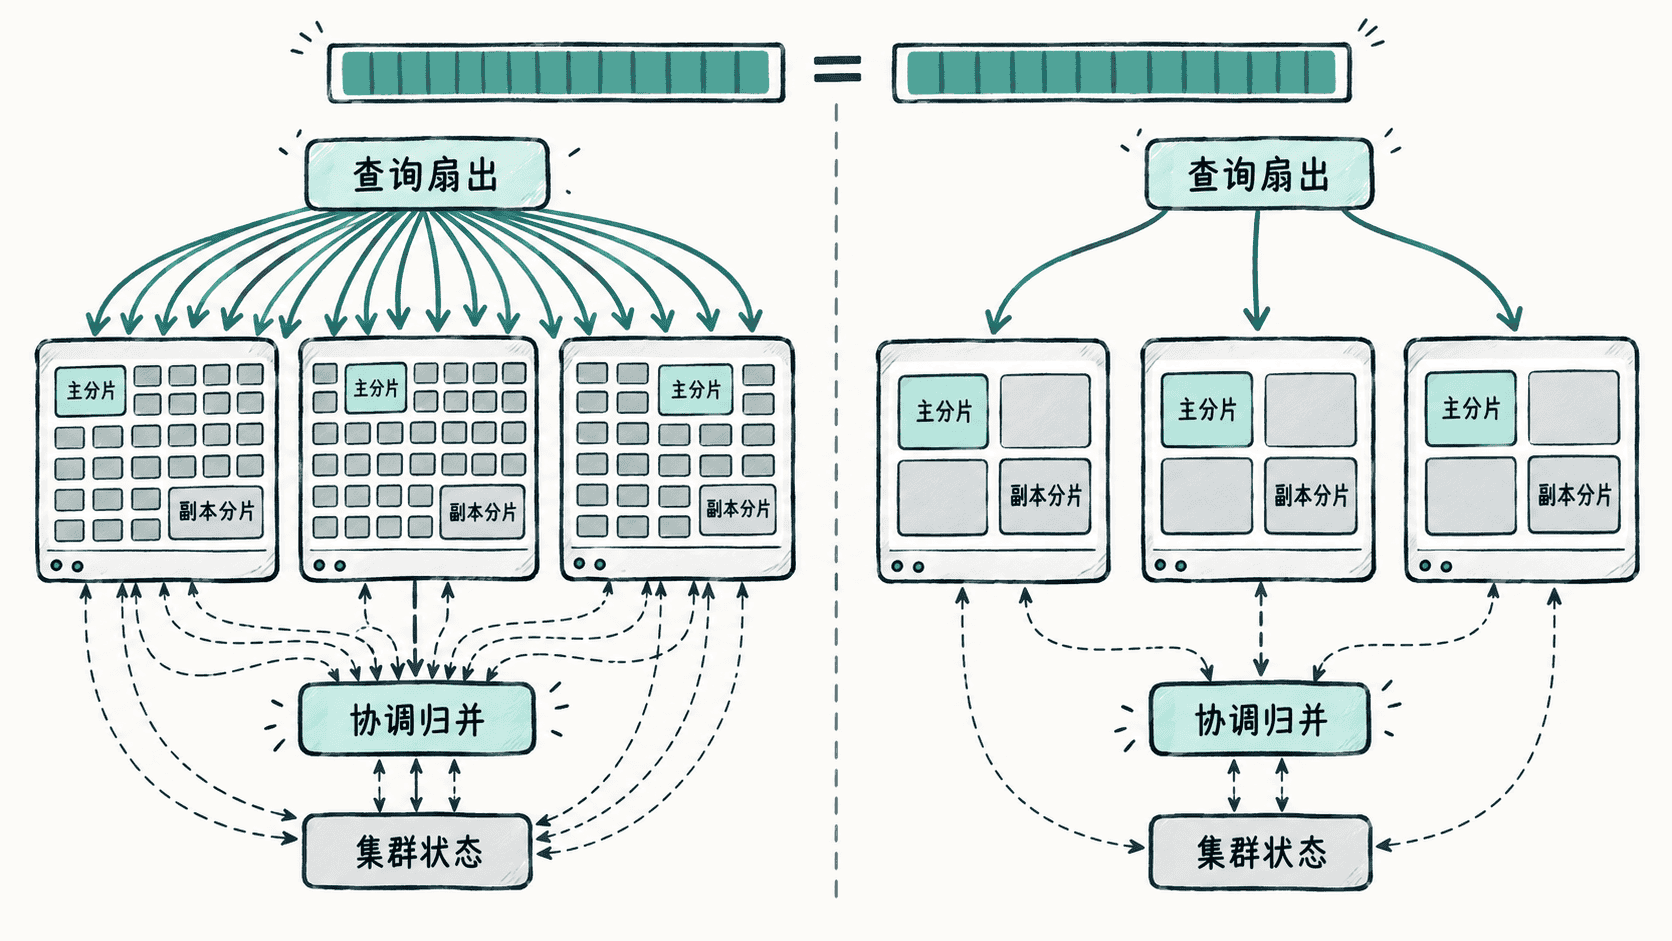
一个 Elasticsearch 分片本质上是一个独立的 Lucene 索引。索引被拆成更多主分片后,写入和查询确实可以分散到多个分片,但集群也必须跟踪更多分片状态、段文件和路由信息;配置副本后,每个主分片还会产生对应的副本分片。
查询跨越多个分片时,请求会被分发到相关分片执行,再由协调节点归并结果。分片很小时,这些固定调度与归并成本占比会变高,因此“把分片数翻倍”并不等于“查询速度翻倍”。
从日志规模识别过度分片
日志系统常见的问题不是单个分片过大,而是“每天一个索引”再配上过多主分片。例如每天只有几 GB 数据,却固定创建多个主分片;保留 30 天后,分片数量会随着每日索引持续累积。如果再配置一个副本,实际分片副本数还会再增加一倍。
判断时不要只看总磁盘容量,还要同时看三个量:每个索引的主分片数、单个主分片的实际大小、一个查询通常会命中多少索引。大量长期只有几百 MB 甚至更小的活跃分片,通常说明索引粒度或分片数需要重新评估。
下面用 CAT Shards 查看某个日志索引的主分片、副本、文档数和大小。将 <PORT> 替换为实际 HTTP 端口;<ID>、<SIZE>、<HOST> 表示环境相关值。
curl -s "http://localhost:<PORT>/_cat/shards/logs-app-000001?v&h=index,shard,prirep,state,docs,store,node&s=shard,prirep"预期输出(字段值会随实际数据变化):
index            shard prirep state   docs store  node
logs-app-000001  0     p      STARTED <ID> <SIZE> <HOST>
logs-app-000001  0     r      STARTED <ID> <SIZE> <HOST>
如果一个低数据量索引出现很多行不同的 shard 编号,而每个分片的 store 都很小,就应把它作为过度分片的排查信号,而不是继续增加分片。
为新索引选择分片数
初始分片数应从“预计主数据量 ÷ 目标单分片数据量”开始估算,再用真实写入、查询和恢复压测修正。目标不是追求某个固定数字,而是在查询并行度、单分片大小、节点数量和故障恢复时间之间取得平衡。
日志量较小且增长稳定时,优先从较少的主分片开始;当单分片持续变大、恢复时间过长或写入已经被单分片吞吐限制时,再考虑通过 rollover、新索引模板或重建索引调整分片策略。不要因为未来“可能增长”就一次性预分配大量空闲分片。
还要区分主分片和副本的职责:主分片数量决定数据分区方式,副本主要用于冗余和读取扩展。增加副本不能替代正确的主分片设计,也会消耗额外磁盘和节点资源。
已有索引不要直接硬改
已有索引的主分片数不能像普通动态参数一样随意改小。需要减少分片时,应根据场景选择新建目标索引后重新索引,或在满足条件时使用 shrink;对时间序列日志,更常见的做法是让新的 rollover 索引采用改进后的分片设置,让旧索引按生命周期自然退出。
因此,分片规划的核心不是“越多越安全”,而是让每个分片承担足够的数据和工作量,同时把总分片数量控制在集群能够稳定管理、查询和恢复的范围内。