
计算机视觉 / 系统课时
控制图像复制
控制图像复制
OpenCV 的 Python 图像通常由 NumPy 数组承载。性能问题往往不是算法本身,而是循环里反复复制大数组。本节用可验证示例区分视图与副本,并给出什么时候共享数据、什么时候必须复制的判断方法。
学习目标
- 判断 NumPy 图像切片是视图还是独立副本
- 避免在逐帧处理链路中制造不必要的整图复制
- 在需要隔离修改时主动创建副本并验证内存关系
先看清视图与副本
对 ndarray 做普通切片,例如 frame[y1:y2, x1:x2],通常得到视图。视图只保存形状、步长和数据起点等元数据,像素仍指向原数组的同一块内存,因此创建成本低,修改也会回写原图。
调用 copy() 则会申请新的像素缓冲区并复制数据。它提供修改隔离,但代价与复制区域的像素量近似成正比。处理 4K 视频时,如果每帧多做几次整图复制,内存带宽和分配压力会很快放大。
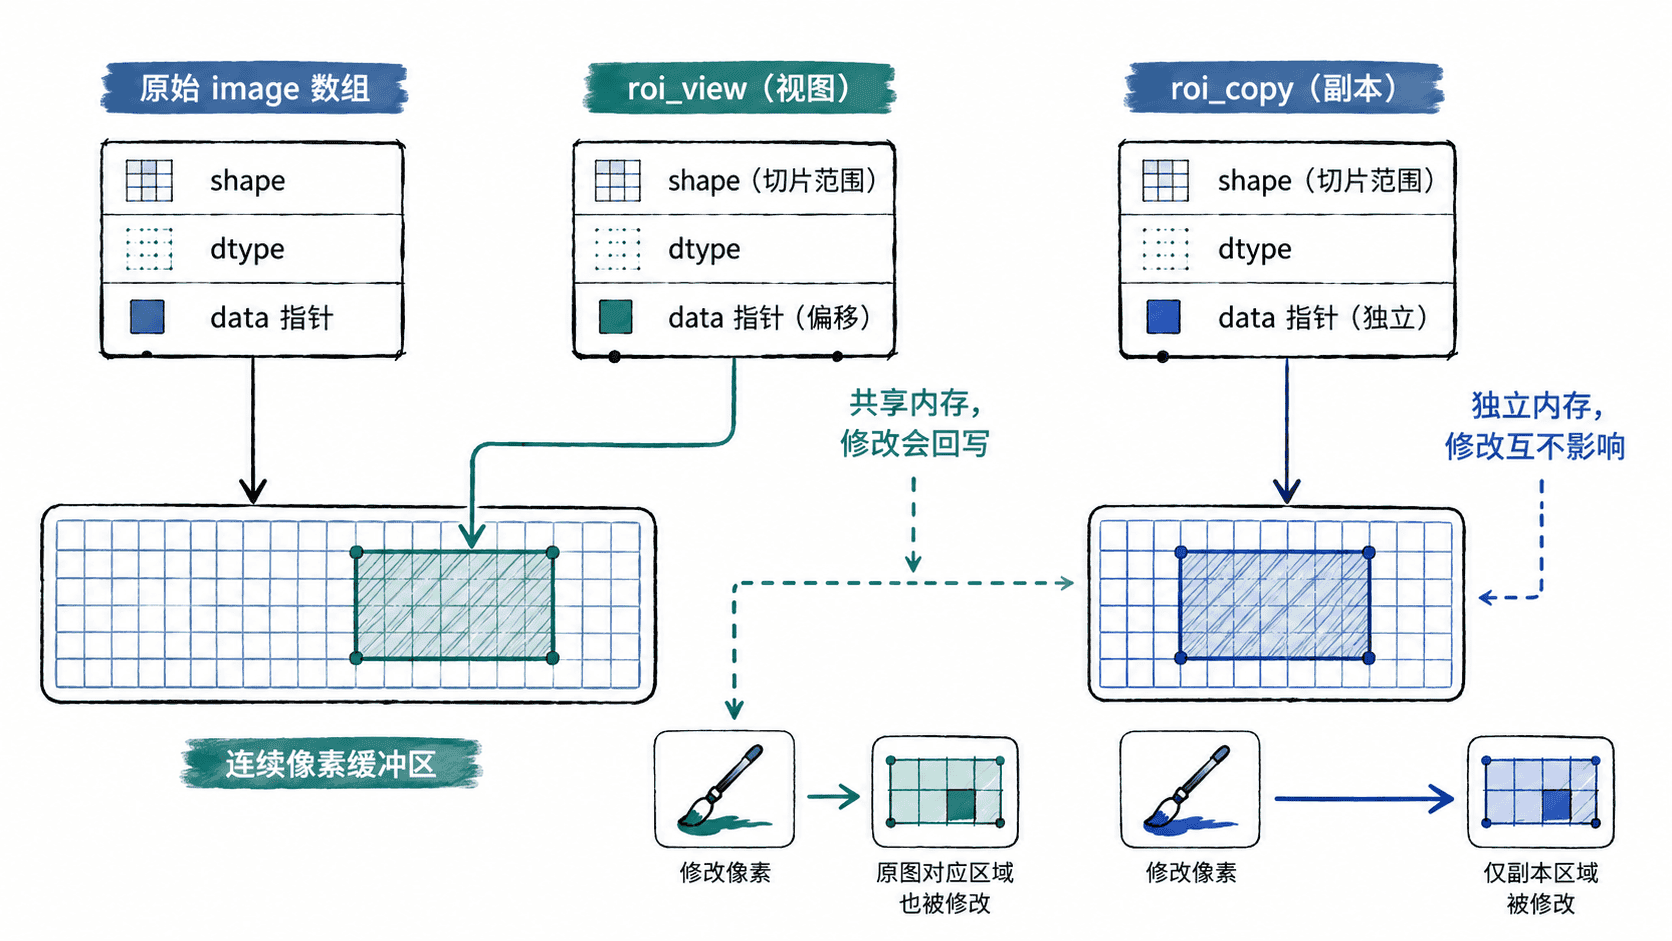
用代码验证共享关系
下面的示例同时创建一个 ROI 视图和一个 ROI 副本,再分别用 OpenCV 修改它们。np.shares_memory 可以直接验证两个数组是否共享底层存储。
import cv2
import numpy as np

image = np.zeros((6, 6, 3), dtype=np.uint8)

roi_view = image[2:5, 1:4]
roi_copy = image[2:5, 1:4].copy()

cv2.rectangle(roi_view, (0, 0), (2, 2), (0, 255, 0), thickness=-1)
cv2.rectangle(roi_copy, (0, 0), (2, 2), (0, 0, 255), thickness=-1)

print("view shares memory:", np.shares_memory(image, roi_view))
print("copy shares memory:", np.shares_memory(image, roi_copy))
print("pixel in image:", image[2, 1].tolist())
print("pixel in copy:", roi_copy[0, 0].tolist())
预期输出
view shares memory: True
copy shares memory: False
pixel in image: [0, 255, 0]
pixel in copy: [0, 0, 255]
这说明对 roi_view 的绘制直接改写了 image,而 roi_copy 的红色像素只存在于副本中。实际项目里如果只是读取 ROI 做检测或统计,优先使用视图;如果后续步骤会改写 ROI 且必须保留原图,再创建副本。
把复制放在真正的隔离边界
常见低效写法是在每个处理步骤前都 frame.copy(),例如先为灰度化复制一次、为检测复制一次、为绘制再复制一次。更合理的方式是让只读阶段共享同一输入,把复制推迟到“即将发生破坏性修改且原图仍需保留”的边界。
OpenCV 中不少函数会返回新的输出数组,例如 cv2.resize、cv2.cvtColor 和多数滤波操作。既然函数本身已经产生结果,就不要再为了“保险”额外复制其输入或输出。另一方面,也不要强行追求原地写入:只有 API 明确支持、输入输出尺寸与类型兼容,而且不会破坏后续依赖时才适合复用缓冲区。
排查复制热点
性能排查时先搜索循环中的 copy()、np.copy()、整图切片后复制,以及“为了画框而复制整帧”的模式。再结合图像尺寸和帧率判断代价:一个副本看起来便宜,但在高分辨率实时视频中会被每秒几十帧持续放大。
控制图像复制的核心不是“永远不复制”,而是让每次复制都有明确目的:共享只读数据时用视图,需要修改隔离时才复制,并把副本的范围尽量缩小到真正需要写入的区域。