
计算机视觉 / 系统课时
解析目标检测结果
解析目标检测结果
目标检测网络给出的通常不是可直接绘制的矩形,而是一组类别、置信度和坐标数值。本节以常见的 SSD 风格输出为例,把 [0, 1] 范围内的归一化坐标恢复到原图像素坐标,并处理越界、低置信度和无效框。
学习目标
- 读懂常见检测输出中的类别、置信度和边界框字段
- 将归一化坐标转换为原图像素坐标
- 对坐标进行裁剪并过滤无效检测结果
先确认输出格式
不同检测模型的输出布局并不统一。SSD 类模型常见单条检测记录为 batch_id, class_id, score, xmin, ymin, xmax, ymax,整体张量可能是 [1, 1, N, 7]。YOLO 系列则常把框中心、宽高、目标置信度和类别分数放在同一行,解析方式不同。
因此,第一步不是立刻乘图像宽高,而是先确认模型文档、导出脚本或实际张量形状。只有明确坐标含义和量纲后,才能安全转换。
把归一化坐标还原到原图
如果输出中的 xmin、ymin、xmax、ymax 都是相对原图宽高的归一化值,那么转换关系就是 、。其中 W 和 H 必须是原始图像尺寸,而不是网络输入 blob 的尺寸。
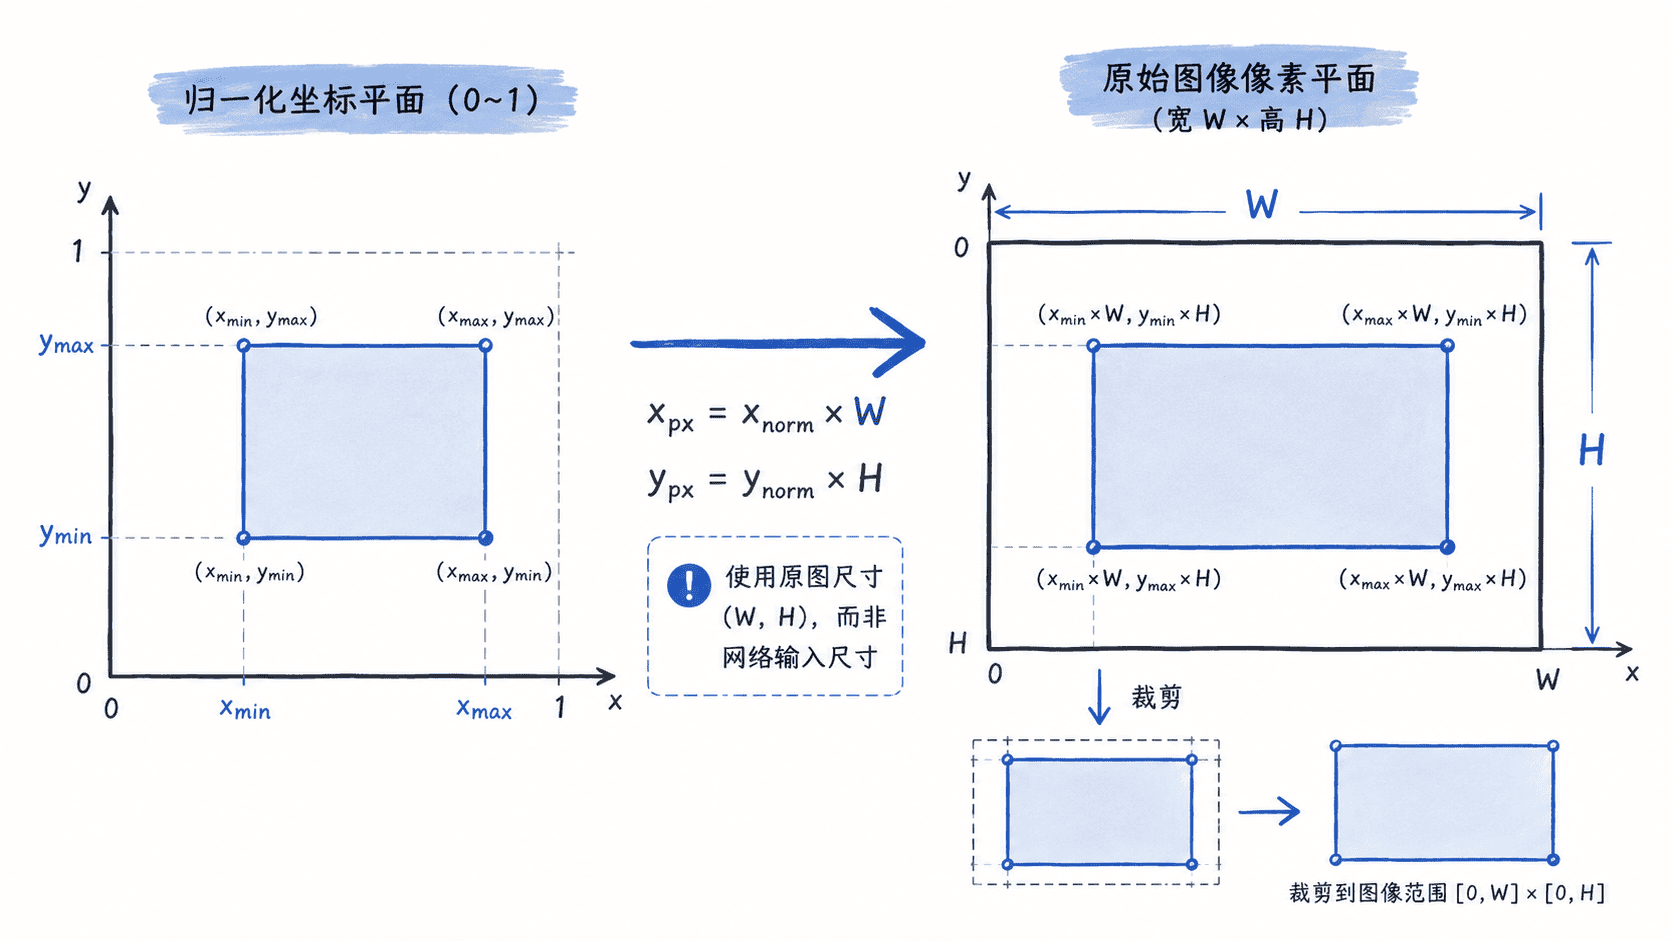
下面的示例构造一个 SSD 风格输出张量,并解析置信度不低于 0.5 的检测框。实际项目中,只需把 detections 替换成 net.forward() 的结果即可。
import numpy as np

image_width = 1280
image_height = 720
confidence_threshold = 0.5

# 每行依次为 batch_id、class_id、score、xmin、ymin、xmax、ymax。
detections = np.array(
    [[[[0, 15, 0.92, 0.10, 0.20, 0.55, 0.80],
       [0, 7, 0.48, 0.30, 0.10, 0.60, 0.50]]]],
    dtype=np.float32,
)

for detection in detections.reshape(-1, 7):
    _, class_id, score, xmin, ymin, xmax, ymax = detection
    if score < confidence_threshold:
        continue

    x1 = max(0, min(image_width - 1, int(xmin * image_width)))
    y1 = max(0, min(image_height - 1, int(ymin * image_height)))
    x2 = max(0, min(image_width, int(xmax * image_width)))
    y2 = max(0, min(image_height, int(ymax * image_height)))

    # 过滤被裁剪后宽或高不为正的异常框。
    if x2 <= x1 or y2 <= y1:
        continue

    box_width = x2 - x1
    box_height = y2 - y1
    print(
        f"class={int(class_id)} score={score:.2f} "
        f"box=({x1}, {y1}, {box_width}, {box_height})"
    )
预期输出
class=15 score=0.92 box=(128, 144, 576, 432)第二条检测的置信度为 0.48,低于阈值,因此不会进入结果。
坐标转换最容易出错的地方
最常见的错误是把归一化坐标乘以网络输入尺寸。例如原图是 1280×720,推理时缩放到 640×640,如果输出语义仍对应原图归一化坐标,就应该乘 1280 和 720。只有模型明确输出的是输入平面上的绝对坐标时,才需要按预处理过程反变换。
还要注意坐标顺序。有的模型输出左上与右下角,有的输出中心点与宽高;有的框已经做过 NMS,有的只是原始候选框。解析前先确认这三个问题:坐标格式是什么、坐标量纲是什么、是否已经完成后处理。
从边界框到可用检测结果
完成坐标还原后,通常还要把 class_id 映射为类别名称,并根据模型需要执行 NMS 去除高度重叠的候选框。NMS 属于后处理步骤,不应和坐标换算混在一起调试;先确认单个框的位置正确,再增加类别映射和去重逻辑,更容易定位问题。
当检测框整体偏移或缩放异常时,优先回查图像预处理是否发生了拉伸、裁剪或 letterbox 填充。只要预处理改变了几何关系,就必须按同一规则做逆变换,不能只做一次简单的宽高乘法。