
计算机视觉 / 系统课时
匹配特征描述子
匹配特征描述子
局部特征被编码成描述子后,下一步就是在两幅图像之间建立候选对应。本节用 ORB 描述子同时演示暴力匹配器与 FLANN 近似匹配器,掌握距离度量、匹配器选择和结果读取方法。
学习目标
- 能根据描述子类型选择 Hamming 或 L2 距离
- 能使用
BFMatcher与 FLANN 建立候选匹配 - 能理解
queryIdx、trainIdx和distance的含义
描述子匹配的本质
匹配器会为图像 A 中的描述子寻找图像 B 中最相似的向量,并返回候选对应。DMatch 只说明两个描述子在所选距离度量下接近,并不等于它们已经通过几何验证,因此原始匹配仍可能包含重复纹理或偶然相似造成的误配。
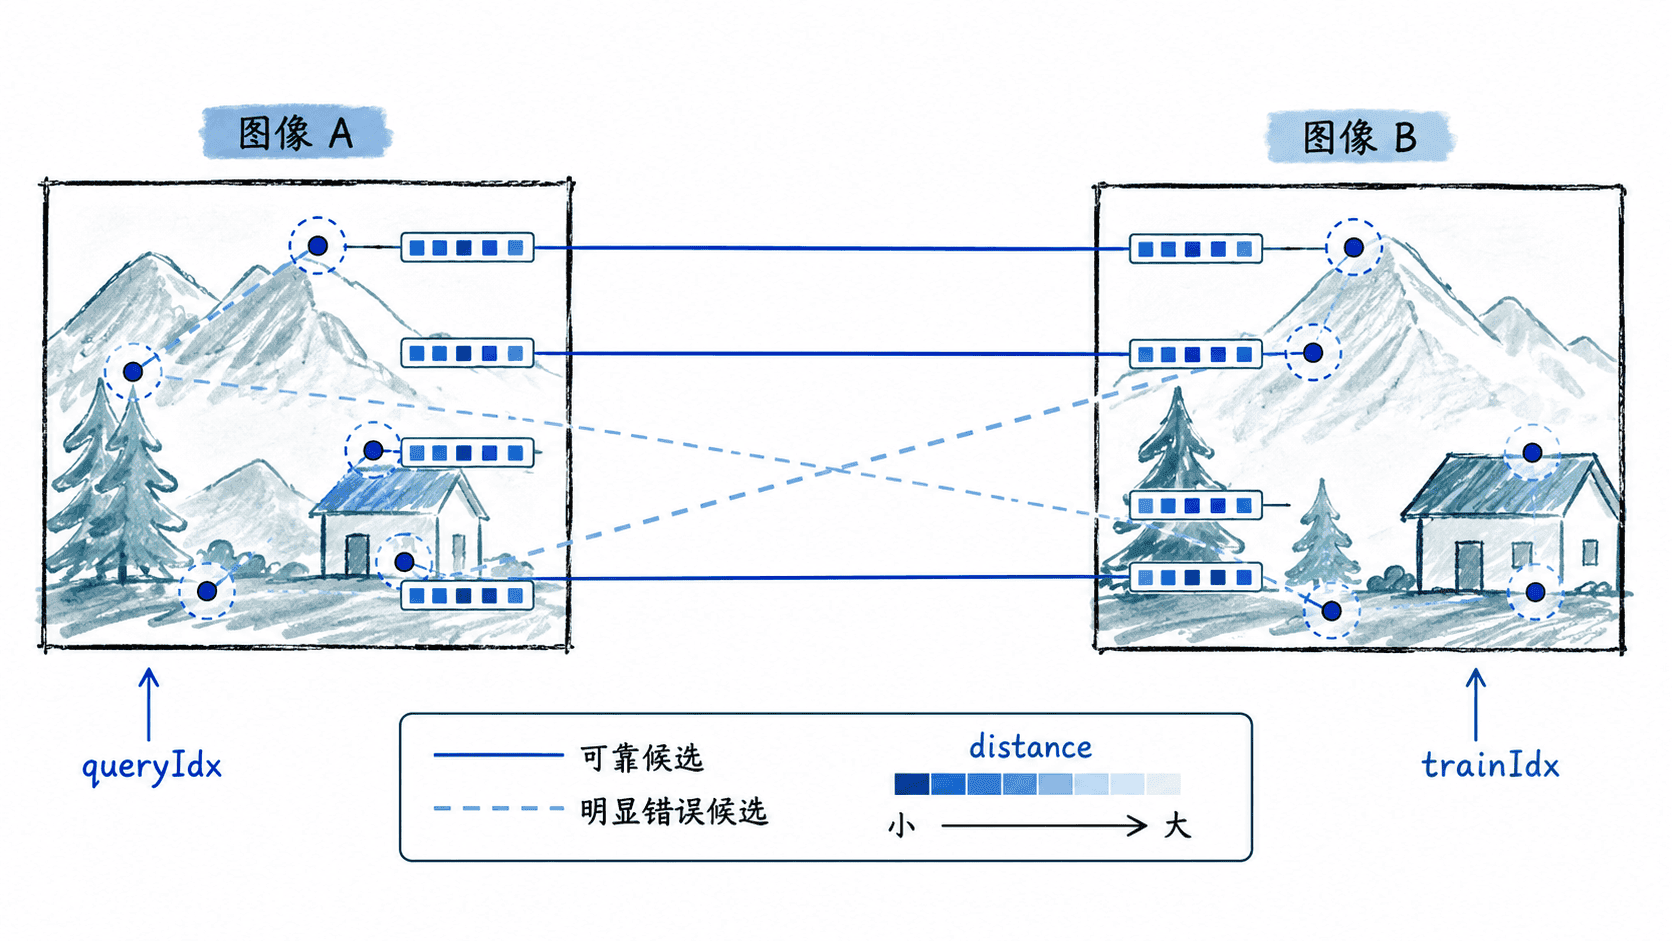
ORB、BRISK 等二进制描述子通常使用 cv2.NORM_HAMMING;SIFT 这类浮点描述子通常使用 cv2.NORM_L2。距离类型选错时,代码可能仍能运行,但“最近”的排序不再具有正确含义。
BFMatcher 与 FLANN
BFMatcher 会直接比较描述子,行为简单、确定,适合中小规模数据和调试。FLANN 通过索引进行近似近邻搜索,描述子很多时更有价值。对 ORB 这样的二进制描述子,FLANN 应使用 LSH 索引;SIFT 这类浮点描述子通常使用 KD-Tree。
| 描述子 | 距离 | 直接匹配 | 近似匹配 |
|---|---|---|---|
| ORB / BRISK | Hamming | BFMatcher |
FLANN + LSH |
| SIFT | L2 | BFMatcher |
FLANN + KD-Tree |
下面的完整示例生成两幅具有旋转和平移关系的测试图,提取 ORB 描述子,再分别执行 BF 与 FLANN-LSH 匹配。
import cv2
import numpy as np

img1 = np.zeros((360, 520), dtype=np.uint8)
cv2.rectangle(img1, (60, 70), (210, 220), 255, 3)
cv2.circle(img1, (350, 150), 65, 255, 3)
cv2.line(img1, (80, 300), (440, 270), 255, 4)
cv2.putText(img1, "ORB", (250, 330),
            cv2.FONT_HERSHEY_SIMPLEX, 1.2, 255, 3)

matrix = cv2.getRotationMatrix2D((260, 180), 7, 1.0)
matrix[:, 2] += np.array([18, -10])
img2 = cv2.warpAffine(img1, matrix, (520, 360))

orb = cv2.ORB_create(nfeatures=800)
kp1, des1 = orb.detectAndCompute(img1, None)
kp2, des2 = orb.detectAndCompute(img2, None)

if des1 is None or des2 is None:
    raise RuntimeError("没有检测到可匹配的 ORB 描述子")

# 暴力匹配:逐个比较 Hamming 距离。
bf = cv2.BFMatcher(cv2.NORM_HAMMING, crossCheck=False)
bf_matches = sorted(bf.match(des1, des2), key=lambda m: m.distance)

# FLANN-LSH:面向 uint8 二进制描述子。
index_params = dict(
    algorithm=6,
    table_number=6,
    key_size=12,
    multi_probe_level=1,
)
flann = cv2.FlannBasedMatcher(index_params, dict(checks=50))
flann_matches = sorted(flann.match(des1, des2),
                       key=lambda m: m.distance)

best = bf_matches[:30]
preview = cv2.drawMatches(
    img1, kp1, img2, kp2, best, None,
    flags=cv2.DrawMatchesFlags_NOT_DRAW_SINGLE_POINTS,
)
cv2.imwrite("descriptor_matches.png", preview)

m = bf_matches[0]
print(f"image1 keypoints: {len(kp1)}")
print(f"image2 keypoints: {len(kp2)}")
print(f"BF matches: {len(bf_matches)}")
print(f"FLANN matches: {len(flann_matches)}")
print(f"best queryIdx/trainIdx: {m.queryIdx}/{m.trainIdx}")
print(f"best distance: {m.distance}")
print("saved: descriptor_matches.png")
预期输出
image1 keypoints: <VALUE>
image2 keypoints: <VALUE>
BF matches: <VALUE>
FLANN matches: <VALUE>
best queryIdx/trainIdx: <ID>/<ID>
best distance: <VALUE>
saved: descriptor_matches.png
<VALUE> 与 <ID> 会随 OpenCV 版本和特征检测细节变化,但关键点数与匹配数应为正,并生成 descriptor_matches.png。
读懂匹配结果
queryIdx 是查询描述子在图像 A 描述子数组中的索引,trainIdx 是对应的图像 B 描述子索引;通过它们可以取回两侧关键点坐标。distance 越小通常表示描述子越相似,但不同描述子和距离度量的数值范围不可直接横向比较。
选择匹配器的边界
少量描述子、教学验证或需要稳定可解释行为时,优先使用 BFMatcher;描述子规模较大且近邻搜索成为热点时,再考虑 FLANN。无论选择哪一种,先保证描述子类型与距离度量正确,再讨论速度;原始候选还需要后续比率测试、交叉验证或几何验证才能用于可靠对齐。