
计算机视觉 / 系统课时
执行模板匹配
执行模板匹配
模板匹配用一张较小的模板图,在较大的搜索图中逐位置比较相似度,并把最佳位置还原成目标框。本节用可运行示例同时演示高分优先与低分优先两类方法,避免把匹配分数方向理解反。
学习目标
- 理解
cv2.matchTemplate返回的得分矩阵与坐标含义 - 正确读取
TM_CCOEFF_NORMED和TM_SQDIFF_NORMED的最佳位置 - 判断模板匹配在尺度、旋转和外观变化下的适用边界
理解匹配结果
设搜索图尺寸为 W×H,模板尺寸为 w×h。cv2.matchTemplate 会让模板在所有合法位置滑动,因此结果矩阵尺寸为 (W-w+1)×(H-h+1)。结果中的每个元素都对应“模板左上角放在该坐标时”的匹配分数。
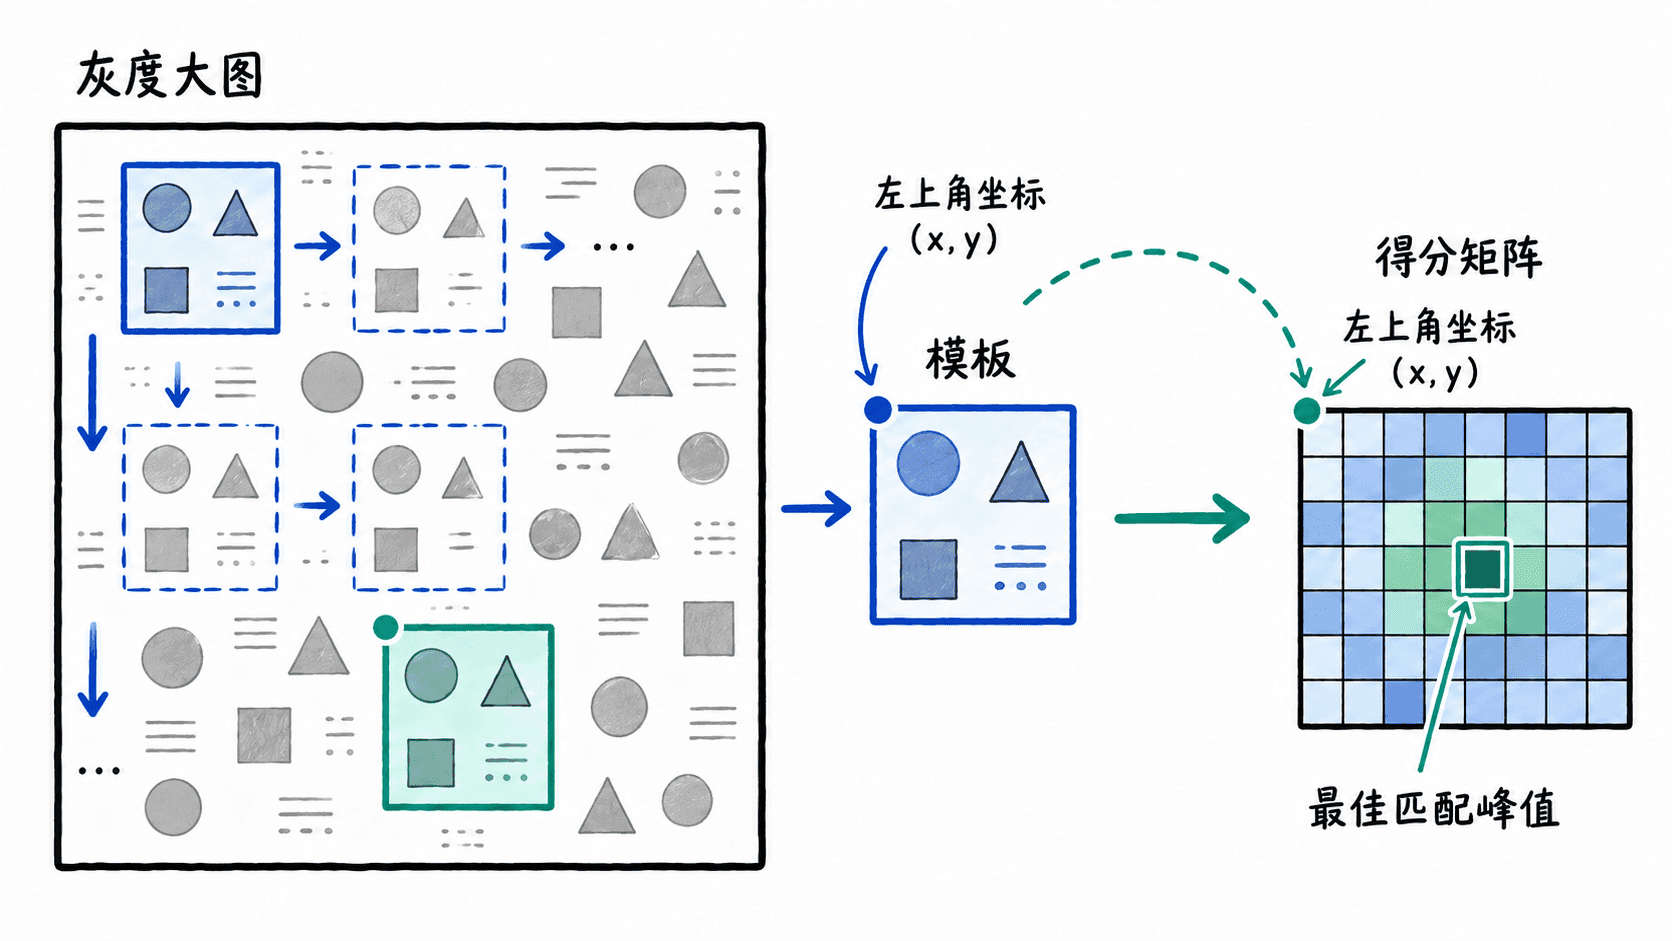
对 TM_CCOEFF_NORMED、TM_CCORR_NORMED 这类方法,分数越大越相似;对 TM_SQDIFF、TM_SQDIFF_NORMED,分数越小越相似。最终目标框的宽高仍然使用模板自身的 w 和 h。
用两个方法完成匹配
下面构造一张搜索图和一个带纹理的模板,并把模板放到坐标 (140, 90)。示例不依赖外部图片文件,可以直接验证两类方法的取点规则。
python
import cv2
import numpy as np

template = np.zeros((40, 50), dtype=np.uint8)
cv2.rectangle(template, (3, 3), (46, 36), 180, 2)
cv2.circle(template, (15, 20), 6, 255, -1)
cv2.line(template, (28, 10), (42, 30), 220, 3)

image = np.full((220, 320), 30, dtype=np.uint8)
image[90:130, 140:190] = template

methods = {
    "TM_CCOEFF_NORMED": cv2.TM_CCOEFF_NORMED,
    "TM_SQDIFF_NORMED": cv2.TM_SQDIFF_NORMED,
}

for name, method in methods.items():
    result = cv2.matchTemplate(image, template, method)
    min_val, max_val, min_loc, max_loc = cv2.minMaxLoc(result)

    # 平方差方法取最小值,其余这里演示的方法取最大值。
    if method == cv2.TM_SQDIFF_NORMED:
        location, score = min_loc, min_val
    else:
        location, score = max_loc, max_val

    print(f"{name}: location={location}, score={score:.3f}")
预期输出
text
TM_CCOEFF_NORMED: location=(140, 90), score=1.000
TM_SQDIFF_NORMED: location=(140, 90), score=0.000
实际图像经过压缩、噪声或颜色变化后,分数通常不会恰好等于 1 或 0,但最佳坐标的读取规则不变。得到左上角 (x, y) 后,右下角可写为 (x+w, y+h)。
选择匹配方法
| 方法 | 最优方向 | 常用理解 |
|---|---|---|
TM_SQDIFF_NORMED |
越小越好 | 比较像素差异,完全一致时接近 0 |
TM_CCORR_NORMED |
越大越好 | 比较相关性,适合直接寻找相似亮度结构 |
TM_CCOEFF_NORMED |
越大越好 | 去除平均亮度影响后比较结构,常作为通用起点 |
归一化版本更便于跨图片设置统一阈值,但阈值仍应根据真实样本统计,而不是机械使用固定数字。若只找一个目标,cv2.minMaxLoc 足够;若要找多个目标,就应对整个得分矩阵做阈值筛选。
识别模板匹配的边界
模板匹配默认模板与目标在尺寸和方向上基本一致。目标缩放明显时,应尝试多尺度模板或改用特征匹配;目标旋转、透视变化较大时,单纯滑动比较通常会失效。
当目标外观稳定、尺度固定、搜索区域有限时,模板匹配实现简单且结果直观;一旦场景变化超出模板能表达的范围,就应及时切换到特征点或学习型检测方法。
按自己的节奏,确认真正理解。