
计算机视觉 / 系统课时
执行非极大值抑制
执行非极大值抑制
目标检测模型常会在同一目标附近给出多个高度重叠的候选框。非极大值抑制(NMS)会先按置信度选出最佳框,再压制与它重叠过高的重复框,从而得到更干净、可直接绘制或统计的检测结果。
学习目标
- 理解置信度阈值与 NMS 重叠阈值分别控制什么。
- 使用
cv2.dnn.NMSBoxes过滤重复边界框。 - 判断何时需要按类别分别执行 NMS。
NMS 如何删除重复框
NMS 的输入通常是候选框、每个框的置信度,以及两个阈值。置信度阈值先淘汰分数过低的候选框;随后按分数从高到低处理,保留当前最高分框,并删除与它 IoU 过大的其他框,直到没有候选框为止。
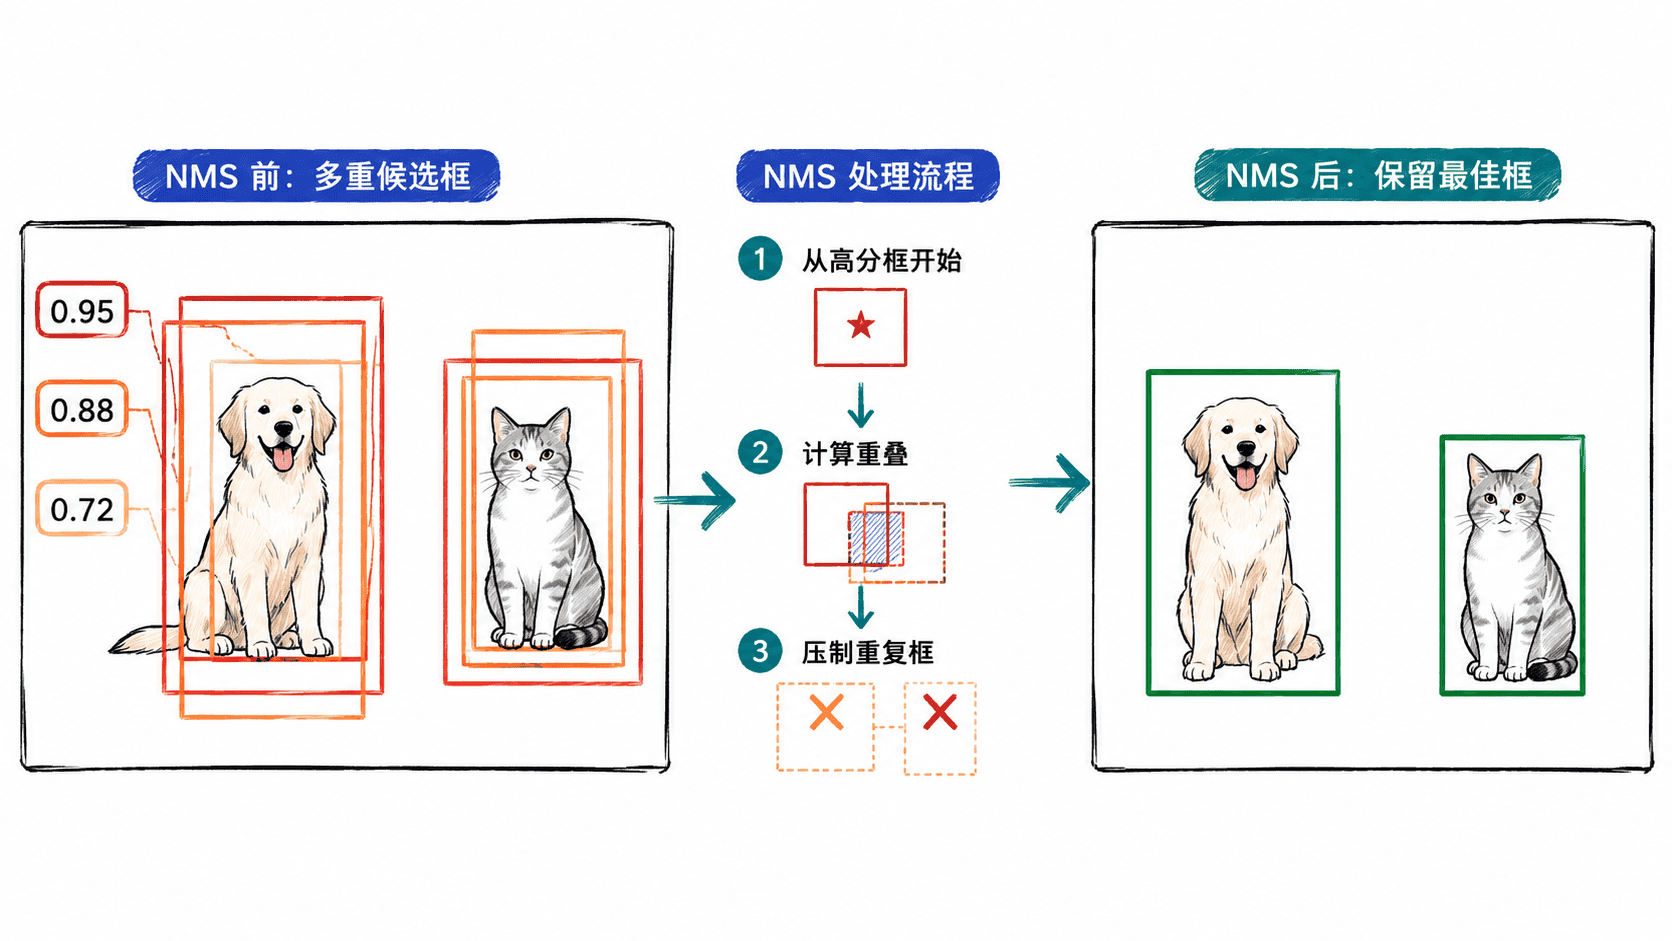
IoU 越接近 1,两个框越重叠。nms_threshold 越小,抑制越激进;越大,则允许更多相互重叠的框同时保留。它和 score_threshold 的作用不同,不能混为一个阈值。
用 OpenCV 执行 NMS
cv2.dnn.NMSBoxes 接收的边界框格式为 [x, y, width, height]。下面构造两组高度重叠的候选框,并将 NMS 返回的索引统一整理为一维整数列表,以兼容不同 OpenCV Python 版本的返回形态。
import cv2
import numpy as np

boxes = [
    [50, 50, 180, 120],
    [60, 58, 175, 118],
    [310, 60, 160, 110],
    [320, 65, 158, 105],
]
scores = [0.95, 0.88, 0.91, 0.72]

indices = cv2.dnn.NMSBoxes(
    bboxes=boxes,
    scores=scores,
    score_threshold=0.5,
    nms_threshold=0.4,
)

kept = np.asarray(indices).reshape(-1).astype(int).tolist()
print("保留索引:", kept)
for index in kept:
    print(index, boxes[index], scores[index])
预期输出
保留索引: [0, 2]
0 [50, 50, 180, 120] 0.95
2 [310, 60, 160, 110] 0.91
索引 1 与索引 0 高度重叠且分数更低,因此被压制;索引 3 同理被索引 2 压制。真实模型的候选框数量更多,但处理逻辑不变。
正确设置两个阈值
score_threshold 解决“这个检测结果是否足够可信”,通常先依据验证集上的精确率与召回率选择。nms_threshold 解决“两个可信框是否其实指向同一目标”,需要结合目标密度和框的定位质量调整。
调参时应固定模型和测试集,每次只修改一个阈值,并记录保留框数量与漏检、重复检测的变化,避免仅凭单张图片判断。
多类别检测的边界
普通 NMSBoxes 不理解类别语义。如果两个不同类别的框位置几乎一致,把所有框一起做 NMS 可能错误地删除其中一个类别。常见做法是先按 class_id 分组,再对每个类别分别执行 NMS;只有明确希望不同类别相互竞争时,才使用类别无关 NMS。
因此,完整后处理顺序通常是先解码模型输出,再过滤低置信度候选框,随后按需要分组执行 NMS,最后才绘制或返回检测结果。这样能把模型产生的密集候选框转换成稳定、可解释的最终检测框。