
嵌入式 Linux 与 RTOS / 系统课时
完成可观测实时控制项目
完成可观测实时控制项目
这节课把周期采样、DMA、任务通信、互斥、超时、统计和低功耗组合成一个最小实时控制项目,并通过 CPU、栈、堆、响应时延和错误计数观测点完成压力与故障验收。
学习目标
- 组织采样、处理、输出和监控任务之间的数据流与同步关系。
- 为 CPU、栈、堆、时延和错误建立可持续采集的观测点。
- 用压力测试和故障测试判断系统是否满足预先定义的实时预算。
先确定最小系统结构
项目采用一个典型闭环:定时器触发 ADC DMA 采样,DMA 完成中断只负责交付缓冲区;处理任务计算结果后通过队列发送给控制任务;控制任务使用互斥量访问共享外设;监控任务周期统计资源和错误;空闲路径负责进入低功耗。
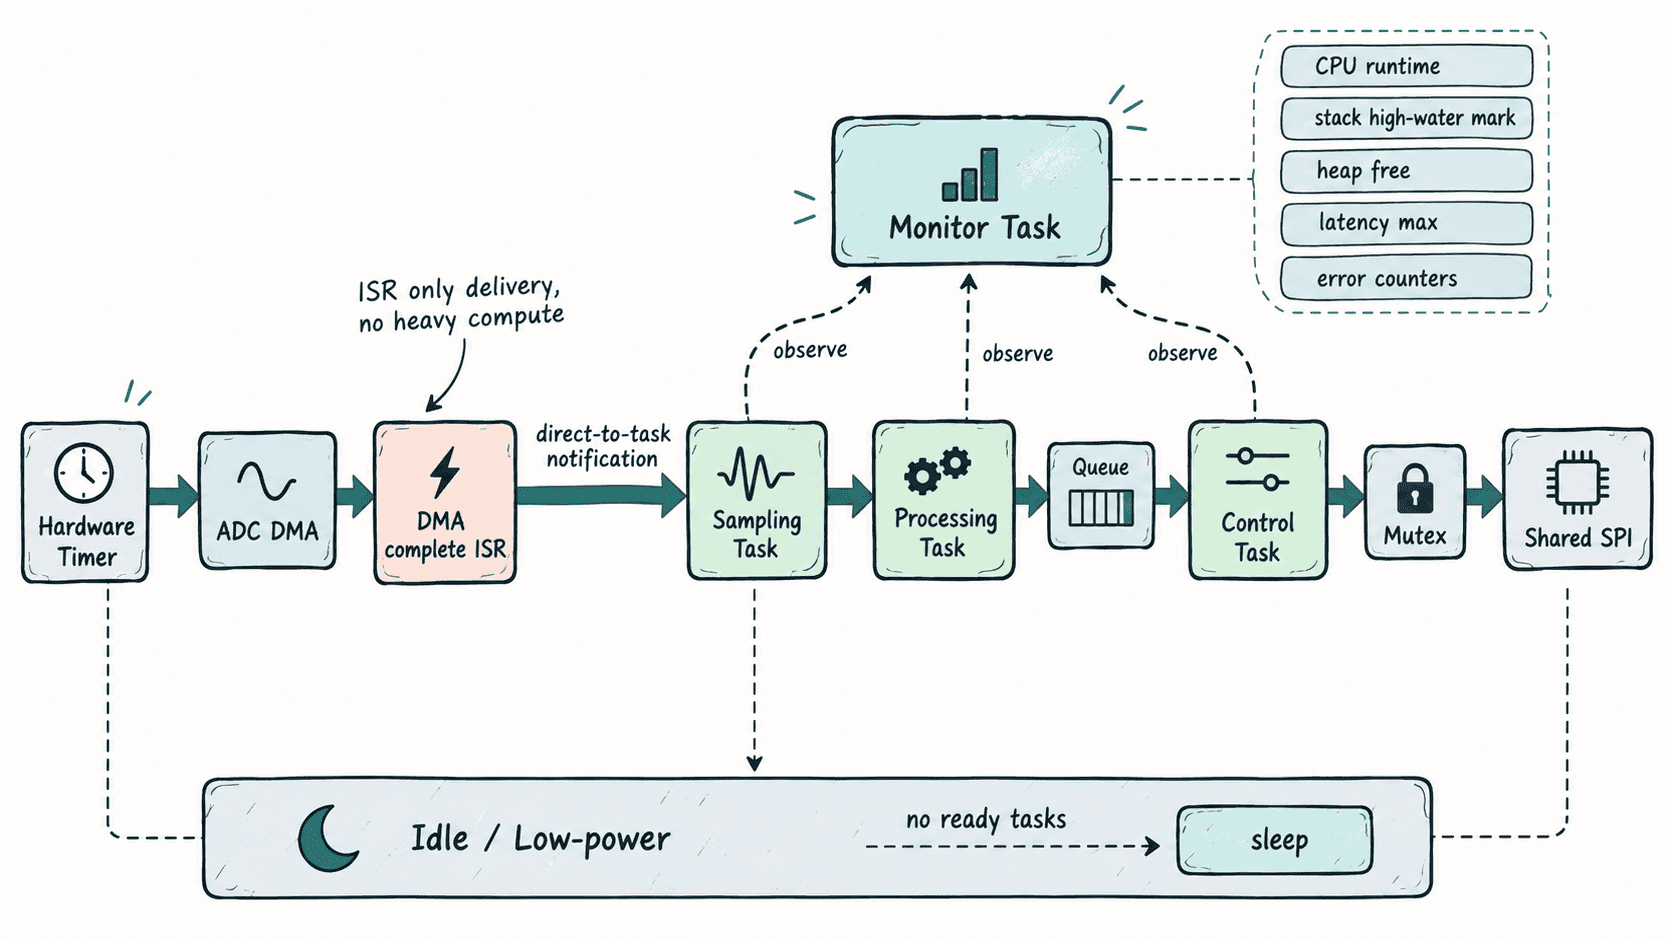
这套结构有两个关键边界:ISR 只做最短路径的数据交付;共享外设只允许通过一个明确的互斥或单一拥有者访问。这样才能同时控制中断延迟和并发访问风险。
建立任务与通信骨架
下面是片段示例,展示项目核心对象和任务间通信关系。它依赖具体 MCU 的 ADC、DMA、SPI 和低功耗驱动,但 FreeRTOS 对象与调度关系可以直接复用。
#include "FreeRTOS.h"
#include "task.h"
#include "queue.h"
#include "semphr.h"
#include <stdint.h>
#include <stdio.h>

typedef struct {
    uint16_t sample;
    TickType_t capture_tick;
} SampleMsg;

typedef struct {
    int32_t output;
    TickType_t capture_tick;
} ControlMsg;

static TaskHandle_t g_sample_task;
static QueueHandle_t g_sample_queue;
static QueueHandle_t g_control_queue;
static SemaphoreHandle_t g_spi_mutex;
static volatile uint16_t g_dma_sample;
static volatile uint32_t g_queue_drop_count;
static volatile uint32_t g_peripheral_error_count;
static volatile TickType_t g_max_latency_ticks;

void adc_dma_complete_isr(uint16_t sample)
{
    BaseType_t high_priority_woken = pdFALSE;

    /* ISR 只保存 DMA 结果并唤醒任务,不在中断里做控制计算。 */
    g_dma_sample = sample;
    vTaskNotifyGiveFromISR(g_sample_task, &high_priority_woken);
    portYIELD_FROM_ISR(high_priority_woken);
}

static void sample_task(void *arg)
{
    (void)arg;
    for (;;) {
        ulTaskNotifyTake(pdTRUE, portMAX_DELAY);

        SampleMsg msg = {
            .sample = g_dma_sample,
            .capture_tick = xTaskGetTickCount()
        };

        if (xQueueSend(g_sample_queue, &msg, 0) != pdPASS) {
            ++g_queue_drop_count;
        }
    }
}

static void processing_task(void *arg)
{
    (void)arg;
    SampleMsg in;
    for (;;) {
        if (xQueueReceive(g_sample_queue, &in, portMAX_DELAY) == pdPASS) {
            ControlMsg out = {
                .output = (int32_t)in.sample - 2048,
                .capture_tick = in.capture_tick
            };
            xQueueSend(g_control_queue, &out, portMAX_DELAY);
        }
    }
}
预期结果
DMA completion -> sampling task notified
sample message -> processing queue
control message -> control queue
这不是串口必须打印出的固定日志,而是代码运行时应出现的数据路径。实际样本值、任务切换时刻和队列深度会随硬件与负载变化。
把控制链路的时延量出来
实时系统不能只验证“结果对不对”,还要验证结果是否在截止时间前到达。最简单的方法是在采样时记录 TickType_t,控制任务完成外设写入后计算端到端延迟,并维护最大值。
下面是片段示例,依赖上一段的 ControlMsg、g_control_queue、g_spi_mutex 和统计变量;真实项目把注释位置替换为实际 SPI 驱动调用。
static void control_task(void *arg)
{
    (void)arg;
    ControlMsg msg;

    for (;;) {
        if (xQueueReceive(g_control_queue, &msg, portMAX_DELAY) != pdPASS) {
            continue;
        }

        if (xSemaphoreTake(g_spi_mutex, pdMS_TO_TICKS(5)) != pdPASS) {
            ++g_peripheral_error_count;
            continue;
        }

        /* 这里替换为真实 SPI 写入,并确保驱动自身也有超时。 */
        xSemaphoreGive(g_spi_mutex);

        TickType_t latency = xTaskGetTickCount() - msg.capture_tick;
        if (latency > g_max_latency_ticks) {
            g_max_latency_ticks = latency;
        }
    }
}
预期结果
max_latency_ticks increases only when a slower end-to-end sample appears
queue_drop_count remains 0 under nominal load
如果 configTICK_RATE_HZ 为 1000,则 1 tick 约等于 1 ms;如果使用更粗的 tick,亚毫秒预算应改用 DWT cycle counter、GPT timer 或芯片高精度计时器,不能用 RTOS tick 代替。
周期采集 CPU、栈与堆
监控任务不应高频运行,它只需要以较低优先级周期采样。CPU 占用可以来自 FreeRTOS run-time stats;栈余量使用 uxTaskGetStackHighWaterMark();堆余量使用 xPortGetFreeHeapSize(),并同时观察 xPortGetMinimumEverFreeHeapSize()。
下面是片段示例,假设已经启用 FreeRTOS run-time stats,并为 vTaskGetRunTimeStats() 提供了运行时间计数源。
static void monitor_task(void *arg)
{
    (void)arg;
    char stats[512];

    for (;;) {
        vTaskGetRunTimeStats(stats);

        printf("heap_free=%u heap_min=%u max_latency=%lu drops=%lu periph_err=%lu\n",
               (unsigned)xPortGetFreeHeapSize(),
               (unsigned)xPortGetMinimumEverFreeHeapSize(),
               (unsigned long)g_max_latency_ticks,
               (unsigned long)g_queue_drop_count,
               (unsigned long)g_peripheral_error_count);

        printf("%s\n", stats);
        vTaskDelay(pdMS_TO_TICKS(1000));
    }
}
预期输出
heap_free=<HEAP_BYTES> heap_min=<MIN_HEAP_BYTES> max_latency=<TICKS> drops=0 periph_err=0
<TaskName> <RunTimeCounter> <CPUPercent><HEAP_BYTES>、<MIN_HEAP_BYTES>、<TICKS> 和 run-time stats 数值取决于工程配置与实际负载。栈高水位应针对关键任务单独采集,因为总堆余量正常并不能证明某个任务没有逼近栈溢出。
给项目设定可验收预算
观测数据只有和预算比较才有意义。可以为项目先定义一组明确门槛,例如:
| 指标 | 示例预算 | 验证方法 |
|---|---|---|
| 控制端到端最大时延 | 小于 10 ms | 记录最大采样到输出延迟 |
| 控制任务栈余量 | 至少 25% | 检查 high-water mark |
| 最低历史剩余堆 | 大于 4 KB | xPortGetMinimumEverFreeHeapSize() |
| 正常负载队列丢包 | 0 | 观察 g_queue_drop_count |
| 外设超时 | 0 或低于允许阈值 | 错误计数器 |
| CPU 持续占用 | 低于设定上限 | run-time stats |
预算数字应来自实际控制周期、芯片资源和安全要求,而不是照抄示例。最重要的是在压力前就确定通过条件,否则测试结束后很容易用结果反向修改标准。
做压力与故障验收
压力测试应逐步提高负载,而不是一开始就把所有路径压满。先提高采样频率,再增加通信量和外设访问冲突,持续观察最大时延、队列丢包、栈余量和最低堆余量。如果某个指标开始逼近预算,就记录对应负载点。
故障测试则主动制造 DMA 超时、SPI 无响应、消费者任务短时阻塞和队列拥塞,确认错误计数上升、局部恢复执行、关键任务仍保持调度。如果故障升级到复位,启动后必须能读取上一次复位原因。
低功耗也要纳入验收。仅在没有更高优先级任务就绪、下一次唤醒时间已知且外设状态允许时进入 sleep;唤醒后重新观察控制时延,确认低功耗切换没有把第一笔采样推迟到预算之外。
项目达到可交付状态的标志,不只是功能跑通,而是正常负载下关键预算有余量,压力增加时能看到指标如何恶化,故障发生时能看到保护路径如何动作,并且每次异常都能留下足够的诊断数据。