
嵌入式 Linux 与 RTOS / 系统课时
做一次故障注入与恢复验证
做一次故障注入与恢复验证
这节课把“系统会不会恢复”变成可重复验证的问题:主动注入任务卡死、队列拥塞、堆分配失败和外设无响应,观察超时、断言、看门狗与复位路径,并确认故障发生后仍能留下足够诊断信息。
学习目标
- 设计可控、可撤销的故障注入点,并让注入过程不破坏正常测试环境。
- 区分可局部恢复与必须系统复位的故障,并为两类故障定义明确动作。
- 用日志、计数器和看门狗证据确认恢复路径确实被执行。
先定义故障与预期恢复动作
故障注入不是“让程序随机崩掉”,而是人为制造已知失败条件,再核对系统是否按设计响应。最实用的做法是先列出故障、检测机制和恢复动作,避免测试结束后只看到“重启了”,却不知道触发了哪条保护链。
| 故障 | 检测机制 | 首选恢复 | 升级条件 |
|---|---|---|---|
| 任务卡死 | 心跳超时、看门狗 | 记录任务信息并受控复位 | 心跳连续丢失 |
| 队列拥塞 | xQueueSend() 超时 |
丢弃非关键数据或退避重试 | 拥塞持续超预算 |
| 堆分配失败 | pvPortMalloc() 返回空或 malloc failed hook |
释放可回收资源、拒绝新业务 | 核心路径无法继续 |
| 外设无响应 | 驱动等待超时 | 外设复位并有限次重试 | 多次复位仍失败 |
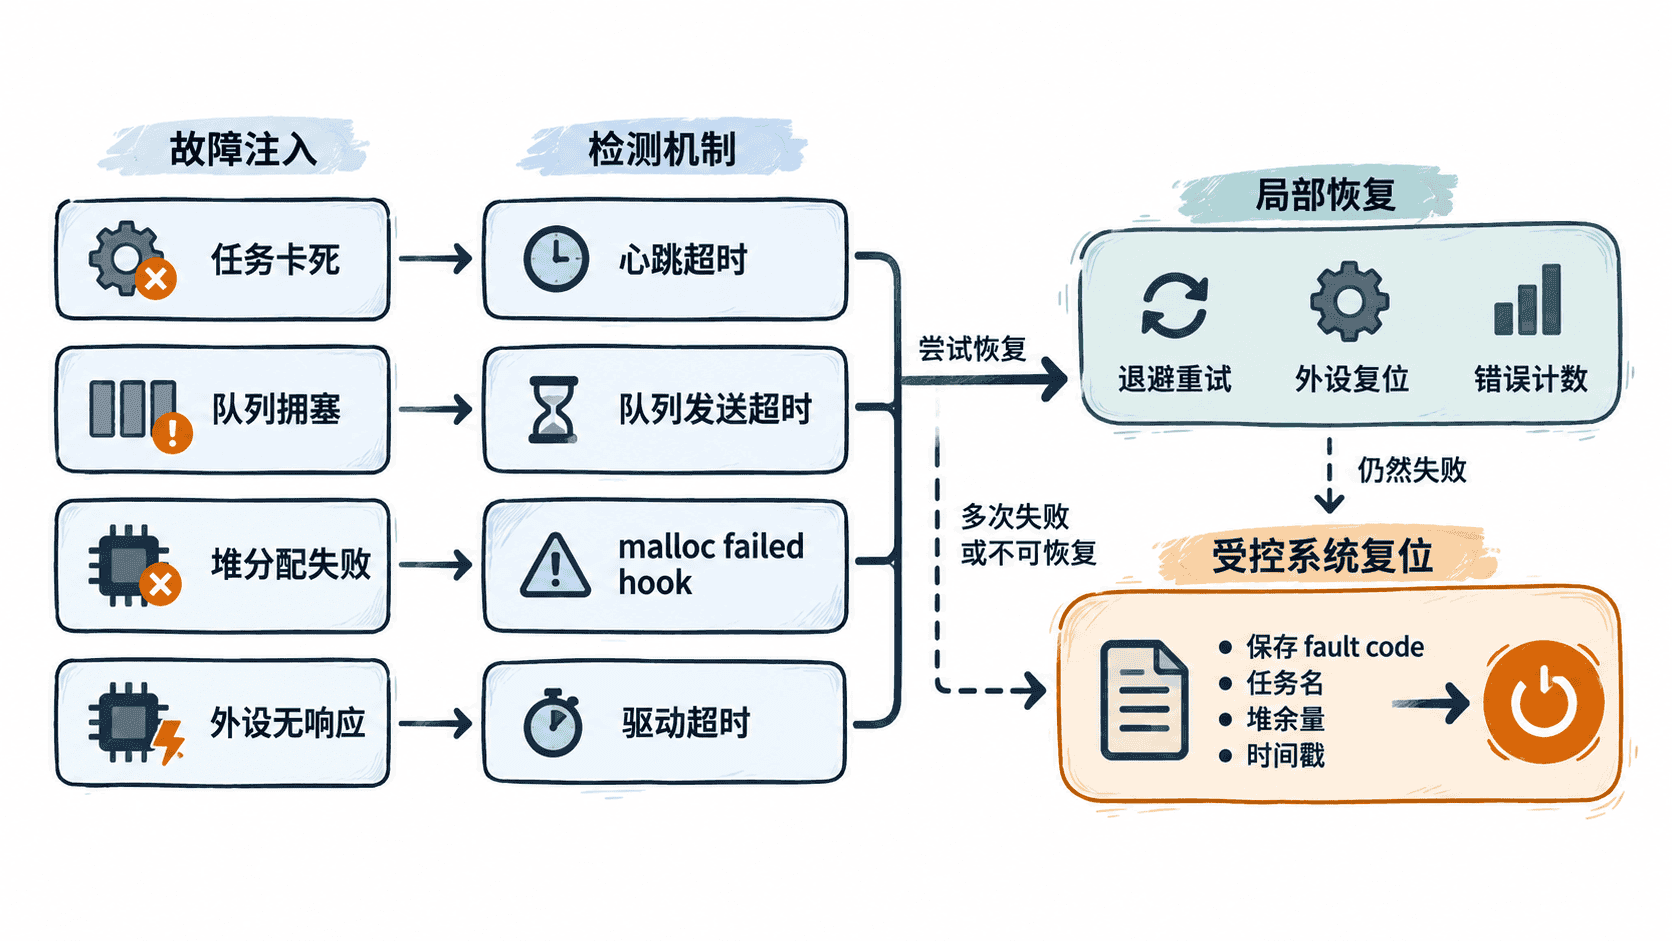
关键原则是每个注入点都要有退出条件。例如队列拥塞测试可以限制为 5 秒,外设无响应只注入 2 次,避免测试故障本身把系统永久锁死。
建立可控的注入开关
下面是片段示例,需放入已有 FreeRTOS 工程,并接入串口日志。它集中保存故障开关,使任务只在测试模式下改变行为。
#include "FreeRTOS.h"
#include "task.h"
#include "queue.h"
#include <stdbool.h>
#include <stdint.h>
#include <stdio.h>

typedef struct {
    volatile bool stall_worker;
    volatile bool block_peripheral;
    volatile bool force_alloc_fail;
} FaultInject;

static FaultInject g_fault = {0};
static QueueHandle_t g_queue;

static void worker_task(void *arg)
{
    (void)arg;
    for (;;) {
        if (g_fault.stall_worker) {
            /* 故意不刷新业务心跳,模拟任务失去进展。 */
            vTaskDelay(pdMS_TO_TICKS(1000));
            continue;
        }

        printf("worker alive\n");
        vTaskDelay(pdMS_TO_TICKS(500));
    }
}

static void queue_flood_task(void *arg)
{
    (void)arg;
    uint32_t value = 1;
    for (;;) {
        BaseType_t ok = xQueueSend(g_queue, &value, pdMS_TO_TICKS(20));
        if (ok != pdPASS) {
            printf("queue timeout\n");
        }
        vTaskDelay(pdMS_TO_TICKS(5));
    }
}
预期输出
worker alive
worker alive
queue timeout
queue timeout
这段代码不直接执行芯片复位,而是把“失去进展”和“拥塞”变成稳定可重复的输入条件。外设阻塞与分配失败也应使用同样的显式开关,避免通过破坏驱动内部状态来制造不可控故障。实际日志时间与出现次数会因调度节拍和任务优先级不同而变化。
让检测链真正触发
对于任务卡死,不应只判断任务是否仍被调度,因为任务可能持续获得 CPU 却陷入错误循环。更可靠的方法是让关键任务在完成一次有效工作后递增心跳计数,由独立监督任务检查计数是否变化。
下面是片段示例,依赖上一段的 g_fault,最终复位动作需要替换为目标芯片的平台层 API 或硬件看门狗路径。
static volatile uint32_t g_worker_heartbeat;

static void monitored_worker_task(void *arg)
{
    (void)arg;
    for (;;) {
        if (!g_fault.stall_worker) {
            ++g_worker_heartbeat;
        }
        vTaskDelay(pdMS_TO_TICKS(200));
    }
}

static void supervisor_task(void *arg)
{
    (void)arg;
    uint32_t last = g_worker_heartbeat;
    uint32_t missed = 0;

    for (;;) {
        vTaskDelay(pdMS_TO_TICKS(500));

        uint32_t now = g_worker_heartbeat;
        if (now == last) {
            ++missed;
            printf("heartbeat missed: %lu\n", (unsigned long)missed);
        } else {
            missed = 0;
        }
        last = now;

        if (missed >= 3) {
            printf("fatal: worker stalled, request controlled reset\n");
            /* 保存诊断信息后停止喂硬件看门狗,等待受控复位。 */
            taskDISABLE_INTERRUPTS();
            for (;;) {
            }
        }
    }
}
预期输出
heartbeat missed: 1
heartbeat missed: 2
heartbeat missed: 3
fatal: worker stalled, request controlled reset
如果系统没有独立硬件看门狗,最后这条路径必须改成芯片提供的系统复位 API,不能把无限循环当成最终恢复方案。监督任务本身还应被独立看门狗或更高层健康机制覆盖,避免单点失效。
区分局部恢复与系统复位
外设无响应通常先尝试局部恢复,因为重新初始化 SPI、I2C、UART 或传感器的代价远低于整机重启。推荐设置有限重试次数,并在每次失败后增加退避时间;超过次数后再升级到系统复位。
队列拥塞通常也不需要立刻重启。先确认消息是否允许丢弃、生产速度是否失控、消费者是否被更高优先级任务长期压制。对遥测、统计类消息可以丢弃并递增 drop_count;对控制命令则应报告错误或进入降级模式。
堆分配失败要根据使用场景判断严重性。若动态分配只用于非关键诊断功能,可以拒绝该功能继续运行;若失败发生在创建关键通信对象、控制任务或安全相关缓冲区时,应视为不可恢复故障。
在复位前保存最小诊断信息
受控复位前不要尝试“完整写日志”,因为故障时文件系统、网络或中断链路本身可能已经不可靠。优先保存少量、固定大小、写入路径短的信息,例如故障码、任务名、剩余堆、重启原因和单调计数器。
可把这些数据写入备份 SRAM、RTC backup register、片上保留区或带掉电保护的小型日志区。系统启动后第一时间读取并上报,再清除“未消费”的故障记录。
至少检查以下结果是否成立:
- 注入任务卡死后,监督任务能在预算时间内发现心跳停止。
- 注入队列拥塞后,发送超时被计数,关键任务没有永久阻塞。
- 外设超时后只执行有限次复位和重试,不形成无限重试循环。
- 不可恢复故障触发复位前,诊断字段已写入保留区。
- 重启后能区分正常上电与故障恢复启动,并读取上一次故障原因。
一次有效的故障注入测试,最终证明的不是“系统可以重启”,而是故障能被检测、恢复动作有边界、复位前保留证据,并且恢复后的系统重新回到可观测、可控制状态。