
嵌入式 Linux 与 RTOS / 系统课时
用 DMA 完成事件后移处理
用 DMA 完成事件后移处理
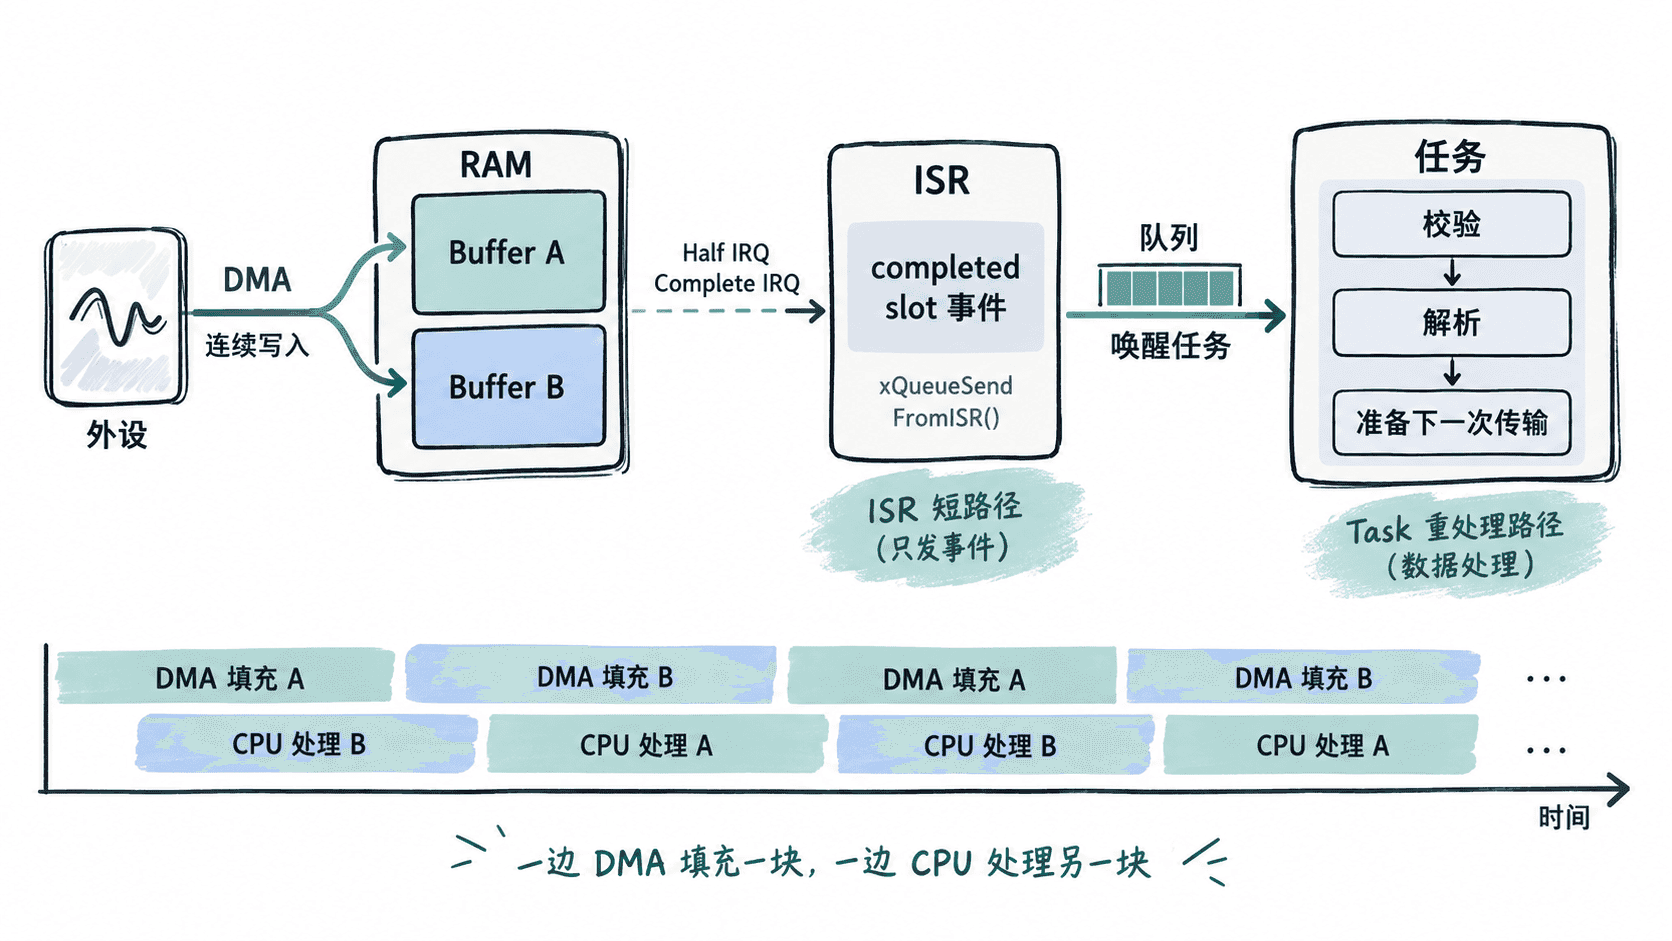
DMA 的价值不只是“少搬几次数据”,更重要的是把外设搬运与 CPU 处理解耦。本节会把 DMA 完成中断压缩成“记录哪一块数据完成并唤醒任务”,再由任务完成校验、解析与后续准备,并用双缓冲避免 CPU 忙等。
学习目标
- 把 DMA ISR 控制在最短路径,只记录完成事件并唤醒 FreeRTOS 任务。
- 用半缓冲、双缓冲或环形缓冲让 DMA 搬运与任务处理并行。
- 识别处理不及时、队列溢出和错误重启导致的数据覆盖风险。
为什么要把重活移出 ISR
DMA 完成中断发生时,数据已经由外设搬到内存,CPU 不需要再在 ISR 中做校验、协议解析或大块复制。ISR 越长,越容易拖延其他高优先级中断,也会扩大系统最坏响应时间。
合适的分工是:ISR 只确认“哪一块数据可用”,把这个事件送给任务并尽快退出;任务再执行耗时逻辑。若后续处理必须调用可能阻塞的驱动、互斥锁或普通 FreeRTOS API,更不能留在 ISR 中。
用队列传递已完成缓冲区
下面是片段示例,假设工程已经启用 FreeRTOS,并把外设 DMA 配成循环接收。DMA 前半区和后半区分别视为两个槽位;厂商驱动的半完成与完成回调只需转调这里的 ISR 辅助函数,真正的数据处理全部发生在任务上下文。
#include "FreeRTOS.h"
#include "queue.h"
#include "task.h"
#include <stddef.h>
#include <stdint.h>

#define RX_BUFFER_SIZE 512U
#define RX_HALF_SIZE   (RX_BUFFER_SIZE / 2U)

typedef struct {
    uint8_t slot;
    size_t length;
} DmaEvent;

static uint8_t rxBuffer[RX_BUFFER_SIZE];
static QueueHandle_t dmaEventQueue;
static volatile uint32_t dmaEventDropCount;

static void validate_and_parse(const uint8_t *data, size_t length);
static void prepare_next_transfer(void);

void DmaWorkerTask(void *argument)
{
    DmaEvent event;

    for (;;) {
        if (xQueueReceive(dmaEventQueue, &event, portMAX_DELAY) == pdPASS) {
            const uint8_t *block = &rxBuffer[event.slot * RX_HALF_SIZE];
            validate_and_parse(block, event.length);
            prepare_next_transfer();
        }
    }
}

static void post_dma_event_from_isr(uint8_t slot)
{
    BaseType_t higherPriorityTaskWoken = pdFALSE;
    DmaEvent event = { .slot = slot, .length = RX_HALF_SIZE };

    if (xQueueSendFromISR(dmaEventQueue, &event, &higherPriorityTaskWoken) != pdPASS) {
        dmaEventDropCount++;
    }

    portYIELD_FROM_ISR(higherPriorityTaskWoken);
}

void DmaHalfCompleteISR(void)
{
    post_dma_event_from_isr(0U);
}

void DmaCompleteISR(void)
{
    post_dma_event_from_isr(1U);
}
预期结果
DMA 填充前半区 -> ISR 投递 slot 0 -> 任务处理前半区
DMA 继续填充后半区 -> ISR 投递 slot 1 -> 任务处理后半区
ISR 不执行协议解析,也不等待 DMA 或外设
实际工程还需要在初始化阶段创建 dmaEventQueue、启动循环 DMA,并从芯片厂商的真实 DMA 回调或 IRQ 入口调用这两个辅助函数。若 dmaEventDropCount 持续增长,说明任务消费速度跟不上数据到达速度,不能只把队列调大后忽略根因。
双缓冲和环形缓冲怎么选
双缓冲适合“块大小固定、一次处理一块”的采集,例如 ADC 批量采样、UART 固定帧或 SPI 分块传输。DMA 写 A 时任务处理 B,下一轮交换角色,最容易验证数据所有权。
环形缓冲更适合连续字节流和帧长不固定的协议。此时 ISR 记录“写指针推进到哪里”,任务维护自己的读指针并解析完整帧。无论哪种结构,都要保证任务不会读取 DMA 正在覆盖的区域。
验证处理是否真的后移
调试时可以分别统计 DMA 中断次数、任务处理次数和队列丢弃次数。正常情况下,中断次数与完成块数对应,任务处理次数最终追平中断次数,而丢弃次数保持为零。
若数据偶发损坏,先检查任务是否处理了仍在被 DMA 写入的内存;若事件持续丢失,再检查任务优先级、单块处理时间和缓冲深度。真正可靠的目标不是“ISR 越短越好”这一句口号,而是让缓冲区所有权、事件数量和最坏处理时间都可以被验证。