
嵌入式 Linux 与 RTOS / 系统课时
控制高频中断调度风暴
控制高频中断调度风暴
高频采样、串口或网络中断如果每次都唤醒任务,会把大量 CPU 时间消耗在调度与上下文切换上。本节用事件速率和任务处理能力识别“持续追赶”,再用批处理、水位、DMA 与延迟处理把唤醒频率降下来。
学习目标
- 根据事件速率、单项处理时间和固定唤醒开销判断系统是否会持续积压。
- 能用批处理、水位触发、DMA 和任务延迟处理降低中断后的调度频率。
- 能通过唤醒次数、积压深度和空闲余量验证优化是否真正生效。
先确认风暴来自哪里
高频中断本身不一定有问题,真正危险的是“每个事件都导致一次任务切换”。一次事件的成本可以拆成两部分:处理数据本身的成本,以及从 ISR 唤醒任务、调度、恢复上下文带来的固定成本。可用近似式 估算 CPU 占用,其中 是事件速率, 是单个事件处理时间, 是任务唤醒速率, 是每次唤醒的固定开销。
例如事件速率为 20000 次/秒,单项处理为 3 微秒,每次唤醒固定开销为 12 微秒。若每个事件都唤醒一次任务,估算占用约为 30%;若每 16 个事件唤醒一次,单项处理成本不变,但固定开销部分降到原来的 1/16,总占用约为 7.5%。
把唤醒频率与事件频率解耦
理想目标不是“让中断更少”,而是让一次调度处理更多有效工作。常见做法是:外设持续产生事件,DMA 或环形缓冲先吸收数据,只有达到半满、满、水位或超时条件时才通知任务,任务被唤醒后一次性清空一批数据。
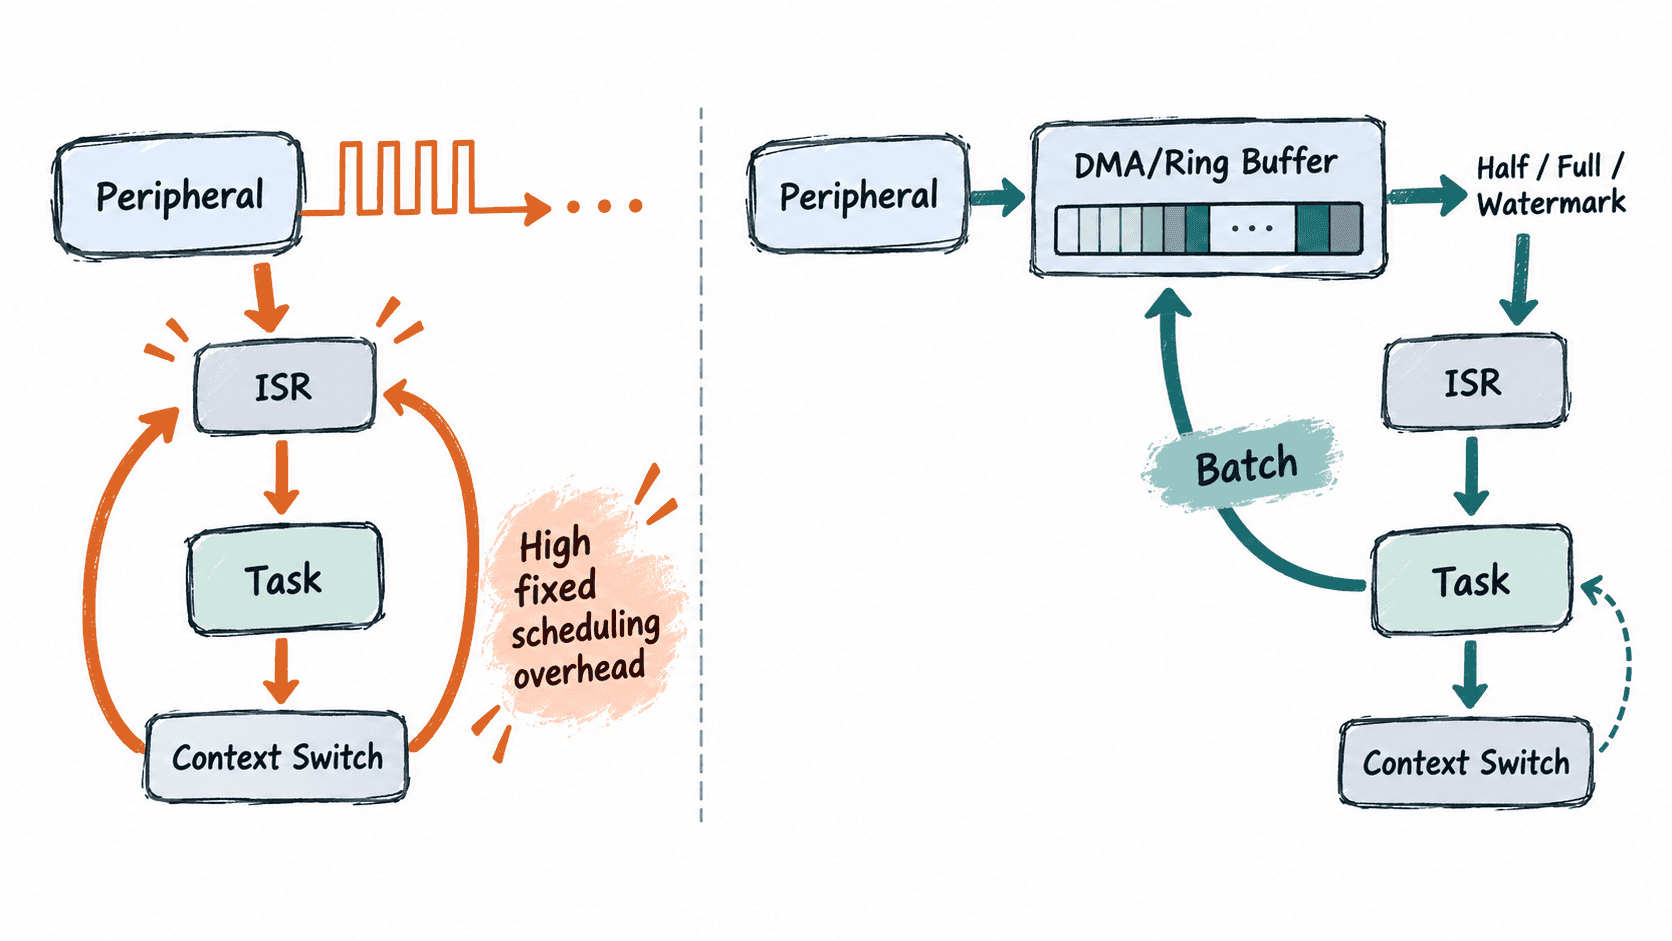
可以按硬件能力组合四种手段:DMA 负责搬运,水位决定何时通知,任务通知负责低成本唤醒,延迟处理把协议解析、校验和复制放到任务上下文。这样既缩短 ISR,也避免把调度器当成“每字节回调器”。
用任务通知承接延迟处理
片段示例:下面假定芯片 DMA 驱动已经提供 dma_clear_irq_flag()、dma_has_ready_block()、process_ready_dma_block() 和 dma_start_with_half_full_interrupts()。关键点是 DMA 只在半满或满边界触发中断,ISR 只做清标志与任务通知,批量工作留给任务。
#include "FreeRTOS.h"
#include "task.h"

static TaskHandle_t xRxTask = NULL;

void DMA_RX_IRQHandler(void)
{
    BaseType_t xHigherPriorityTaskWoken = pdFALSE;

    dma_clear_irq_flag();
    vTaskNotifyGiveFromISR(xRxTask, &xHigherPriorityTaskWoken);
    portYIELD_FROM_ISR(xHigherPriorityTaskWoken);
}

static void vRxTask(void *pvParameters)
{
    (void) pvParameters;

    for (;;)
    {
        ulTaskNotifyTake(pdTRUE, portMAX_DELAY);

        do
        {
            process_ready_dma_block();
        } while (dma_has_ready_block());
    }
}

void AppStart(void)
{
    xTaskCreate(vRxTask, "rx", 512, NULL,
                tskIDLE_PRIORITY + 2, &xRxTask);
    dma_start_with_half_full_interrupts();
}
预期结果:在相同输入流量下,任务唤醒次数应接近 DMA 半满/满或水位中断次数,而不是接近原始事件数;任务每次醒来能处理多个数据项,ISR 执行时间保持短且稳定。
在吞吐与延迟之间定水位
批量越大,固定调度成本越低,但单个事件等待进入任务的时间越长。选择水位时要同时看实时性上限和可接受的 CPU 预算,而不是单纯追求最大批次。
对低延迟控制事件,应保持较低水位,必要时仍允许立即唤醒;对音频、采样、串口连续流,更适合 DMA 半满/满;对突发但不连续的流量,可以把“达到水位”和“等待超时”组合起来,既保证吞吐,也避免少量数据长期滞留。
验证是否退出持续追赶
验证时至少记录四个量:ISR 次数、任务实际唤醒次数、每次批量处理的数据项数、队列或环形缓冲的最大积压。优化有效时,事件速率可以保持不变,但唤醒速率显著下降,积压在突发后能够回落,系统仍有可观测的空闲时间。
还要做持续满载测试,而不是只看几秒钟的平均值。如果缓冲深度不断增长、任务长期不再阻塞,或处理延迟一轮比一轮大,系统仍处于持续追赶。此时继续增大批量只能推迟溢出,真正的修复应转向降低每项处理成本、增加硬件卸载能力或限制输入速率。