
架构与系统设计 / 系统课时
避免重试风暴放大局部故障
避免重试风暴放大局部故障
重试能掩盖瞬时错误,但当网关、业务服务和下游客户端都各自重试时,一个失败请求会被指数级复制。局部依赖只是变慢,整套系统却可能因为新增流量被彻底压垮。治理重点不是“是否重试”,而是限制次数、控制节奏并明确唯一责任层。
学习目标
- 计算多层重试带来的请求倍增效应
- 会用重试上限、指数退避和抖动降低同步冲击
- 能为一条调用链确定清晰的重试责任层
多层重试为什么会失控
假设调用链有三层,每层都允许“最多尝试 3 次”。最坏情况下,上层的一次尝试会触发中层 3 次,而中层每次又触发下层 3 次,最终一个用户请求可能在最底层形成 次尝试。
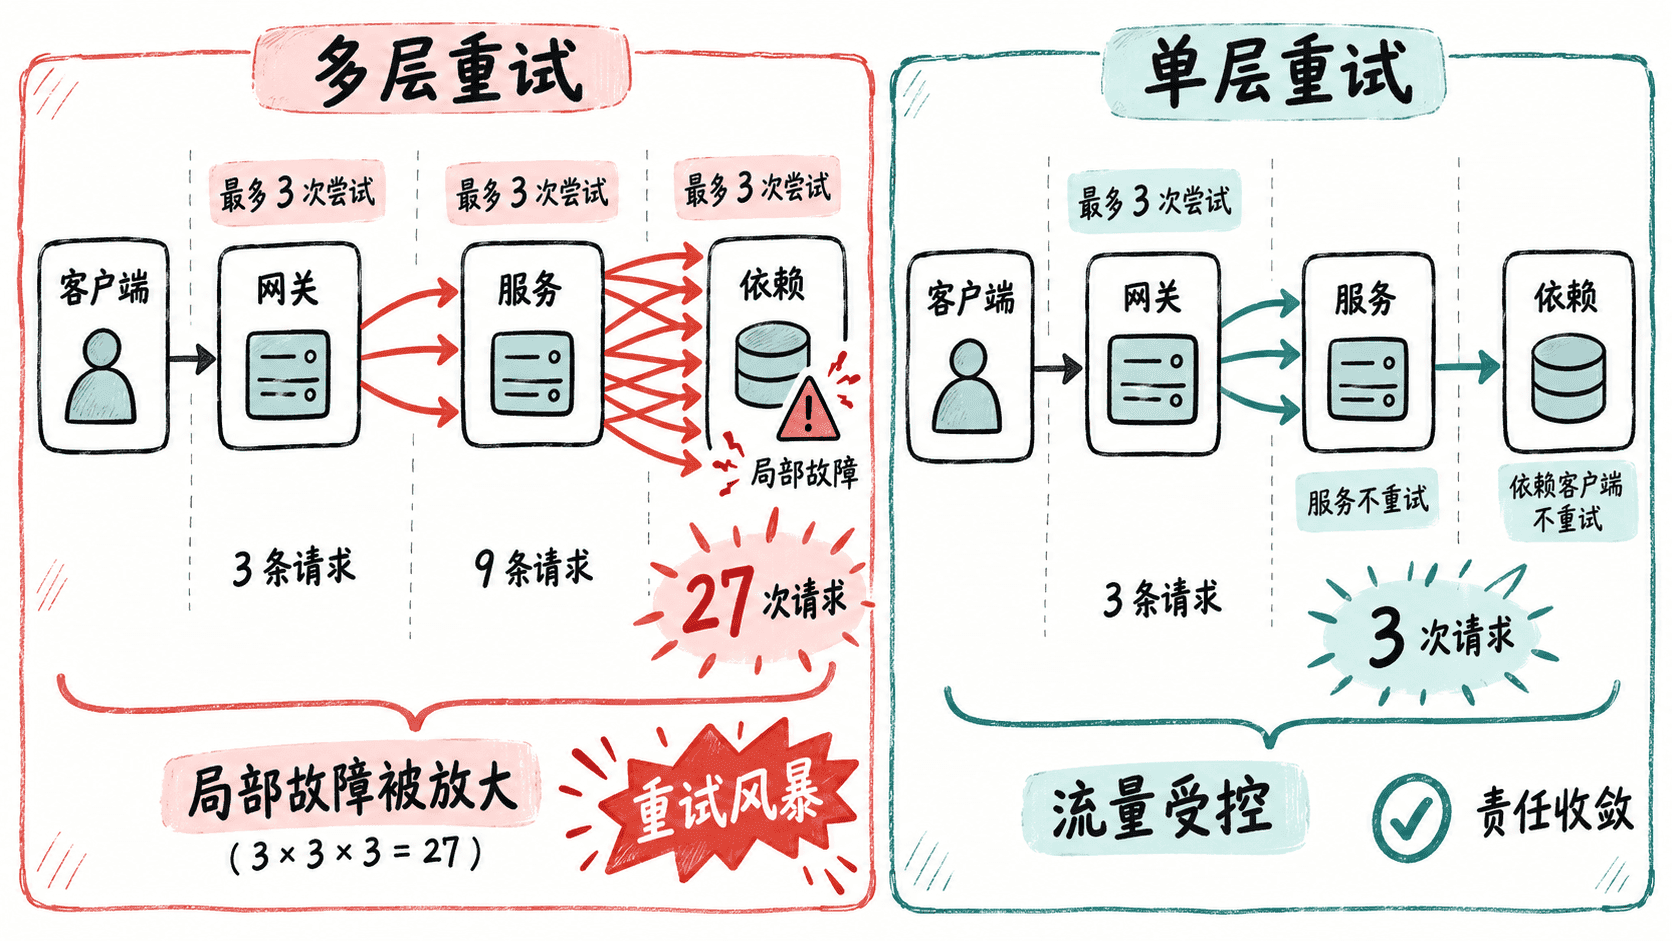
下面的 Python 程序直接计算不同层级策略的最坏尝试次数。
from math import prod


def downstream_attempts(max_attempts_per_layer):
    return prod(max_attempts_per_layer)


multi_layer = downstream_attempts([3, 3, 3])
edge_only = downstream_attempts([3, 1, 1])

print(f"multi-layer retries: {multi_layer}")
print(f"edge-only retries: {edge_only}")
预期输出
multi-layer retries: 27
edge-only retries: 3
这里的 27 只是单个原始请求的最坏值。如果同一时刻有 1000 个请求遇到同一故障,多层重试理论上可能把最下游尝试数推到 27000 次,进一步拉长队列和响应时间。
先决定谁有资格重试
一条调用链通常只让最了解业务语义、剩余 Deadline 和幂等性的那一层承担主要重试责任。其他层可以把错误向上传递,而不是每层都“自救”。
适合重试的通常是短暂网络错误、明确的限流或临时不可用,并且操作必须满足幂等性或具备幂等键。认证失败、参数错误、确定性的业务拒绝不应重试。若请求剩余 Deadline 已不足以完成下一次尝试,也应立即停止。
退避和抖动用来打散同步请求
固定间隔重试会让大量客户端在同一时刻再次冲击故障节点。更稳妥的策略是指数退避,例如基础等待 100 ms,随后扩大为 200 ms、400 ms,同时加入随机抖动,让不同请求分散到不同时间点。
重试延迟还必须服从总 Deadline。一次操作只剩 250 ms 预算时,就不应安排“等待 400 ms 后再试”。因此实际判断顺序应是:确认错误可重试,检查幂等性,计算下一次退避,确认剩余预算足够,再发起下一次尝试。
用预算而不是本能决定重试次数
可以同时设置三个上限:单请求最大尝试次数、整链路 Deadline,以及服务级重试预算。重试预算用于限制“当前总流量中有多少比例可以是重试流量”,防止故障期间所有请求都进入重试路径。
当下游开始超时或限流时,先降低新增重试,而不是继续提高次数。配合熔断、并发限制和负载保护,系统才能让局部故障保持局部。重试的价值在于提高一次请求成功的机会,而不是保证每个失败请求都被不断重新发送。