
架构与系统设计 / 系统课时
用分布式追踪还原关键路径
用分布式追踪还原关键路径
当一次请求跨过网关、业务服务和多个下游时,单个服务的监控很难解释端到端为什么变慢。本节用 Trace 与 Span 时间线还原因果关系,区分串行耗时、并行扇出与重试成本,并把真正决定响应时间的关键路径找出来。
学习目标
- 能从 Trace、Span、父子关系和时间区间还原一次跨服务请求。
- 能区分串行耗时、并行扇出与重试对端到端延迟的不同贡献。
- 能把追踪证据转成可验证的性能排查结论。
先把 Trace 看成一条时间轴
一个 Trace 对应一次端到端请求,Span 则描述其中一个操作。分析时至少关注 Span 的开始时间、结束时间、父 Span、服务名、操作名、状态以及重试相关属性。父子关系告诉你“谁调用了谁”,时间区间告诉你“哪些操作真的阻塞了最终完成”。
关键路径不是“耗时最长的单个 Span”,也不是把所有 Span 时长相加。并行调用会重叠,只有最晚完成且阻塞后续步骤的分支会进入关键路径;重试则可能把多个失败与成功尝试串成额外的等待。
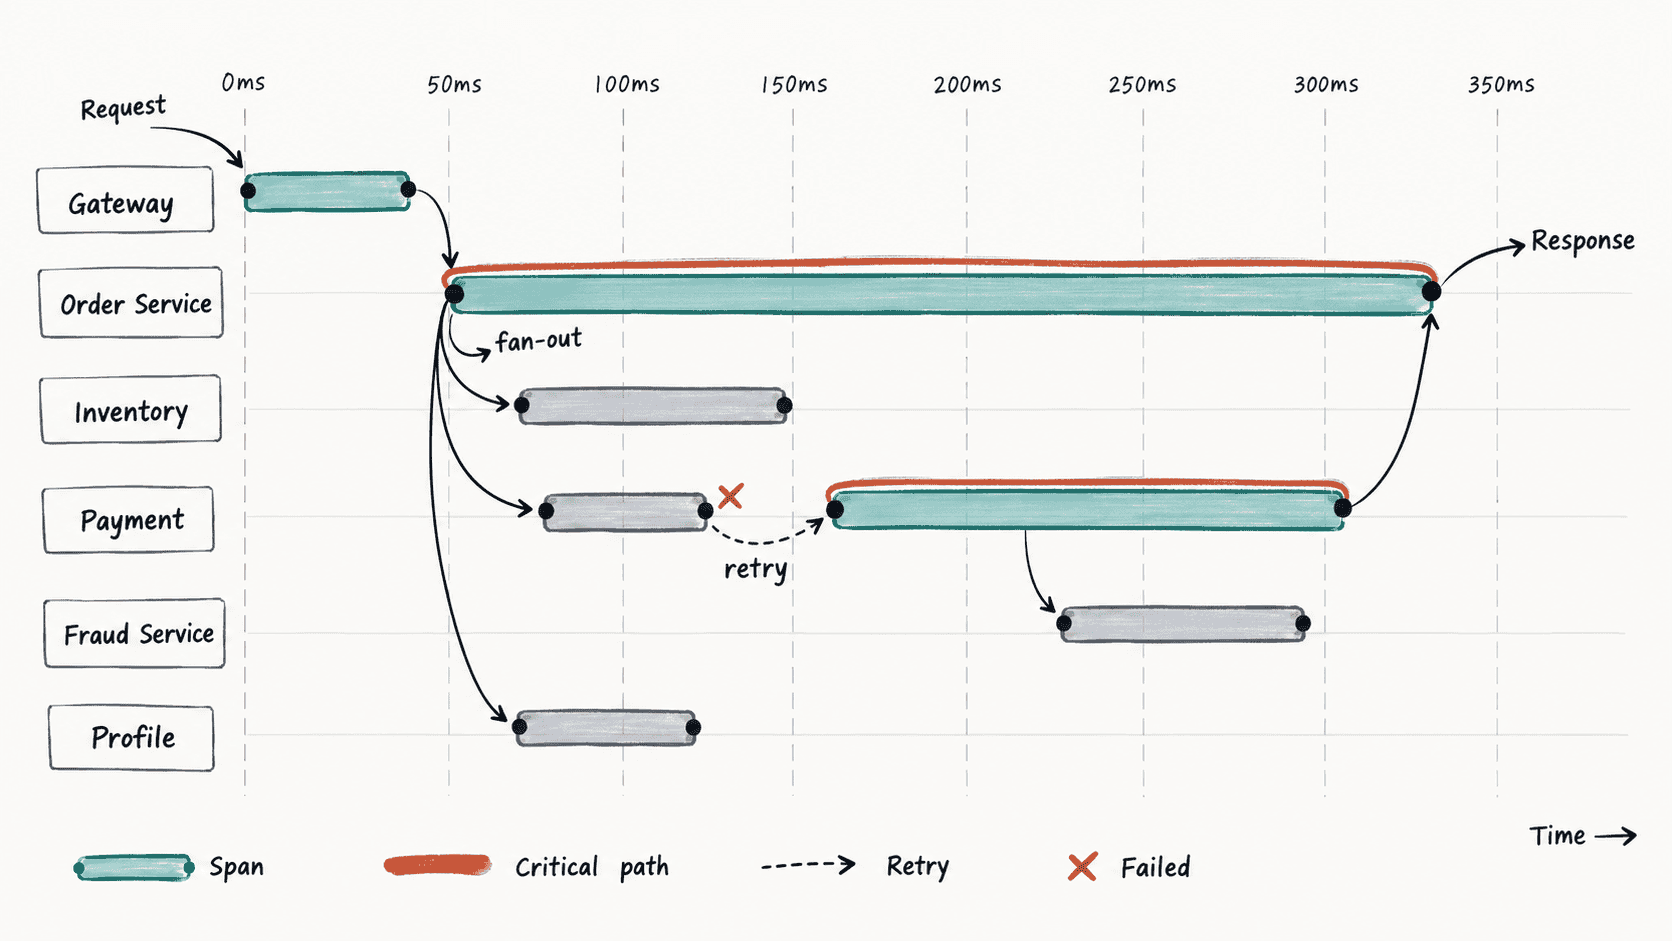
从并行和重试中找关键路径
定位时先从根 Span 的总时长开始,再按时间顺序检查直接或间接子 Span。对串行阶段,耗时可以沿因果链累积;对并行扇出,不能把多个分支相加,而应关注阻塞汇合点的最晚完成分支。
重试需要单独识别。同一逻辑操作如果出现第一次失败、随后再次发起,前一次失败消耗的时间通常直接增加在用户等待上。若第二次尝试又包含更深的下游调用,应继续向下追踪,直到找到真正占据该时间段的叶子 Span 或本地计算。
用脚本拆解 Span 时间
下面的最小脚本模拟一条 Trace,并计算每个 Span 的总时长与“扣除直接子 Span 覆盖后的本地时间”。这个指标不能自动替代关键路径分析,但能快速暴露失败重试、本地处理和深层下游耗时分别落在哪里。
# 同一 Trace 中的时间单位统一为毫秒。
spans = [
    {"name": "gateway", "parent": None, "start": 0, "end": 240, "status": "OK"},
    {"name": "order", "parent": "gateway", "start": 10, "end": 230, "status": "OK"},
    {"name": "inventory", "parent": "order", "start": 20, "end": 90, "status": "OK"},
    {"name": "payment#1", "parent": "order", "start": 20, "end": 120, "status": "ERROR"},
    {"name": "payment#2", "parent": "order", "start": 125, "end": 220, "status": "OK"},
    {"name": "fraud", "parent": "payment#2", "start": 130, "end": 205, "status": "OK"},
]

# 合并重叠的子 Span 区间,避免并行调用被重复扣减。
def merged_covered_time(intervals):
    if not intervals:
        return 0
    intervals = sorted(intervals)
    total = 0
    left, right = intervals[0]
    for start, end in intervals[1:]:
        if start <= right:
            right = max(right, end)
        else:
            total += right - left
            left, right = start, end
    return total + right - left

# 建立父子索引,再计算每个 Span 扣除直接子调用后的本地时间。
by_parent = {}
for span in spans:
    by_parent.setdefault(span["parent"], []).append(span)

rows = []
for span in spans:
    children = by_parent.get(span["name"], [])
    child_intervals = [
        (max(span["start"], child["start"]), min(span["end"], child["end"]))
        for child in children
        if child["start"] < span["end"] and child["end"] > span["start"]
    ]
    duration = span["end"] - span["start"]
    self_time = duration - merged_covered_time(child_intervals)
    rows.append((self_time, duration, span["status"], span["name"]))

for self_time, duration, status, name in sorted(rows, reverse=True):
    print(f"{name:10s} duration={duration:3d}ms self={self_time:3d}ms status={status}")
预期输出
payment#1  duration=100ms self=100ms status=ERROR
fraud      duration= 75ms self= 75ms status=OK
inventory  duration= 70ms self= 70ms status=OK
order      duration=220ms self= 25ms status=OK
gateway    duration=240ms self= 20ms status=OK
payment#2  duration= 95ms self= 20ms status=OK
结果显示 payment#1 自身就消耗了 100 ms 且最终失败;inventory 虽然也有 70 ms,但它与第一次支付调用重叠,不能再把这 70 ms 直接加到总延迟上。第二次支付调用的 95 ms 中有 75 ms 落在 fraud 下游,因此真正需要继续调查的是“失败重试为什么发生”以及 fraud 为什么占据大部分重试时间。
把追踪证据变成可验证结论
一次有效排查应形成“现象、证据、假设、验证”闭环。例如:根 Span 为 240 ms;支付第一次尝试占 100 ms 后失败;第二次尝试延续到 220 ms;库存分支在 90 ms 已结束,因此库存不是尾延迟主因。接下来应分别验证支付失败原因和 Fraud Service 的服务时间,而不是平均地优化所有下游。
还要注意采样、缺失上下文和时钟偏差。缺失 Span 会让链路看起来突然中断,低采样率也只能说明“采到的慢请求发生了什么”,不能证明未采样请求没有问题。只有当关键路径上的慢 Span、错误或重试能被日志、指标或复现实验再次验证时,追踪结论才足以进入生产架构评审。