
架构与系统设计 / 系统课时
处理缓存击穿穿透与雪崩
处理缓存击穿穿透与雪崩
缓存故障看起来都像“命中率下降、数据库变忙”,但根因并不相同:热点键瞬间失效是击穿,请求不存在的数据是穿透,大量键同时过期或缓存整体不可用则会形成雪崩。本课用三种故障模型对应三类保护手段,并组合出可落地的缓存读取路径。
学习目标
- 根据请求模式区分缓存击穿、穿透与雪崩
- 使用请求合并、负缓存和 TTL 抖动降低回源压力
- 设计双检、回源和降级顺序,避免保护机制本身制造新热点
先按失败形态选择手段
缓存击穿通常只围绕一个或少数热点键发生。键在高并发时刻失效后,大量请求同时穿过缓存访问数据库。核心手段是请求合并:同一个键只允许一个请求回源,其他请求等待该结果或快速降级。
缓存穿透来自“缓存里没有、数据源里也没有”的键,例如不存在的商品 ID。若每次都直接回源,缓存永远无法吸收这些请求。常用做法是对不存在结果写入短 TTL 的负缓存,并配合参数校验、布隆过滤器或风控策略。
缓存雪崩关注的是大面积同时失效。若几万个键都使用完全相同的 TTL,它们可能在同一秒过期,把请求波峰整体转移给数据库。最基础的缓解是给 TTL 增加随机抖动,并限制回源并发;缓存集群不可用时还要准备降级路径。
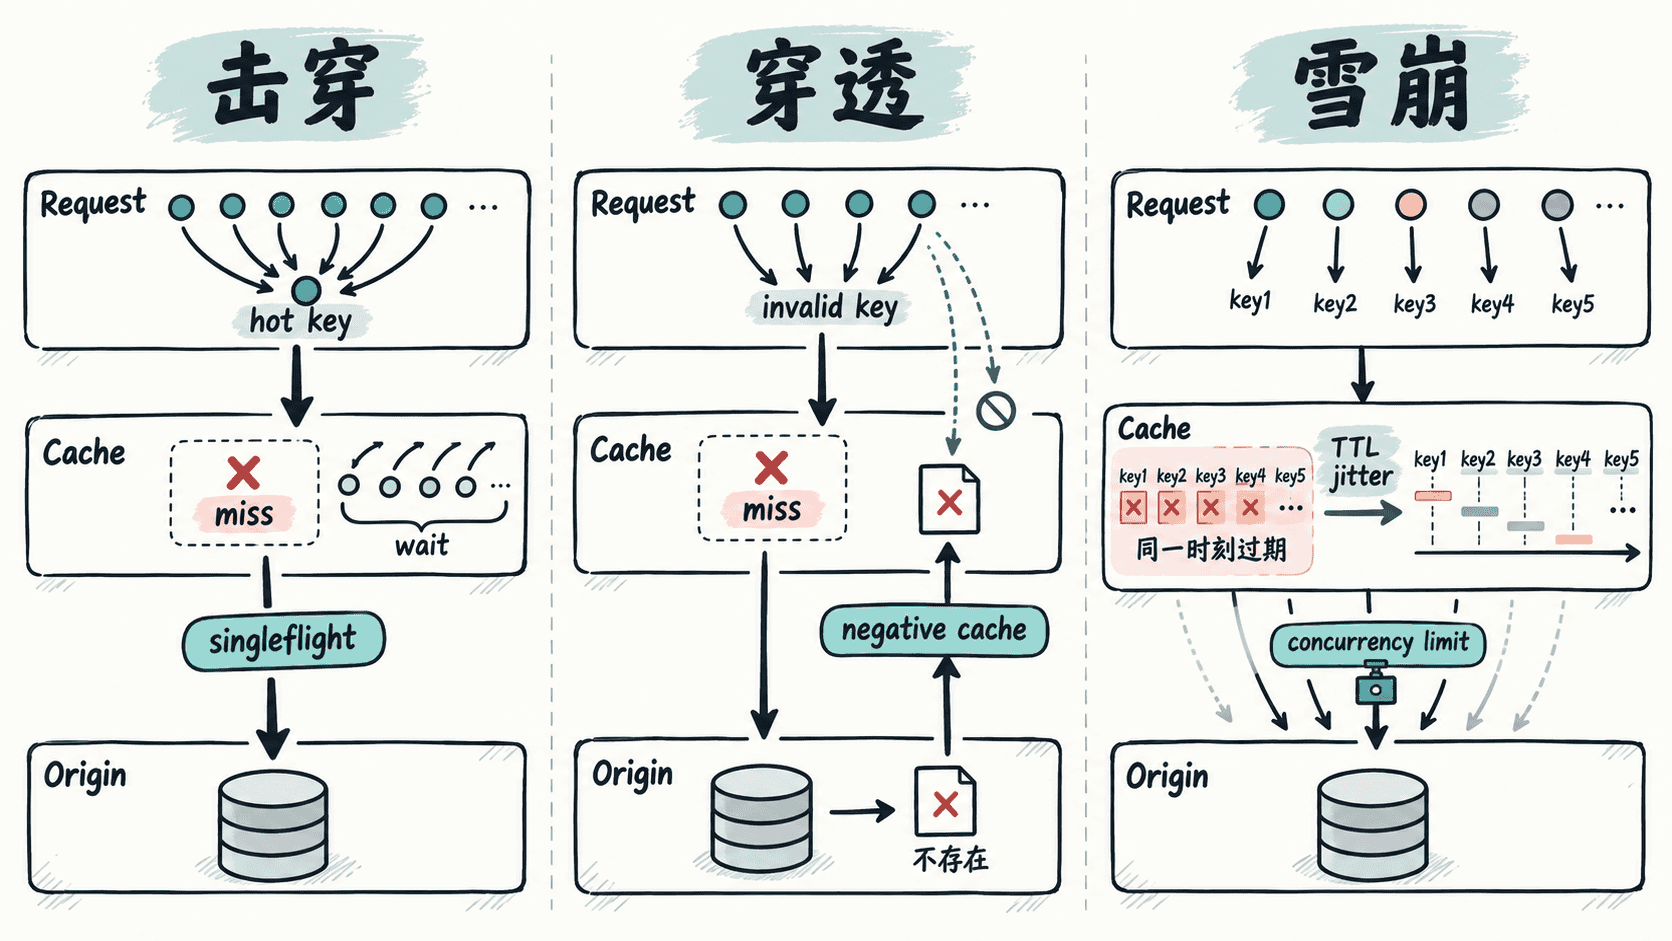
把三种保护放进同一条读取路径
实际读取路径可以按“查缓存 → 同键合并 → 二次查缓存 → 回源 → 写缓存”的顺序组织。二次查缓存很重要:等待锁期间,前一个请求可能已经把数据填回,如果不复查,就会继续产生重复回源。
下面的可运行示例实现了同键请求合并、负缓存和 TTL 抖动。8 个线程同时读取热点键时只触发一次数据源加载;不存在的键连续读取 3 次,也只回源一次。
import random
import threading
import time
from concurrent.futures import ThreadPoolExecutor
from dataclasses import dataclass

@dataclass
class Entry:
    value: object
    expires_at: float
    negative: bool

class Cache:
    def __init__(self):
        self._data = {}
        self._data_lock = threading.Lock()
        self._locks = {}
        self._locks_guard = threading.Lock()

    def get(self, key):
        with self._data_lock:
            entry = self._data.get(key)
            if entry is None or entry.expires_at <= time.monotonic():
                return False, None
            return True, None if entry.negative else entry.value

    def set(self, key, value, ttl, negative=False, jitter=0.2):
        # TTL 抖动把不同键的过期时刻分散开,降低雪崩概率。
        actual_ttl = ttl * (1 + random.uniform(-jitter, jitter))
        entry = Entry(value, time.monotonic() + actual_ttl, negative)
        with self._data_lock:
            self._data[key] = entry

    def lock_for(self, key):
        with self._locks_guard:
            return self._locks.setdefault(key, threading.Lock())

backend = {'hot': 'value:hot'}
origin_loads = {}
cache = Cache()
random.seed(7)

def load_from_origin(key):
    origin_loads[key] = origin_loads.get(key, 0) + 1
    time.sleep(0.05)
    return backend.get(key)

def get_or_load(key):
    hit, value = cache.get(key)
    if hit:
        return value

    # 同一个 key 只允许一个请求进入回源区,等待者醒来后再次查缓存。
    with cache.lock_for(key):
        hit, value = cache.get(key)
        if hit:
            return value

        value = load_from_origin(key)
        if value is None:
            cache.set(key, None, ttl=2, negative=True)
        else:
            cache.set(key, value, ttl=30)
        return value

with ThreadPoolExecutor(max_workers=8) as pool:
    hot_results = list(pool.map(lambda _: get_or_load('hot'), range(8)))

missing_results = [get_or_load('missing') for _ in range(3)]

print('hot values:', sorted(set(hot_results)))
print('origin loads for hot:', origin_loads['hot'])
print('missing reads:', missing_results)
print('origin loads for missing:', origin_loads['missing'])
预期输出
hot values: ['value:hot']
origin loads for hot: 1
missing reads: [None, None, None]
origin loads for missing: 1
代码中的 30 秒和 2 秒只是演示值。生产环境里,热点正常值通常可以使用较长 TTL,而负缓存应更短,避免刚创建的数据长期被“空结果”遮住;实际值要结合数据更新频率和可接受陈旧时间确定。
防止修复手段制造新的故障
请求合并的锁粒度必须是“按键”,不能用一个全局锁包住所有缓存 miss,否则一个慢热点会阻塞所有键。回源操作也需要超时和并发上限,否则缓存故障时仍可能把数据库连接池耗尽。
TTL 抖动适合解决“同批写入、同批过期”,但无法应对缓存节点整体故障。对这种雪崩要同时准备连接失败快速熔断、热点数据本地副本、只读降级或静态兜底,具体策略取决于数据是否允许短时间陈旧。
用指标判断是哪一类问题
击穿常表现为少数键的回源并发突然升高;穿透表现为大量重复 miss 且数据源持续返回不存在;雪崩则是大量不同键在相近时间 miss,并伴随缓存命中率整体下跌。
上线后至少按键或键前缀观测命中率、回源 QPS、回源并发、负缓存命中数与加载耗时。只有先确认冲击是集中在单个热点、无效键,还是大面积同时失效,才能把保护放在真正的故障入口,而不是一味增加缓存容量。