
架构与系统设计 / 系统课时
设计超时重试退避与抖动
设计超时重试退避与抖动
本节解决调用失败后“要不要再试、何时再试、还能试多久”的问题。我们把重试建立在幂等性、错误类型和剩余截止时间之上,再用指数退避与抖动打散并发重试,避免故障时把下游压得更重。
学习目标
- 用端到端截止时间约束单次超时和总重试时间。
- 根据幂等性、错误类型与剩余预算决定是否继续重试。
- 使用指数退避和抖动降低大量客户端同步重试造成的冲击。
先把超时放进总时间预算
超时不是“每次请求最多等多久”这么简单。调用方真正拥有的是一段端到端预算,DNS、建连、请求处理、重试等待都在消耗它。若总截止时间只有 800 ms,就不能机械地执行三次 500 ms 的调用。
每次尝试前都应重新计算剩余时间,并把单次超时设置为不超过剩余预算。预算已经不足以完成一次有意义的调用时,应直接失败,把时间留给上游降级、返回错误或执行补偿,而不是启动注定超时的新尝试。
只重试有机会成功的失败
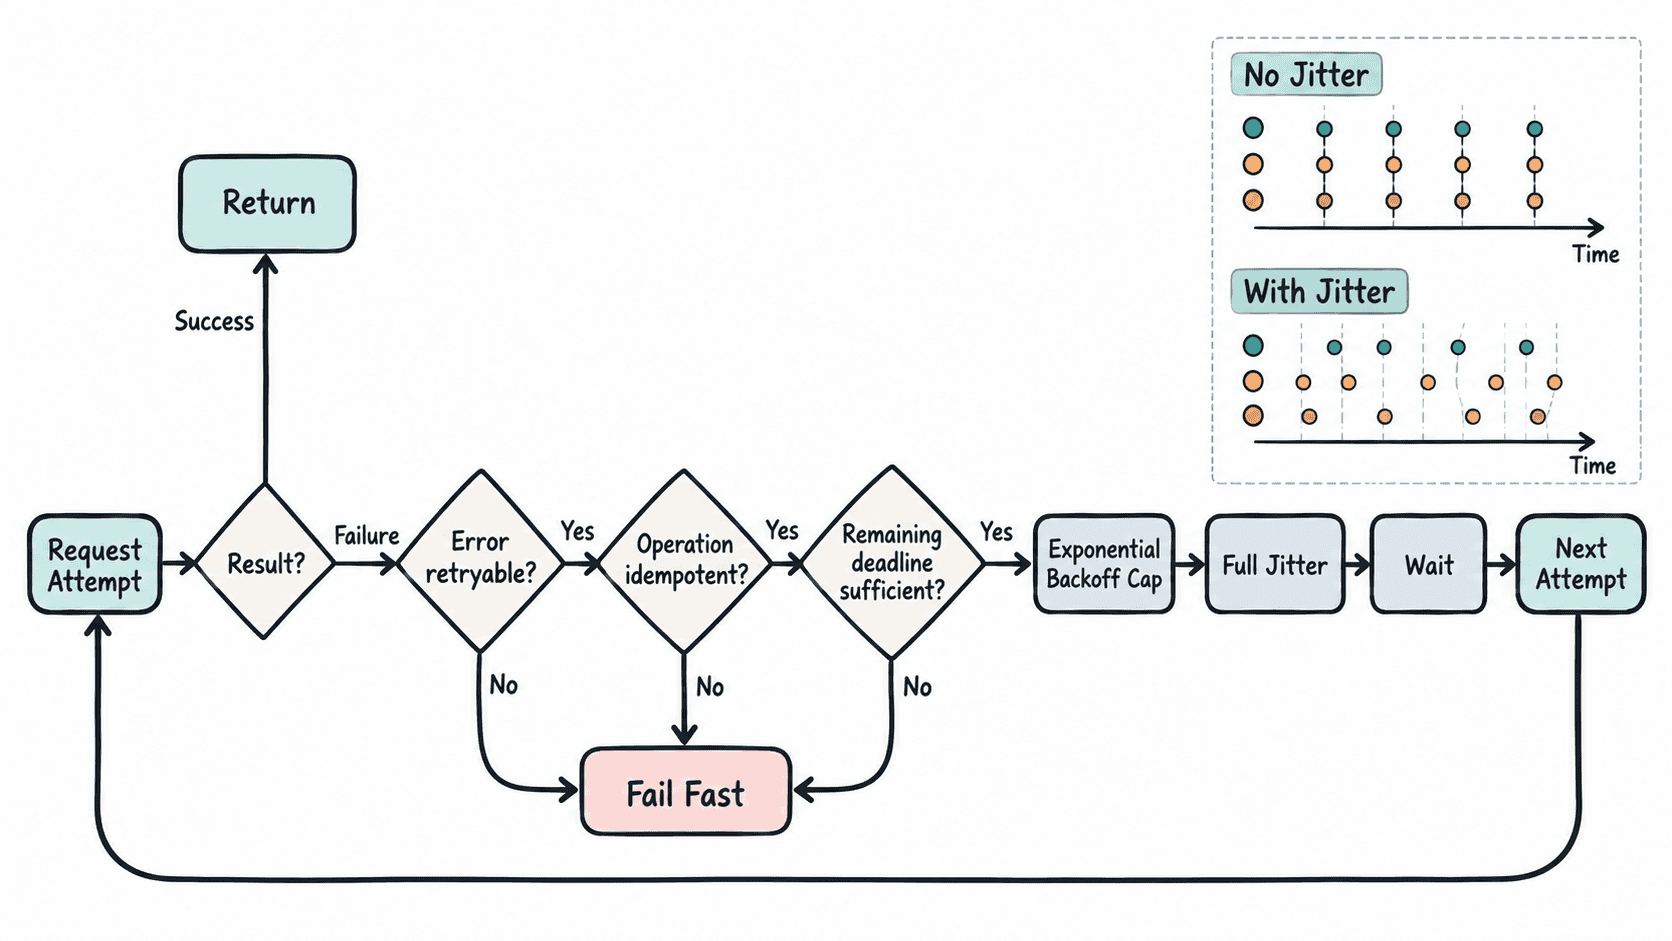
是否重试至少同时检查三个条件:操作是否幂等或已有幂等保护、错误是否具有瞬时特征、剩余截止时间是否足够。网络超时、连接重置、限流和部分 5xx 往往可以有限重试;参数错误、认证失败、明确的业务拒绝通常应立即返回。
用退避和抖动打散重试
指数退避让第 n 次等待上限按 base * 2^n 增长,并使用 cap 限制最大值。但如果成千上万个客户端在同一时刻失败,又按相同序列重试,它们仍会同步撞向下游。抖动就是在等待区间内引入随机性,把尖峰摊开。
常见的 Full Jitter 做法是先计算 ceiling = min(cap, base * 2^n),再从 0 到 ceiling 随机选择实际等待时间。它不会保证每个请求越来越慢,但会显著减少群体同步。
用截止时间驱动重试循环
下面的 Python 示例不发真实网络请求,而是用固定结果模拟一次超时、一次 503 和一次成功。代码在每次失败后重新计算预算,用固定随机种子生成可复现的 Full Jitter,并在等待时间会耗尽预算时停止重试。
import random

DEADLINE_MS = 1000
BASE_MS = 100
CAP_MS = 400
MAX_ATTEMPTS = 4
RESPONSES = [
    ("timeout", 180),
    ("503", 160),
    ("ok", 120),
]

def should_retry(result: str) -> bool:
    return result in {"timeout", "503"}

rng = random.Random(7)
elapsed_ms = 0

for attempt, (result, cost_ms) in enumerate(RESPONSES, start=1):
    elapsed_ms += cost_ms
    remaining_ms = DEADLINE_MS - elapsed_ms
    print(f"attempt {attempt}: {result}, remaining={remaining_ms}ms")

    if result == "ok":
        print("success")
        break

    if attempt >= MAX_ATTEMPTS or not should_retry(result):
        print("stop")
        break

    ceiling_ms = min(CAP_MS, BASE_MS * 2 ** (attempt - 1))
    sleep_ms = rng.randint(0, ceiling_ms)

    if sleep_ms >= remaining_ms:
        print("stop: no budget")
        break

    print(f"retry after {sleep_ms}ms")
    elapsed_ms += sleep_ms
预期输出
attempt 1: timeout, remaining=820ms
retry after 41ms
attempt 2: 503, remaining=619ms
retry after 38ms
attempt 3: ok, remaining=461ms
success
这里的 RESPONSES 只是可复现的故障脚本;接入真实 HTTP 或 RPC 客户端时,应把真实调用耗时计入 elapsed_ms,并把剩余预算传递给下游作为 deadline 或 timeout。
给重试设置明确停止条件
重试策略应同时有最大次数、最大总时长和退避上限,任何一个边界触发都停止。对限流响应还应优先尊重服务端提供的重试提示;若系统已经过载,客户端重试次数越多,放大效应越明显。
生产验收时要关注“总调用量 ÷ 原始请求量”的重试放大倍数、各错误类型的重试成功率和截止时间耗尽比例。好的策略不是让每个请求都多试几次,而是在仍有成功概率时少量重试,并在没有预算或没有恢复可能时尽快结束。