
架构与系统设计 / 系统课时
处理复制延迟与读己之写
处理复制延迟与读己之写
异步复制能够降低写入等待时间,却可能让刚写成功的用户从副本读到旧值。本篇用版本号和时间线解释陈旧读取,并比较主库读取、会话粘滞与版本等待三种读己之写方案。
学习目标
- 解释异步复制为什么会产生写成功后仍读到旧值的现象
- 根据业务读写路径选择主库读取、会话保证或版本等待
- 用版本号验证一次读取是否已经覆盖当前会话的最新写入
写成功不代表所有副本已经更新
在异步复制中,主节点通常先提交本地写入并向客户端返回成功,再把变更发送给副本。假设用户把昵称从 Alice 改成 Alicia,主节点已经提交版本 v42,但某个副本仍停留在 v41。
如果紧接着的查询被负载均衡到这个副本,用户会看到旧昵称。数据库并没有撤销刚才的写入,只是读取路径选择了尚未追上最新版本的副本。这就是复制延迟造成的陈旧读取。
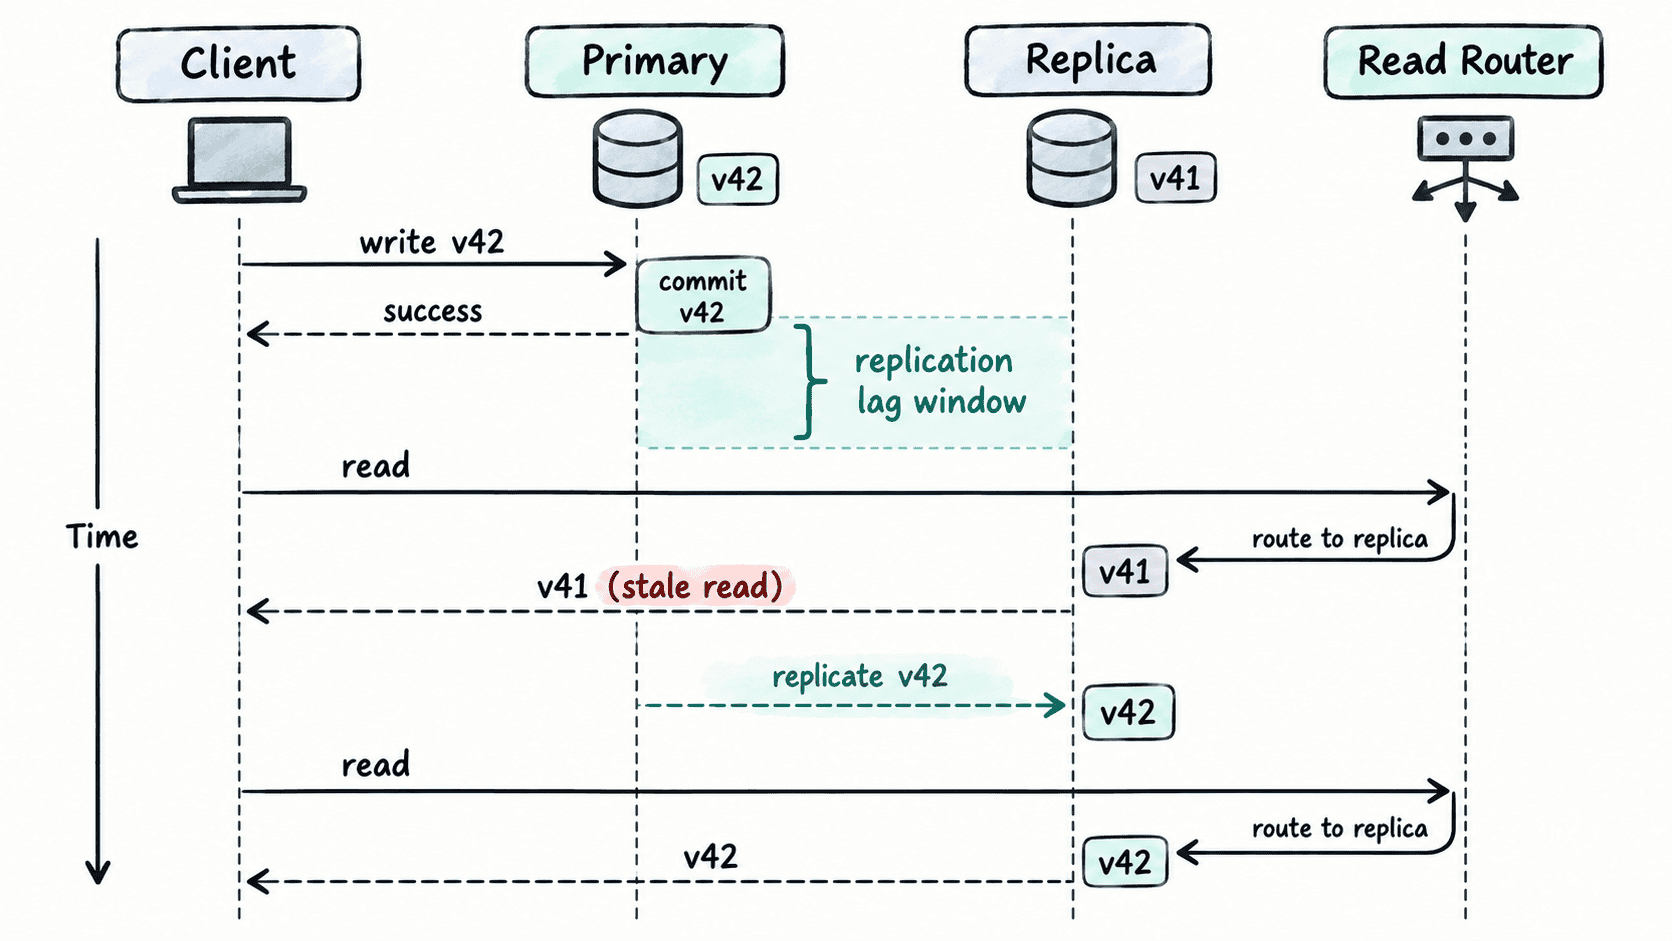
读己之写保证解决的不是“所有用户立刻读到最新值”,而是更具体的会话语义:一个客户端完成写入后,它后续的读取至少不能比自己的最新写入更旧。
三种常见保证方式
最直接的方法是让写入后的相关读取暂时访问主节点。实现简单,而且主节点已经包含刚提交的数据;代价是热点用户或高读流量可能把大量请求重新压回主节点,因此通常只对刚写过的数据或一段短时间窗口启用。
第二种方法是会话粘滞。系统让同一用户在一个会话内固定读取某个满足要求的节点,或者在发生写入后切换到主节点。它能减少跨副本跳转造成的版本倒退,但节点故障、会话迁移和多设备访问时仍要定义新的路由规则。
第三种方法是记录写入版本。写成功时服务端返回或保存版本 v42,后续读取副本前要求副本至少应用到 v42;如果尚未追上,可以短暂等待、换一个更快的副本,或者回退到主节点。这种方案比固定读主更灵活,但需要系统暴露可比较的复制进度。
用版本等待阻止陈旧读取
下面的可执行 Python 示例模拟主节点提交 v42 后,副本仍在 v41。普通读取立即返回旧值,而带最低版本要求的读取会等待复制推进后再返回。
import time
import threading

class Replica:
    def __init__(self) -> None:
        self.version = 41
        self.value = "Alice"

    def apply(self, version: int, value: str) -> None:
        self.version = version
        self.value = value

    def read_at_least(self, min_version: int, timeout: float) -> str:
        deadline = time.monotonic() + timeout
        while self.version < min_version:
            if time.monotonic() >= deadline:
                raise TimeoutError("replica did not reach required version")
            time.sleep(0.01)
        return self.value


def main() -> None:
    replica = Replica()
    committed_version = 42

    print("immediate read:", replica.value, "version", replica.version)

    def replicate() -> None:
        time.sleep(0.05)
        replica.apply(42, "Alicia")

    worker = threading.Thread(target=replicate)
    worker.start()
    value = replica.read_at_least(committed_version, timeout=1.0)
    worker.join()

    print("version-aware read:", value, "version", replica.version)


if __name__ == "__main__":
    main()
预期输出
immediate read: Alice version 41
version-aware read: Alicia version 42
示例中的等待时间只是为了稳定复现异步复制过程,生产系统不应通过固定 sleep 猜测复制何时完成。真正的版本等待需要依赖数据库日志位置、提交序号、版本向量或系统提供的其他可比较进度标记。
把保证限定在真正需要的读取上
读己之写最适合用户刚修改资料、提交配置、创建对象后立即查看详情等场景。此时返回旧值会让用户怀疑操作失败,即使几十毫秒后副本最终会追上,也已经破坏了交互语义。
对于公共信息流、推荐列表或允许短暂延迟的统计页面,则未必需要把所有读取都升级成强保证。强制读主或等待副本会增加主节点压力和尾延迟,应把一致性成本集中在真正依赖会话最新状态的查询上。
设计时要区分“副本最终会一致”和“当前这次读取必须看到什么”。复制延迟本身并不可怕,真正的问题是没有为关键读取定义最低可接受版本。只要写入产生可追踪的版本,并让路由或副本读取尊重这个下界,就能把读己之写从模糊期望变成可验证的系统契约。