
架构与系统设计 / 系统课时
设计故障注入与恢复验收
设计故障注入与恢复验收
生产架构不能只靠“支持高可用”这样的描述完成评审。本节把节点宕机、网络延迟、依赖超时和区域故障改写成可重复演练的场景,并用恢复时间、错误率和数据正确性等指标判断架构承诺是否真正成立。
学习目标
- 把高可用、自动切换和数据可靠性承诺转换成可量化的验收条件
- 为节点、网络、依赖和区域四类故障设计包含停止条件的注入场景
- 使用恢复窗口与业务正确性证据判断一次故障演练是否通过
把架构承诺改写成可验收指标
故障演练首先验证假设,而不是验证“系统会不会挂”。如果架构评审声称单节点故障不会中断服务,就必须明确从哪个时刻开始计时、允许多少失败请求、多久恢复,以及恢复后怎样证明数据没有损坏。
常用指标可以分成四组。检测时间衡量监控和故障发现速度;恢复时间衡量从故障注入到服务重新稳定的耗时,可直接与 RTO 对照;服务质量关注错误率、吞吐量和延迟;数据正确性检查丢失、重复、乱序以及主从或跨区域状态是否满足既定 RPO。
例如,一个订单服务可以给出演练阈值:60 秒内恢复可用,恢复后连续 3 个观测窗口错误率低于 1%,P95 延迟回到 300 ms 以下,并且已确认订单不存在丢失或重复。这里的数字只是示例,真实阈值必须来自本系统的 SLO、容量模型和业务容忍度。
为四类故障写场景
一个可执行的故障场景至少要写清故障范围、注入动作、预期架构响应、观测指标、停止条件和恢复动作。没有停止条件的混沌测试容易把验证高可用变成扩大事故。
| 故障类型 | 注入目标 | 预期架构响应 | 重点验收 |
|---|---|---|---|
| 节点宕机 | 停止一个实例、Pod 或虚拟机 | 健康检查摘除故障节点,流量转移到健康副本 | 检测时间、恢复时间、剩余容量、会话或任务迁移 |
| 网络延迟 | 对一条服务调用链增加延迟和抖动 | 超时预算生效,重试受控,系统不发生级联阻塞 | P95/P99、超时率、线程或连接池占用、重试放大 |
| 依赖超时 | 让数据库、缓存或下游接口持续超过调用截止时间 | 快速失败、熔断或降级路径接管 | 错误边界、降级正确性、恢复后熔断器关闭速度 |
| 区域故障 | 隔离主区域入口或停止区域级服务能力 | 流量切换到备用区域,数据和容量能够承接 | 跨区域 RTO、RPO、切流完整性、备用区域容量 |
网络延迟和依赖超时应分别演练。前者验证慢调用对资源池和尾延迟的影响,后者验证调用方的截止时间、熔断和降级策略;只测试“请求失败”无法暴露慢请求造成的资源耗尽问题。
区域故障的爆炸半径最大,通常不应该作为第一场演练。先证明单实例和单依赖故障的保护机制有效,再逐步扩大到可用区或区域级故障,才能在每一级都获得清晰的失败证据。
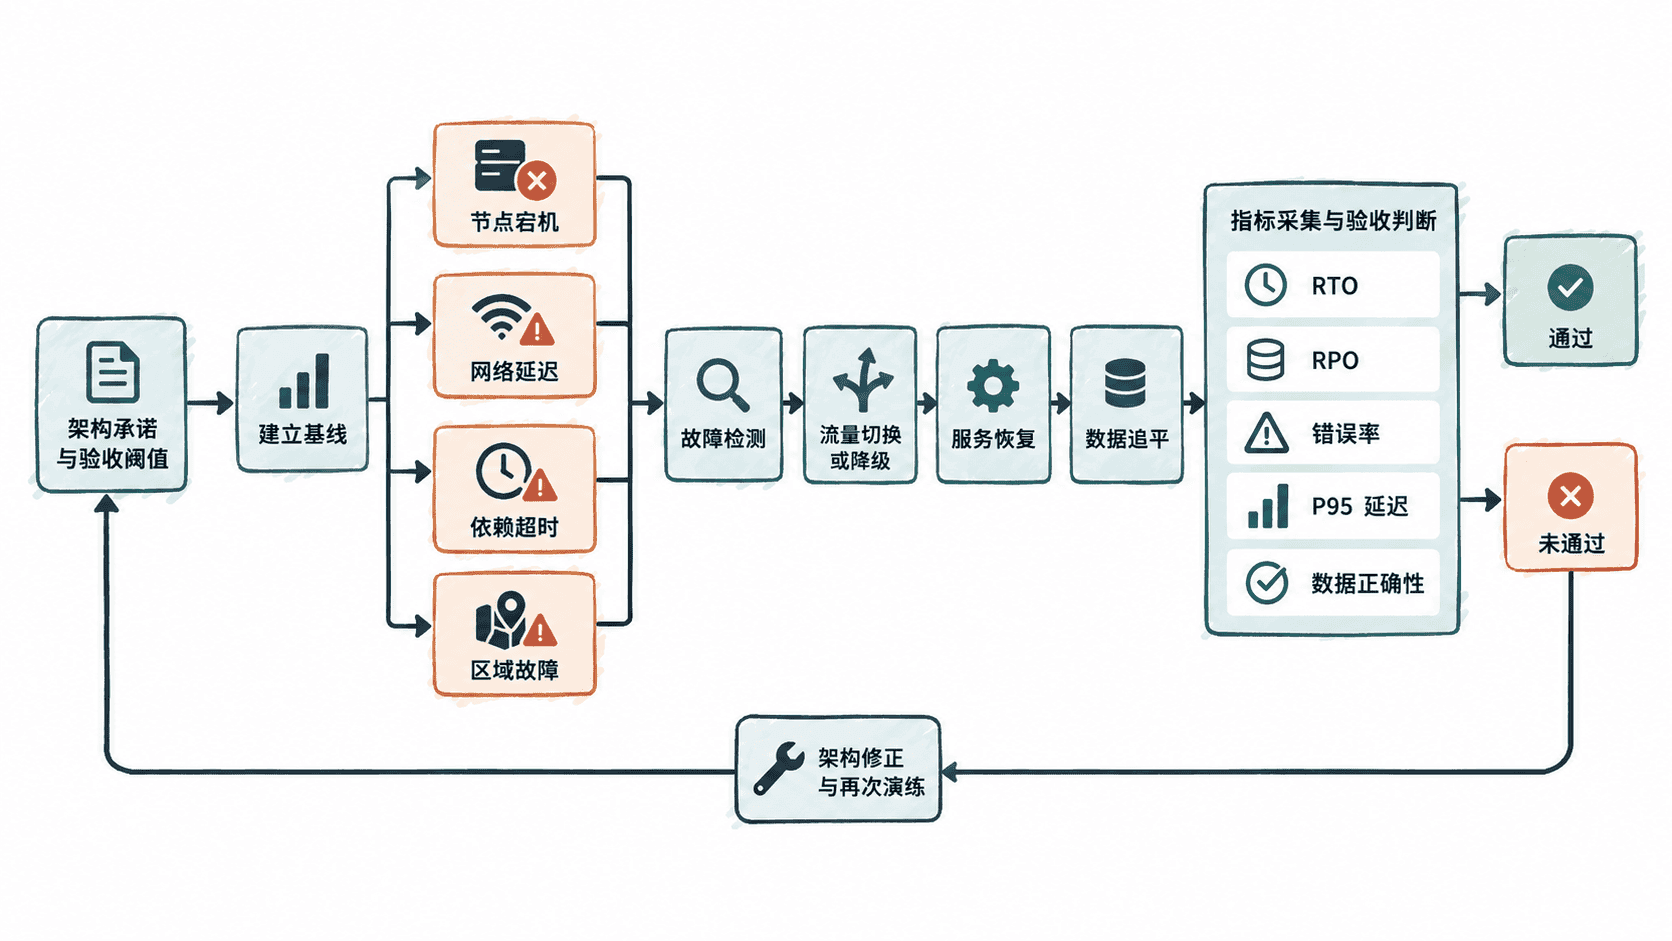
按闭环执行演练
正式注入前先记录基线,包括正常错误率、延迟、吞吐量、复制延迟和队列积压。没有基线时,即使故障结束后指标下降,也无法判断系统是否已经回到正常状态。
随后按固定顺序执行:确认观测面正常,记录开始时间,实施单一故障,观察检测与保护机制,达到预设持续时间后撤销故障,再持续观察直到服务质量和数据状态都恢复。一次演练只改变一个主要故障变量,避免节点异常和网络抖动同时出现后无法定位原因。
每个场景还应设置立即停止条件。例如错误率连续两个窗口超过业务允许上限、备用区域容量超过安全水位、出现不可逆数据损坏,或监控本身失效,都应终止注入并执行回滚。停止条件必须在演练前确定,不能等故障扩大后临时讨论。
用脚本测恢复窗口
下面的脚本持续访问一个健康检查地址。故障注入后启动它,当接口连续三次成功时记录恢复耗时;超过允许窗口仍未恢复则返回非零退出码。它适合充当恢复时间的一项自动化证据,但不能替代业务指标与数据一致性检查。
#!/usr/bin/env bash
set -euo pipefail

URL="${1:-http://127.0.0.1:8080/health}"
TIMEOUT_SECONDS="${TIMEOUT_SECONDS:-120}"
INTERVAL_SECONDS="${INTERVAL_SECONDS:-2}"
START="$(date +%s)"
SUCCESS_STREAK=0

while true; do
  NOW="$(date +%s)"
  ELAPSED=$((NOW - START))

  if curl -fsS --max-time 1 "$URL" >/dev/null; then
    SUCCESS_STREAK=$((SUCCESS_STREAK + 1))
    echo "t=${ELAPSED}s status=ok streak=${SUCCESS_STREAK}"

    if [ "$SUCCESS_STREAK" -ge 3 ]; then
      echo "recovered_in=${ELAPSED}s"
      exit 0
    fi
  else
    SUCCESS_STREAK=0
    echo "t=${ELAPSED}s status=failed streak=0"
  fi

  if [ "$ELAPSED" -ge "$TIMEOUT_SECONDS" ]; then
    echo "recovery_timeout>${TIMEOUT_SECONDS}s"
    exit 1
  fi

  sleep "$INTERVAL_SECONDS"
done
预期输出
t=0s status=failed streak=0
t=<TIME>s status=ok streak=1
t=<TIME>s status=ok streak=2
t=<TIME>s status=ok streak=3
recovered_in=<TIME>s
<TIME> 会随实际故障持续时间、探测周期和恢复速度变化。如果约定 RTO 为 60 秒,可以将 TIMEOUT_SECONDS=60 作为自动化门槛;脚本退出码为 1 时,本次恢复时间验收直接失败。
判定演练是否通过
一次演练通过不能只看“最后恢复了没有”。评审记录应同时回答:故障是否在预期范围内被检测,流量或任务是否按设计切换,保护机制有没有造成重试风暴或资源耗尽,恢复时间是否满足 RTO,以及故障期间和恢复后的数据是否满足 RPO 与业务不变量。
对于区域切换,还要特别检查备用区域是否只是“能启动”,还是确实能够承接真实峰值流量。切换成功但备用区域 CPU、连接数或队列立即进入危险水位,说明架构只完成了功能切换,没有完成容量意义上的容灾。
演练结束后应保留时间线、注入动作、关键指标截图或导出数据、数据核对结果和通过结论。只要任一核心承诺没有证据支持,就应把结论记录为未通过,并把暴露出的超时预算、容量、监控或数据恢复问题重新纳入架构评审。