
架构与系统设计 / 系统课时
用舱壁限制共享资源耗尽
用舱壁限制共享资源耗尽
一个慢依赖如果和关键业务共用线程池、连接池或并发额度,少量请求就可能把整台服务拖死。舱壁模式通过按依赖或优先级切分资源上限,把故障限制在局部,让健康路径仍有可用资源。
学习目标
- 识别线程、连接和并发额度中的共享资源风险
- 按依赖和业务优先级设计独立舱壁
- 用拒绝行为验证某个慢依赖不会拖垮关键路径
先找真正会被耗尽的资源
舱壁不是把代码分成几个模块,而是把有限资源的占用权分开。最常见的是线程池、数据库连接池、HTTP 连接池、队列容量和并发许可。如果两个调用链最终仍争抢同一个小线程池,那么即使代码上“分了服务”,故障仍会互相传播。
设计时先写清每条关键路径依赖什么资源、最大可接受并发是多少、资源耗尽时应该排队还是立即拒绝。对低优先级任务,快速拒绝通常比无限排队安全,因为长队列只是把故障从线程池搬到内存和延迟上。
资源隔离怎样阻断故障传播
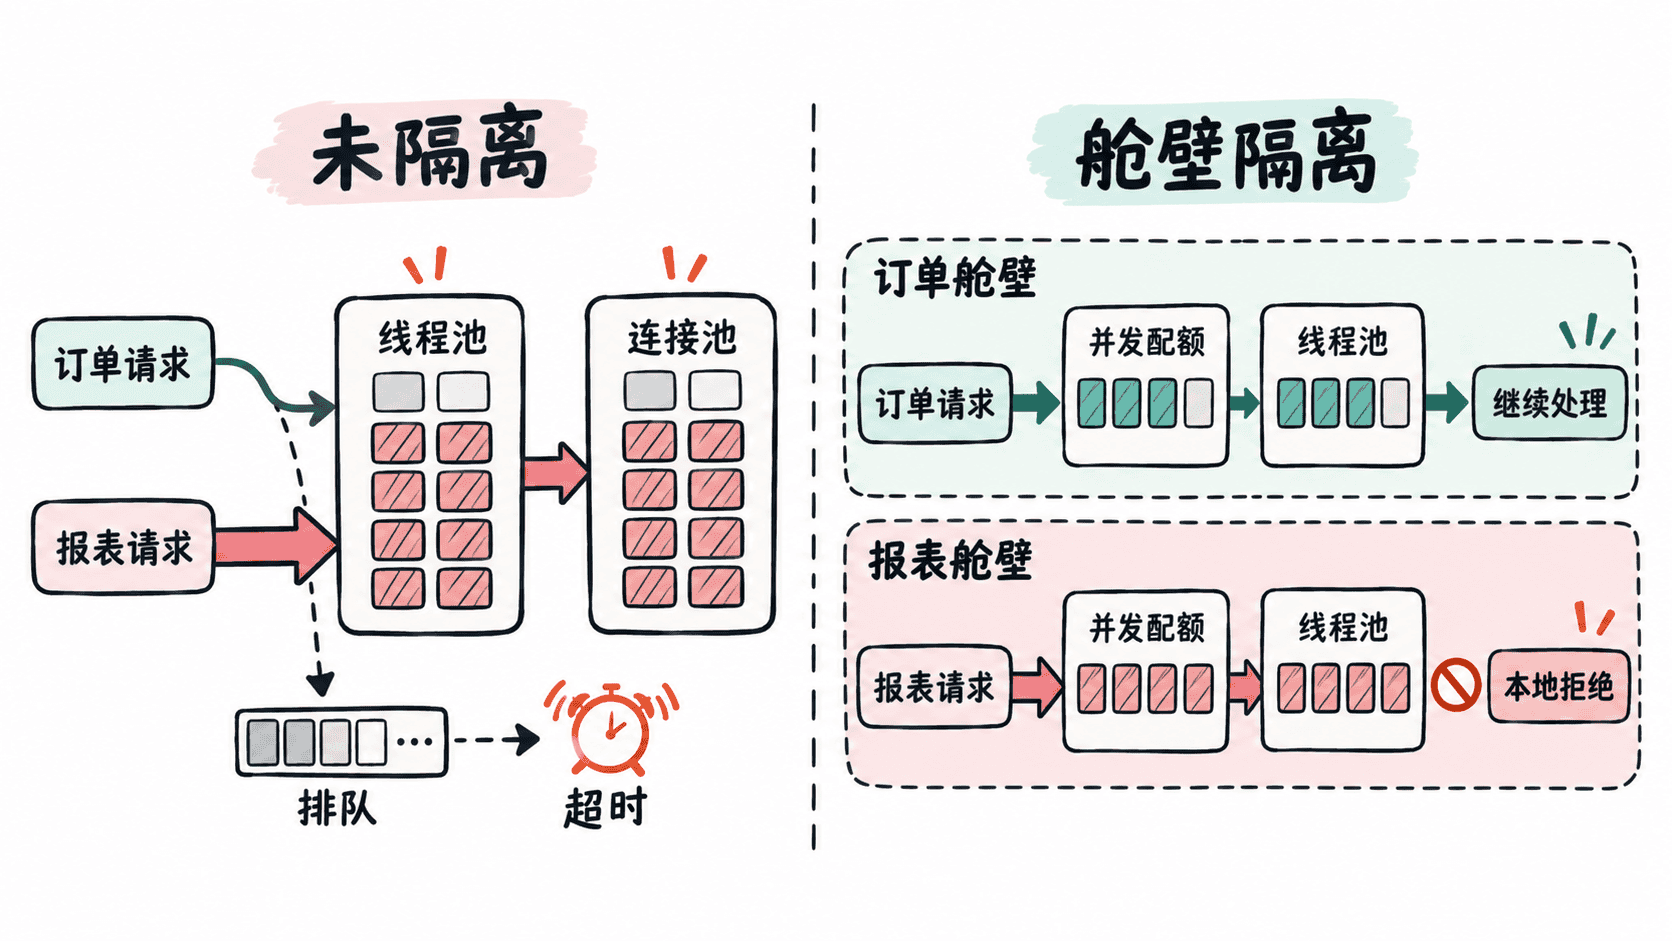
资源切分后,每个舱壁都有自己的容量和失败边界。报表依赖被慢请求占满时,只能消耗分给报表的那部分线程或连接;订单路径保留独立额度,不需要等待报表释放资源。
隔离粒度不能无限细。每个下游都建立独立线程池会增加线程数、连接数和调度成本。通常优先把高延迟、高故障风险依赖与核心业务隔开,再按优先级细分,而不是机械地“一接口一池”。
用两个线程池验证隔离
下面的可运行示例为关键任务和慢任务分配独立线程池。慢任务池被占满时,关键任务仍能立即执行;这里用确定性的阻塞事件模拟慢依赖。
from concurrent.futures import ThreadPoolExecutor
from threading import Event

release_slow = Event()

def slow_task(name: str) -> str:
    release_slow.wait()
    return f"{name}: done"

def critical_task() -> str:
    return "critical: done"

slow_pool = ThreadPoolExecutor(max_workers=1)
critical_pool = ThreadPoolExecutor(max_workers=1)

slow_future = slow_pool.submit(slow_task, "slow")
critical_future = critical_pool.submit(critical_task)

print(critical_future.result())
print("slow finished:", slow_future.done())

release_slow.set()
print(slow_future.result())

slow_pool.shutdown()
critical_pool.shutdown()
预期输出
critical: done
slow finished: False
slow: done
这个示例说明的不是“线程越多越好”,而是慢任务占住自己的工作线程时,关键任务仍有独立执行槽位。生产系统还应给每个舱壁增加有界队列或并发信号量,达到上限后立刻返回可识别的过载结果。
容量上限要基于预算而不是平均值
舱壁容量应从服务的总线程、总连接和下游承载能力倒推。假设实例最多安全维持 100 个并发外呼,核心订单至少要保留 50 个,那么报表、推荐和后台任务不能在同一个共享池里自由抢满剩余资源。
对连接池尤其要防止“线程隔离了,连接仍共享”的假隔离。若两个舱壁最终从同一个 20 连接池取连接,慢 SQL 仍可能耗尽所有连接。因此要么为关键依赖配置独立连接池,要么至少设置每类请求的并发许可,确保低优先级流量拿不到全部连接。
过载时要明确拒绝而不是偷偷排队
健康的舱壁一定有清晰的满载行为:立即拒绝、返回降级结果,或把可延迟任务转入受控队列。最危险的是无界排队,因为它会把瞬时过载变成长尾延迟,并进一步触发客户端重试。
验证舱壁时不要只看整体成功率,应分别观察每个舱壁的活跃线程、排队长度、拒绝次数和依赖延迟。当某一舱壁达到上限时,关键验收标准是其他舱壁的延迟和可用性仍保持稳定。