
架构与系统设计 / 系统课时
用SLO与错误预算定义可靠性
用SLO与错误预算定义可靠性
可靠性不能只写成“尽量不宕机”。可执行的做法是先选择真实反映用户体验的指标,再为它设定明确 SLO,并把允许偏离目标的空间换算成错误预算。这样产品发布、架构投入和故障治理就能围绕同一组可度量标准做决策。
学习目标
- 区分 SLI、SLO 与错误预算各自承担的职责
- 把可用性和延迟要求写成可计算、可监控的可靠性目标
- 根据错误预算消耗速度制定发布和可靠性治理策略
从用户体验选择SLI
SLI 是实际测量值,应该回答用户真正感受到的问题,而不是单纯描述机器是否存活。对于在线接口,常见 SLI 包括成功请求比例、请求延迟分位数和数据新鲜度。
例如订单查询服务可以定义“合法请求中返回正确成功响应的比例”为可用性 SLI,同时定义“成功请求中 99% 在 300 ms 内完成”为延迟 SLI。CPU 利用率和实例存活数仍然有运维价值,但通常不适合作为最终用户 SLO。
把目标写成可判定的SLO
SLO 是某个统计周期内希望 SLI 达到的目标。例如“30 天窗口内,99.9% 的合法请求成功”就是一个完整的可用性 SLO,其中包含指标、阈值和时间窗口。
假设一个服务在 30 天内收到 1,000,000 次符合统计条件的请求,可用性 SLO 为 99.9%,那么允许失败的比例是 0.1%,也就是 1,000 次请求。这部分允许消耗的空间就是错误预算。
如果按时间近似理解,30 天共有 43,200 分钟,99.9% 可用性意味着最多约 43 分 12 秒不可用。但请求量并不均匀,所以在线服务更适合直接按“好请求/总请求”计算,而不是机械地把故障时长当成唯一指标。
用错误预算连接发布与可靠性
错误预算的价值在于把“稳定一点”和“发布快一点”的争论变成可以量化的权衡。预算充足时,团队可以承担更多变更风险;预算快速消耗时,应减少高风险发布,并优先修复造成可靠性下降的系统问题。
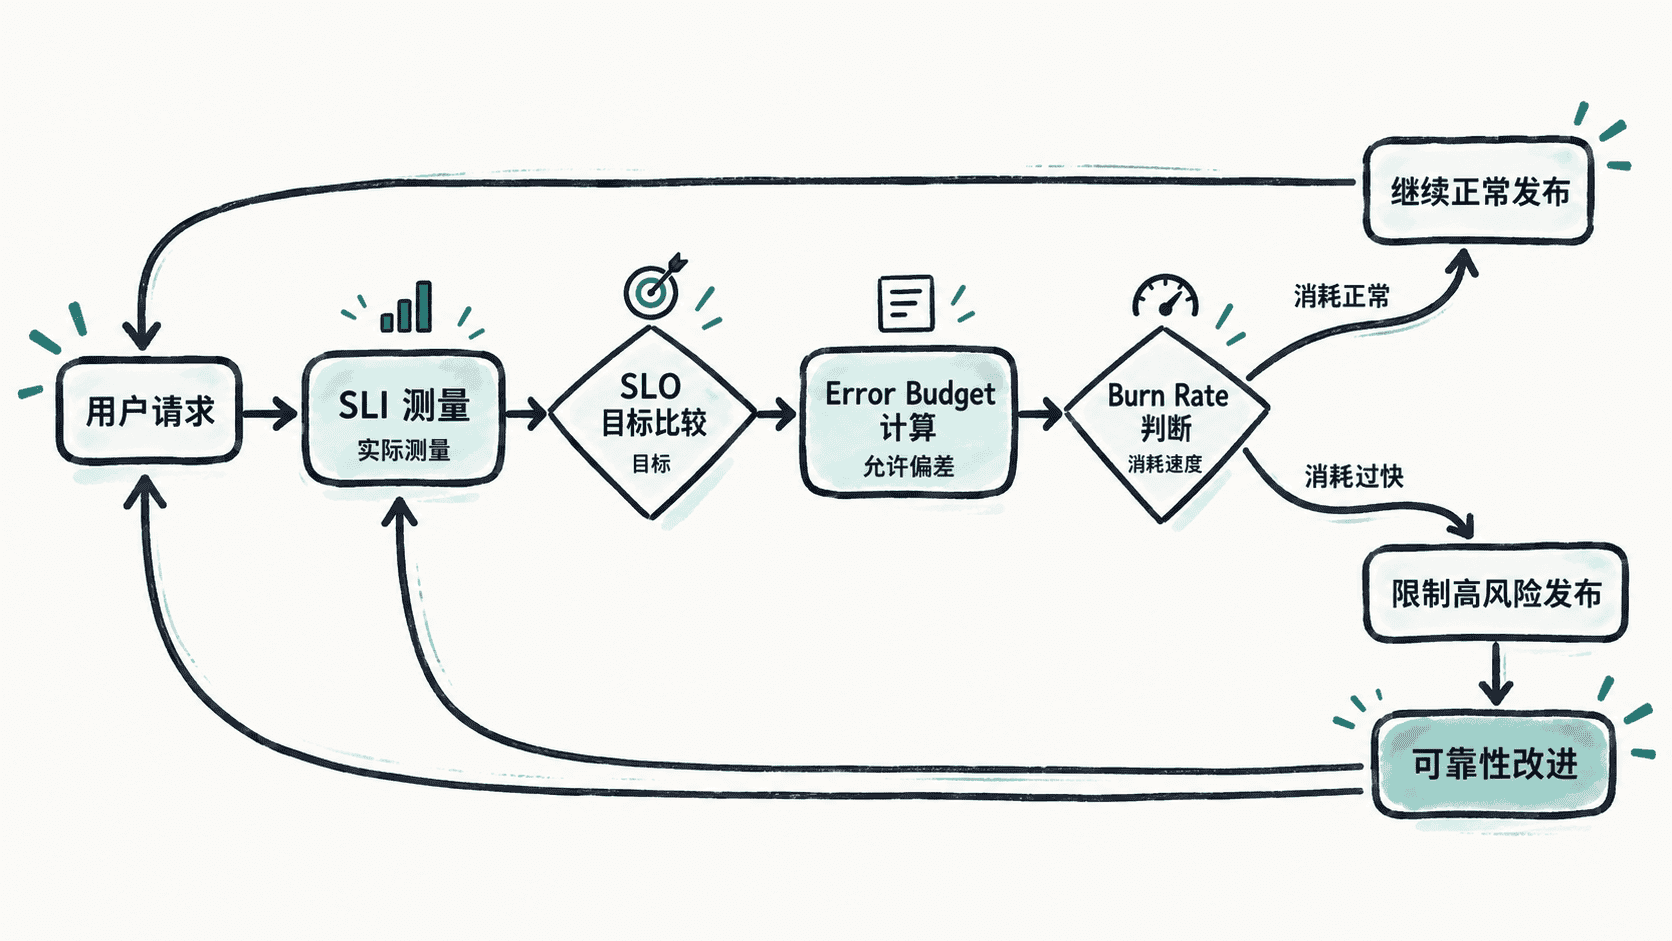
仅看“预算还剩多少”反应可能太慢,因此还要关注消耗速度,也就是常说的 burn rate。假设一个月的错误预算在一天内就消耗了很大比例,即使当前仍未正式违反月度 SLO,也说明继续维持相同故障速度会很快超标,应尽早响应。
团队可以把预算状态映射到发布策略:预算健康时保持正常发布;预算快速下降时减少非必要变更并提高发布审核等级;预算已经耗尽时,除紧急修复外暂停增加风险的变更,直到可靠性恢复。
避免把SLO设成没有决策价值的数字
SLO 不是越高越好。把所有服务都设成 99.999% 会显著增加冗余、工程复杂度和运维成本,而且某些内部工具即使短暂停止,也不会造成同等级的业务损失。目标应该根据用户影响、上下游承诺和实现成本确定。
另一个常见问题是统计口径不稳定。例如监控一会儿把客户端取消请求算失败,一会儿又排除;或者发布后修改指标定义却继续与旧数据比较。SLI 的分子、分母、排除条件和窗口算法都应固定并版本化,否则 SLO 数值无法形成长期决策依据。
SLO 也不应只存在于监控看板。只有当错误预算真正影响发布节奏、故障优先级和容量投入时,它才成为工程机制。最终目标不是追求零故障,而是在明确用户承诺的前提下,让团队知道何时可以承担变化,何时必须把可靠性放在速度之前。