
架构与系统设计 / 系统课时
控制消息积压与回放压力
控制消息积压与回放压力
消息积压不是单纯的“队列变长”,而是生产速率、消费能力和下游资源之间出现了持续差额。本篇用可量化的速率判断积压是否会自行恢复,并把实时消费、扩容、限速和历史回放放进同一资源预算,避免回放任务把线上流量拖垮。
学习目标
- 用生产速率、消费速率和滞后量判断积压是在收敛还是继续扩大。
- 根据瓶颈位置选择消费者扩容、生产限速或下游保护,而不是只增加线程。
- 为历史回放设置独立预算、并发和停止条件,保护实时流量的延迟目标。
先把积压量化成三个速率
排查积压先看三个量:当前滞后量 lag、生产速率 produce_rate、实际消费速率 consume_rate。如果消费速率长期小于生产速率,积压一定继续增长;只有消费速率高于生产速率时,系统才有“追赶余量”。
估算清空时间时,真正有用的是净追赶速率,即 consume_rate - produce_rate,而不是总消费速率。例如当前积压 600 万条,生产 10,000 条/秒,消费 12,000 条/秒,净追赶只有 2,000 条/秒,理论清空时间约 50 分钟。
还要同时观察字节速率和下游耗时。两批消息都可能是 10,000 条/秒,但单条从 1 KB 变成 100 KB 时,网络、反序列化和存储压力完全不同。只看条数会误判容量。
判断能否安全追赶
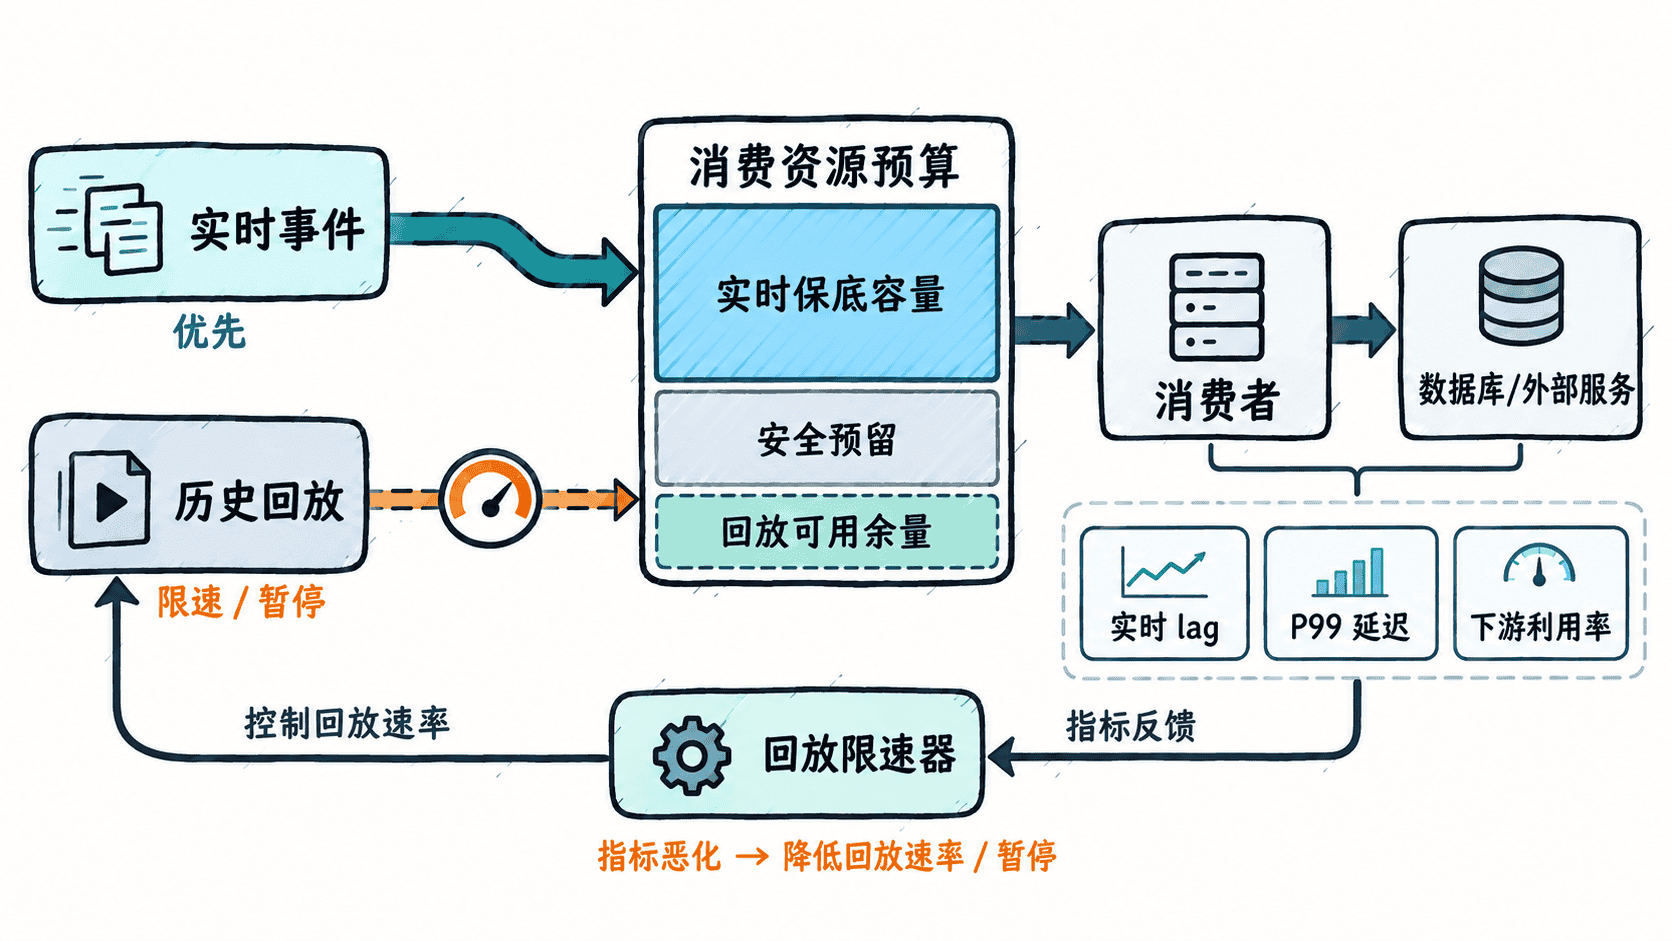
历史回放不能把所有空闲能力都吃掉,应预留故障和流量突增的余量。下面的可运行示例把总消费能力保留 20% 作为安全空间,再计算剩余能力能给历史回放多少速率。
production_rate = 12_000
consumer_capacity = 18_000
reserve_ratio = 0.20
replay_backlog = 24_000_000

safe_capacity = int(consumer_capacity * (1 - reserve_ratio))
replay_rate = max(0, safe_capacity - production_rate)

print(f"safe capacity: {safe_capacity} msg/s")
print(f"replay rate cap: {replay_rate} msg/s")

if replay_rate == 0:
    print("replay paused: no safe headroom")
else:
    minutes = replay_backlog / replay_rate / 60
    print(f"estimated replay time: {minutes:.1f} min")
预期输出
safe capacity: 14400 msg/s
replay rate cap: 2400 msg/s
estimated replay time: 166.7 min
这里的 2,400 条/秒不是“最快回放速度”,而是当前假设下的安全上限。若生产速率升到 14,400 条/秒附近,回放预算应自动降到零,而不是继续争抢线上资源。
把实时消费和历史回放隔离
回放最危险的地方是它会同时放大多个共享资源:Broker 读取带宽、消费者 CPU、反序列化、数据库写入、缓存回源和外部 API 配额。即使消息系统本身还有余量,下游数据库先被打满,实时消费仍会发生雪崩。
因此应把实时与回放至少做逻辑隔离:使用独立消费组或任务实例、独立并发上限、单独的速率限制器,并为下游连接池或写入吞吐设置硬配额。回放只能使用“实时业务用完之后剩下的预算”,不能反过来要求实时流量让路。
扩容与限速要对准瓶颈
消费者扩容有效的前提是还有可并行的分区或任务槽位,而且瓶颈确实在消费者计算。若 12 个消费者竞争 6 个可并行分区,继续加实例通常不会提升有效吞吐。若瓶颈在数据库写入或外部接口,再加消费者只会把压力更快地推向下游。
处理顺序应从瓶颈出发:先确认是 CPU、分区并行度、网络还是下游服务受限;能安全扩消费者就扩消费者;下游已接近饱和时先限并发、批量写入或削减非关键工作;生产侧支持背压时,再对低优先级流量限速或延迟接入。
用趋势而不是单点值验收
恢复过程至少要同时看四类指标:lag 的斜率是否转负、实时消息端到端延迟是否稳定、消费者错误率是否上升、下游资源是否仍有安全余量。单看“消费者吞吐变大”不足以证明问题解决,因为吞吐增加也可能来自重试风暴或回放抢占。
开始回放后,如果实时 lag 重新上升,或下游延迟明显恶化,就说明回放速率超过了真实余量,应立即降低并发或暂停。只有在实时指标保持稳定、积压持续下降且资源水位可控时,扩容或回放策略才算生效。
积压治理的核心不是把历史消息尽快清空,而是让系统始终保持可恢复性:先证明实时消费有余量,再把余量显式分配给回放,并用实时指标形成反馈控制。这样即使面对突发流量或大规模重放,也不会用一次“追赶”制造下一次事故。