
架构与系统设计 / 系统课时
判断任务队列与事件日志边界
判断任务队列与事件日志边界
本篇解决一个常见架构选择:一条消息到底是“交给某个工作者完成一次”的任务,还是“记录已发生事实并允许多个订阅者重放”的事件。你会用消费语义、保留方式和重放需求快速判断两者边界。
学习目标
- 区分竞争消费队列与可重放事件日志的核心语义。
- 根据工作分发、审计、多订阅者和重放需求选择模型。
- 识别“队列执行任务、日志记录事实”的组合使用场景。
先看谁应该收到同一条消息
任务队列关心的是把工作分给某个执行者。同一消费组中的多个工作者竞争任务,通常一条任务成功后只需要一个工作者完成它。事件日志关心的是保存发生过的事实,不同消费组维护各自进度,因此账务、搜索、推荐等订阅者可以独立读取同一条事件。
下面的可执行 Python 程序用最小模型演示这两个语义。前半段让两个 worker 竞争四个任务;后半段让两个独立 consumer group 都从自己的 offset 读取同一份事件。
from collections import deque

jobs = deque(["job-1", "job-2", "job-3", "job-4"])
workers = ["worker-a", "worker-b", "worker-a", "worker-b"]

for worker in workers:
    print(f"{worker} <- {jobs.popleft()}")

events = ["order.created", "order.paid"]
groups = ["billing", "analytics"]

for group in groups:
    for offset, event in enumerate(events):
        print(f"{group}@{offset} <- {event}")
预期输出
worker-a <- job-1
worker-b <- job-2
worker-a <- job-3
worker-b <- job-4
billing@0 <- order.created
billing@1 <- order.paid
analytics@0 <- order.created
analytics@1 <- order.paid
这段输出体现了边界:队列中的任务被工作者分摊;日志中的事件没有因为 billing 读过就对 analytics 消失。
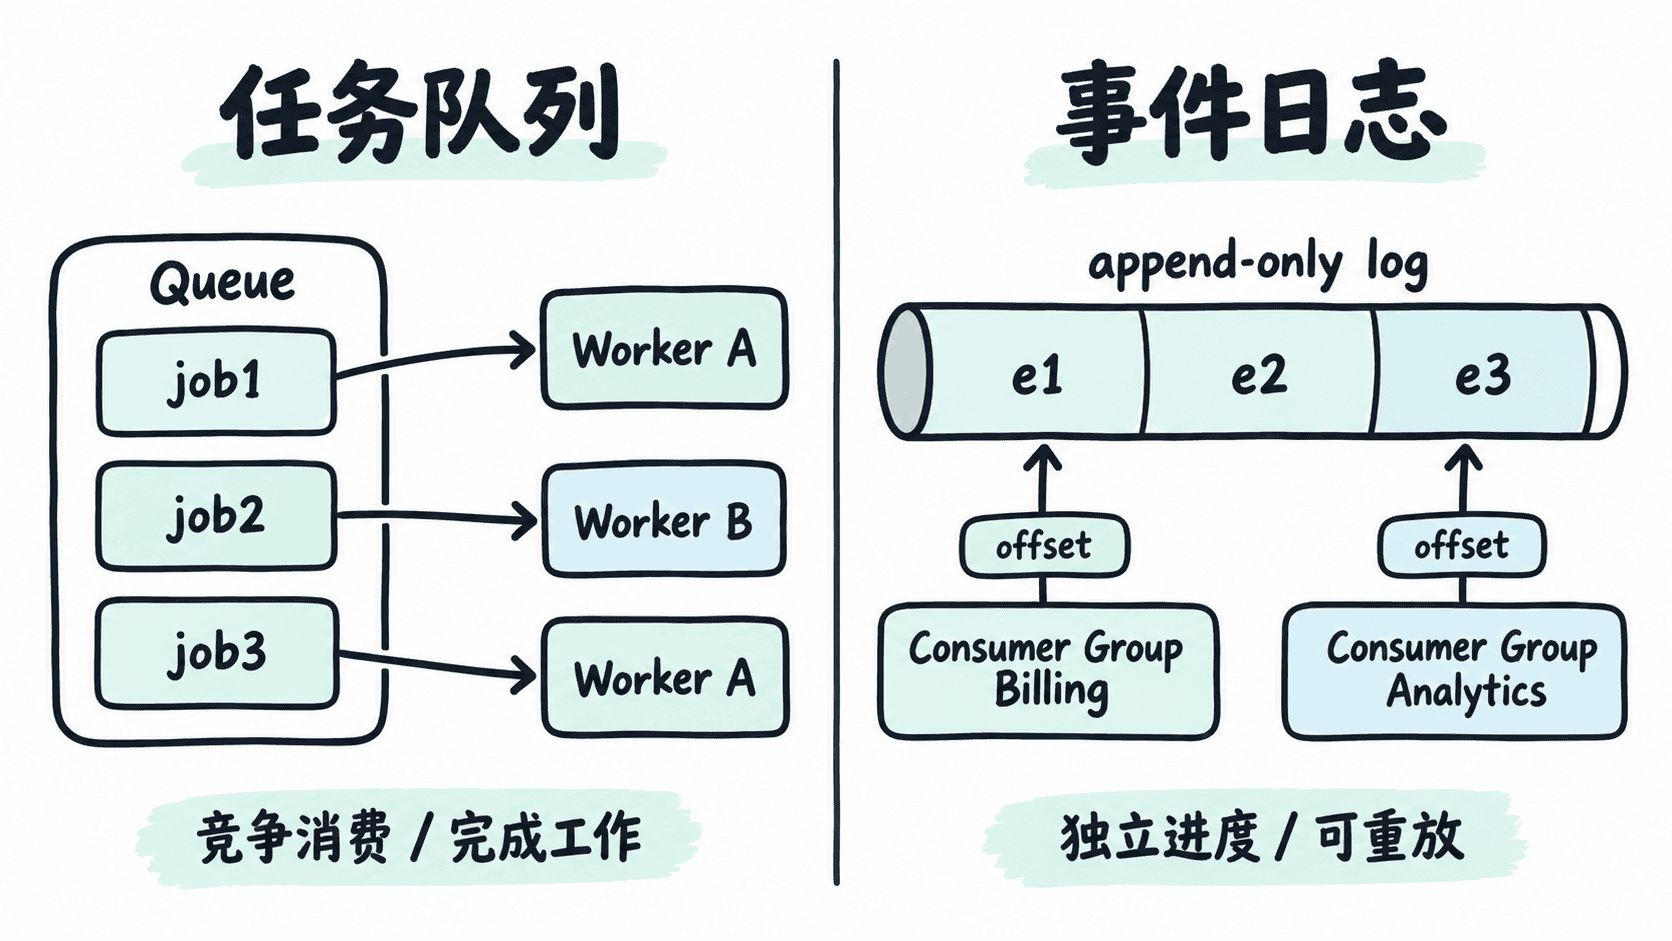
用四个问题做选择
| 判断问题 | 更偏任务队列 | 更偏事件日志 |
|---|---|---|
| 一条消息由谁处理 | 多个 worker 中一个即可 | 多个独立订阅者都可能需要 |
| 成功后还需不需要历史 | 通常不需要长期保留 | 通常需要保留一段时间 |
| 新消费者能否补读过去数据 | 通常不是主要能力 | 常见核心能力 |
| 失败恢复关注什么 | 重试、退避、死信、避免重复执行 | offset、重放、幂等、消费进度 |
如果消息表达的是“发送邮件”“生成报表”“压缩图片”这类待执行命令,并且目标是尽快由一个工作者完成,优先考虑任务队列。若消息表达的是“订单已创建”“支付已完成”这类已经发生的事实,而且未来可能被多个系统独立消费、审计或重放,优先考虑事件日志。
不要按产品名判断语义
同一个中间件可能同时提供队列式与日志式能力,真正要判断的是消费模型,而不是产品标签。即使使用日志系统,同一消费组内部也可以让多个实例竞争分区;即使使用消息队列,也可能保留一定时间的消息。
组合使用比二选一更常见
真实系统经常把两者串起来:API 收到“生成账单”命令后,把任务送入队列,由一个 worker 执行;执行成功再追加“账单已生成”事件到日志,让通知、审计和分析系统分别消费。
这种拆分让“必须被某个执行者完成的工作”和“已经发生、值得被多个系统观察的事实”拥有不同生命周期。边界清楚后,重试策略、保留策略和幂等设计也会自然落到各自合适的位置。