
架构与系统设计 / 系统课时
从排队模型估算容量上限
从排队模型估算容量上限
容量规划的难点不是算出一个“理论最大 QPS”,而是判断负载上升到什么位置后,排队会让延迟突然失控。本节用到达率、服务时间、并行工作单元和利用率建立最小模型,再用简单计算把理论上限转换成可压测、可留余量的生产容量目标。
学习目标
- 能用到达率、服务时间和并行度估算系统的理论吞吐上限。
- 能解释利用率接近 100% 时排队等待为何会非线性增长。
- 能用压测数据校准模型,而不是把公式结果直接当成生产容量。
把容量问题写成四个量
设到达率为 ,单位是请求/秒;平均服务时间为 ,单位是秒/请求;并行工作单元数量为 。在每个工作单元同质、一次只处理一个请求的简化条件下,理论吞吐上限约为 ,利用率可写成 。
例如,平均服务时间为 40 ms,一个工作单元约能处理 25 req/s;8 个工作单元的理论上限约为 200 req/s。这个 200 只表示“服务能力与到达率相等”的边界,不代表系统可以长期稳定地以 200 req/s 运行,因为任何抖动都会开始积累队列。
看懂饱和点前的延迟陡升
最简单的 M/M/1 模型给出了非常有用的直觉:当服务时间为 、利用率为 时,平均响应时间近似为 ,其中排队等待约为 。当 从 50% 提升到 90% 时,分母从 0.5 缩小到 0.1,平均响应时间相对服务时间的倍数会从 2 倍扩大到 10 倍。
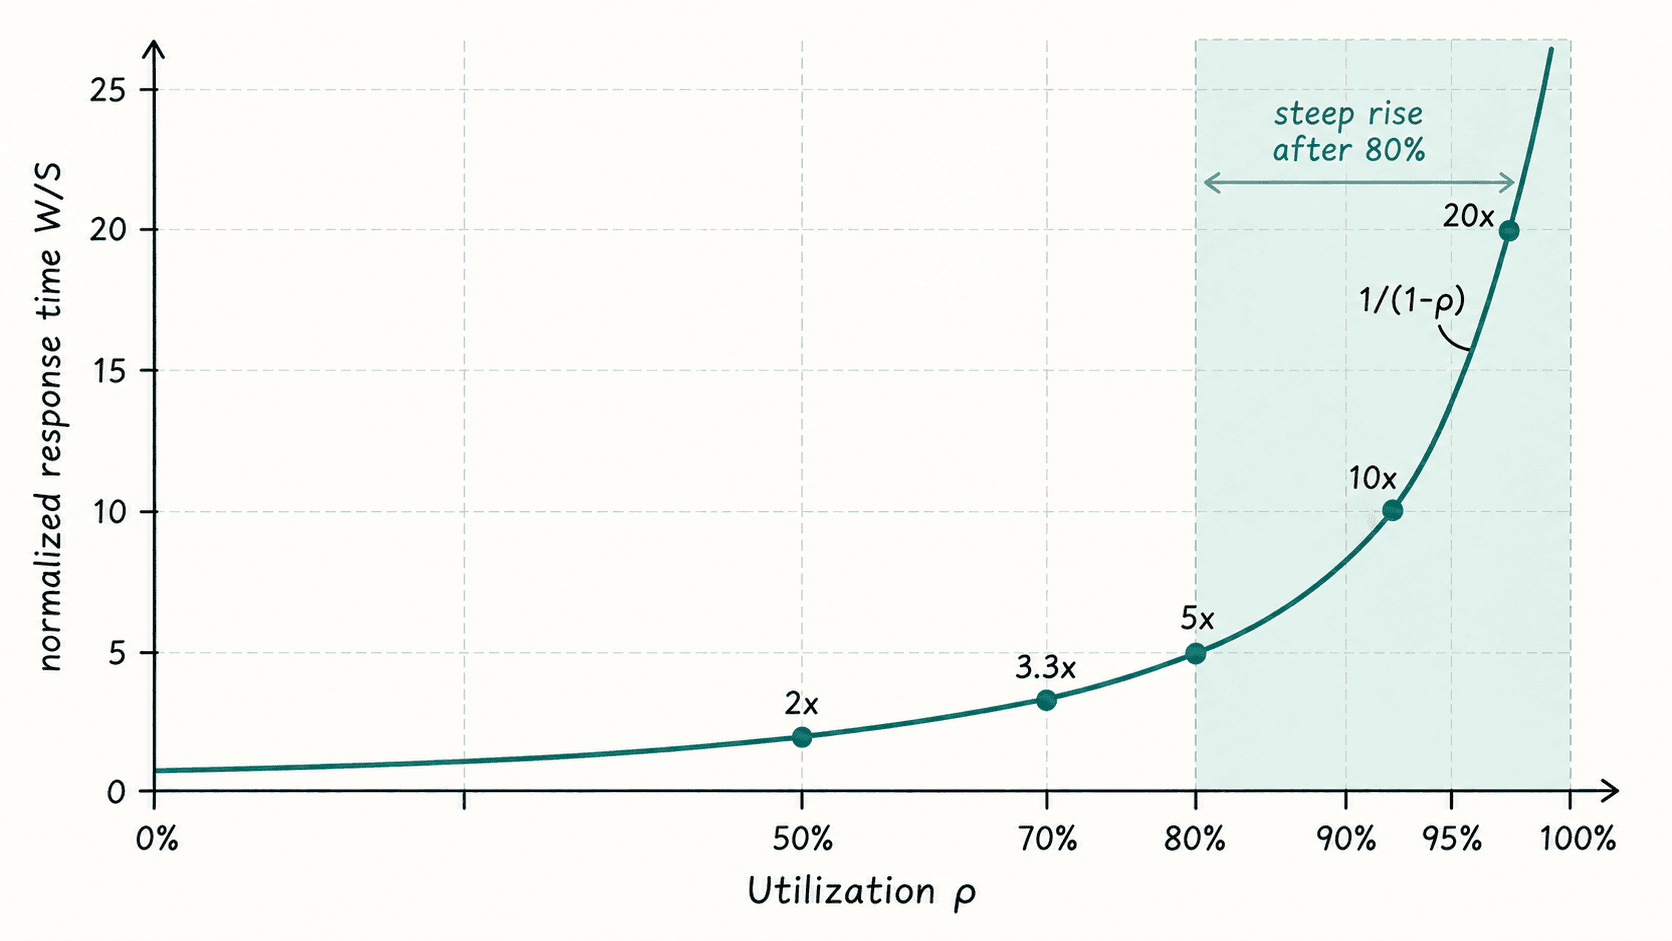
用脚本估算安全上限
下面的脚本先按服务时间和工作单元数量计算理论吞吐,再用目标利用率得到一个初始容量目标;最后列出不同负载下的利用率,并用 M/M/1 的响应时间倍数展示饱和趋势。这里的 70% 只是演示参数,实际值应由 SLO 和压测结果校准。
service_ms = 40
workers = 8

# 70% 是演示目标,实际阈值要由 SLO 与压测校准。
target_util = 0.70

# 先用平均服务时间和工作单元数估算理论吞吐。
per_worker_rps = 1000 / service_ms
theoretical_rps = workers * per_worker_rps
safe_rps = theoretical_rps * target_util

print(f"per_worker={per_worker_rps:.1f} req/s")
print(f"theoretical={theoretical_rps:.1f} req/s")
print(f"target@{target_util:.0%}={safe_rps:.1f} req/s")

# 查看几个到达率对应的资源利用率。
for arrival in (120, 140, 160, 180):
    rho = arrival / theoretical_rps
    print(f"arrival={arrival} req/s utilization={rho:.0%}")

# 用 M/M/1 倍数展示接近饱和时的非线性延迟趋势。
for rho in (0.50, 0.70, 0.80, 0.90, 0.95):
    multiplier = 1 / (1 - rho)
    print(f"rho={rho:.0%} mm1_response_multiplier={multiplier:.1f}x")
预期输出
per_worker=25.0 req/s
theoretical=200.0 req/s
target@70%=140.0 req/s
arrival=120 req/s utilization=60%
arrival=140 req/s utilization=70%
arrival=160 req/s utilization=80%
arrival=180 req/s utilization=90%
rho=50% mm1_response_multiplier=2.0x
rho=70% mm1_response_multiplier=3.3x
rho=80% mm1_response_multiplier=5.0x
rho=90% mm1_response_multiplier=10.0x
rho=95% mm1_response_multiplier=20.0x
这个结果把两个概念分开了:200 req/s 是按平均服务时间算出的理论吞吐边界,140 req/s 是在示例目标利用率下得到的初始容量值。后者仍不是最终生产结论,因为服务时间本身会随缓存命中、GC、下游拥塞和批量大小变化。
用压测把模型校准到生产
容量评审时应把公式当作起点,再用阶梯压测寻找真正的“拐点”。逐级提高到达率,记录吞吐、并发数、队列长度、CPU 或工作线程利用率,以及 P50、P95、P99 延迟;当吞吐增长开始变慢而队列和尾延迟持续上升时,系统已经接近有效容量上限。
还要用 Little 定律 做一致性检查:如果稳定阶段每秒完成 120 个请求,平均响应时间为 0.2 秒,那么系统中平均约有 24 个请求处于处理或等待状态。若观测并发与这个数量相差很大,应检查统计口径、重试、超时或隐藏队列。
生产容量最终应同时满足吞吐和延迟 SLO,并为突发流量、实例故障和下游抖动保留余量。理论上限回答“最多可能处理多少”,压测拐点回答“从哪里开始不稳定”,而架构评审真正需要的是后者再向下留出的可持续运行区间。